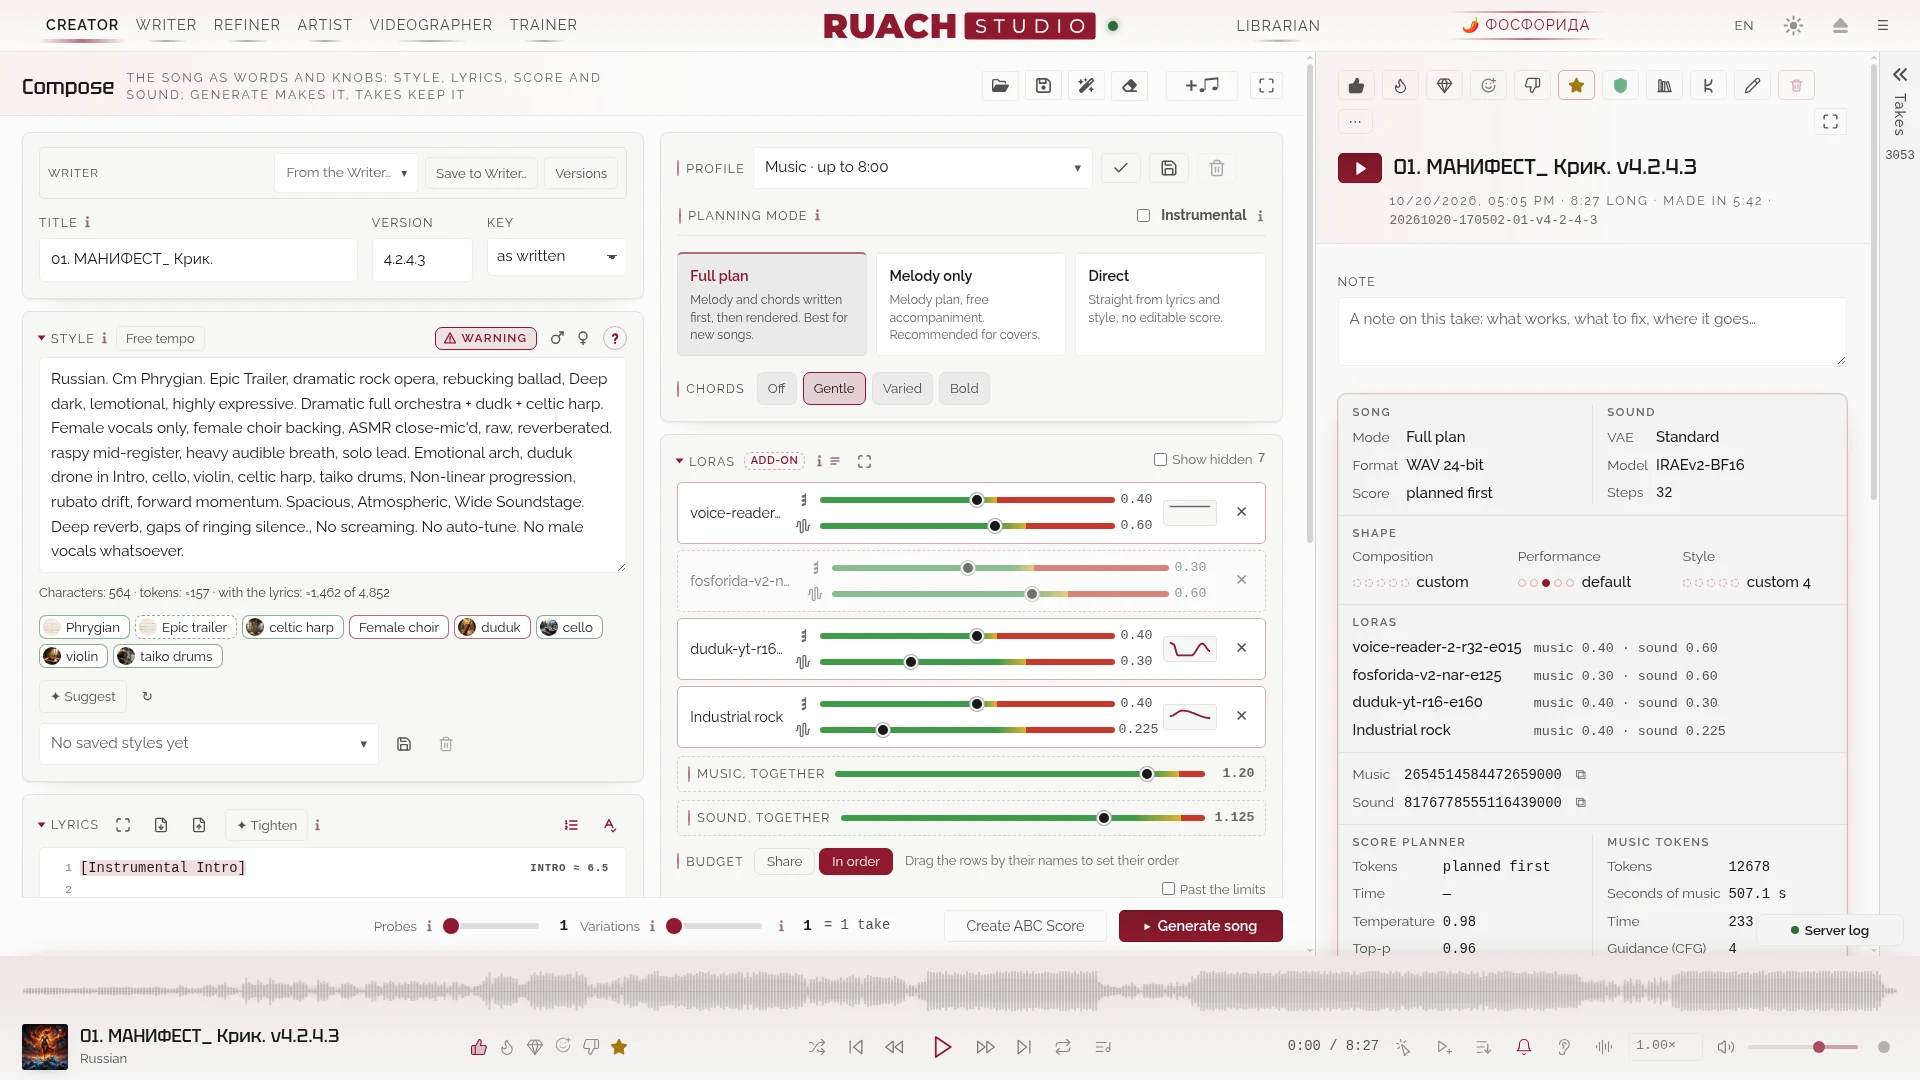
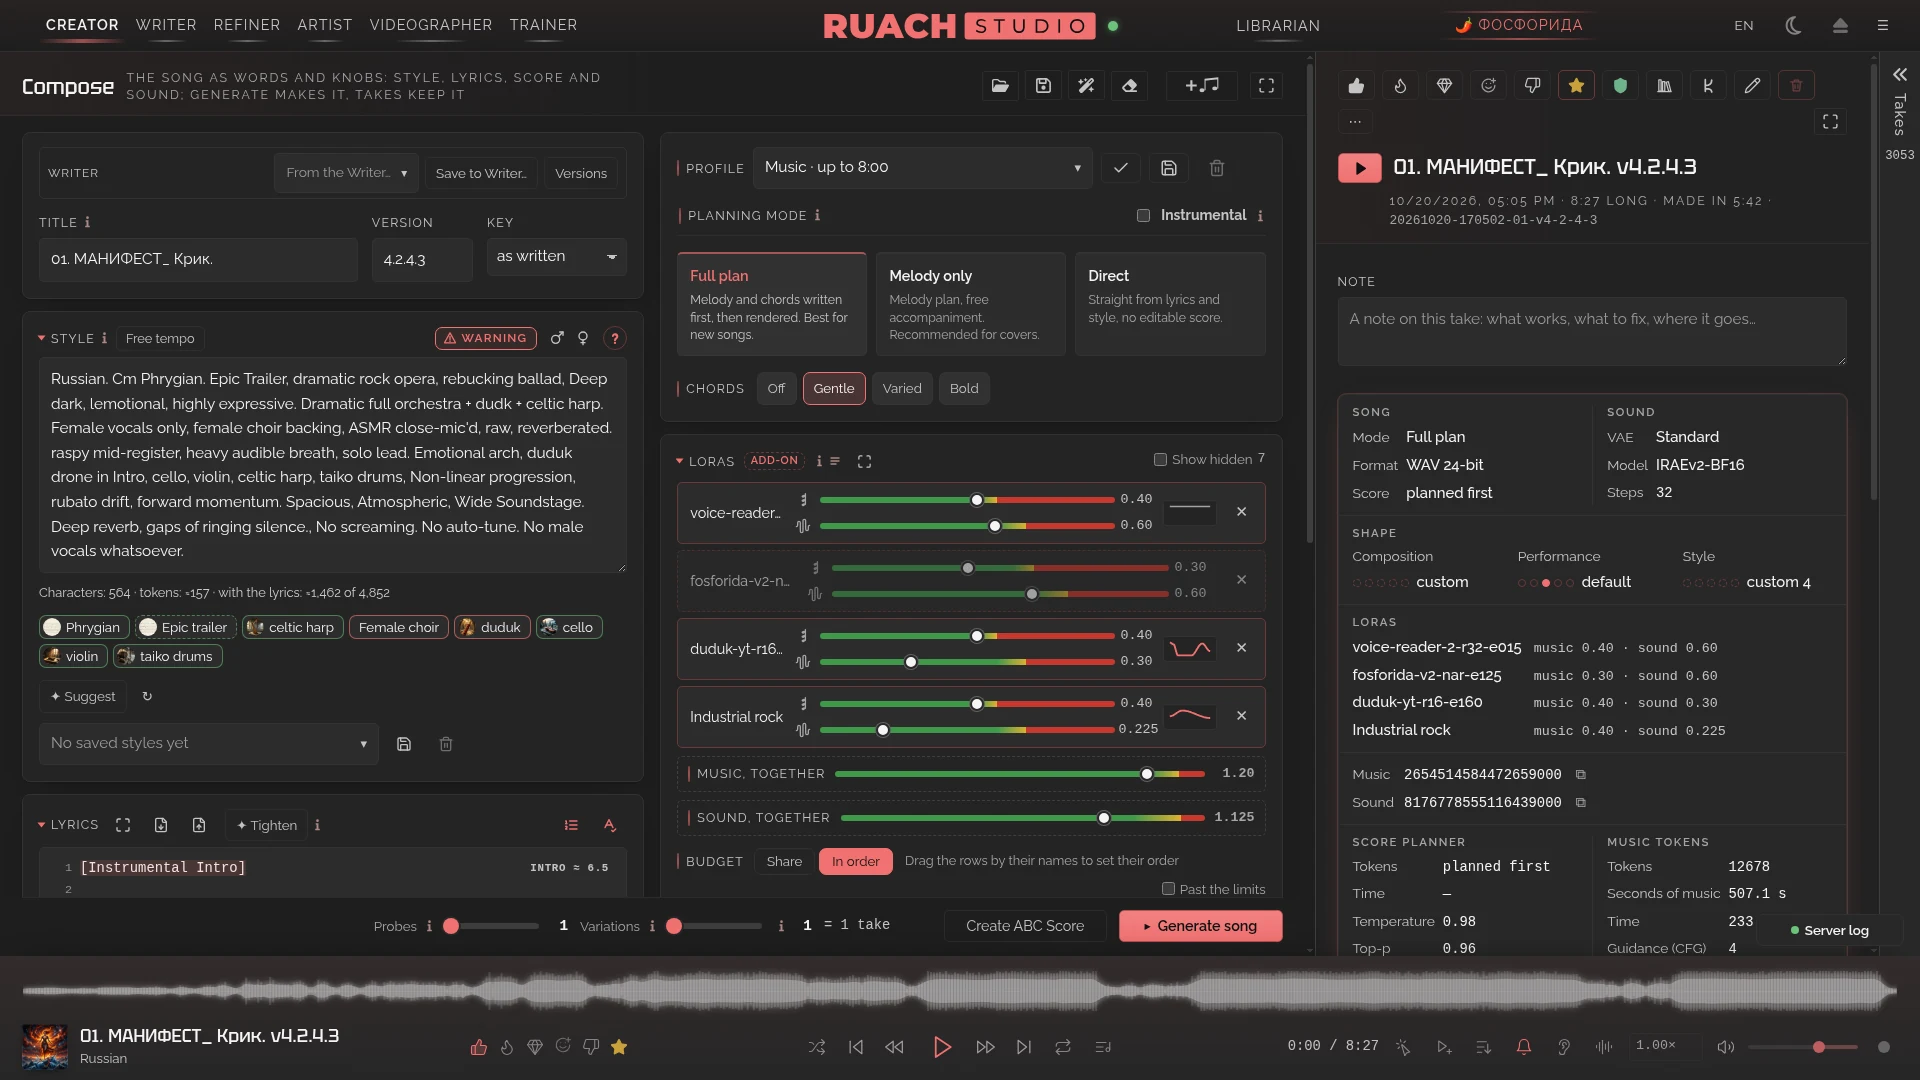
Creador
Estilo, letra, modo de planificación, decodificador, LoRAs en un camino del verde al rojo; la toma con su partitura, sus semillas y todo lo necesario para hacerla de nuevo.
Todo un Estudio alrededor de YuE2, el modelo abierto de canciones. Escribe el estilo y la letra, y el Estudio compone, canta y renderiza la canción en tu propia GPU. Tus canciones, palabras y ajustes nunca salen de ella.
2.0.5 · cada pico entero, el árbol genealógico y el Estudio por https · noviembre de 2026
Ruach Studio es generación de música abierta que corre en tu propio hardware: el modelo, la partitura, los adaptadores y cada toma siguen siendo tuyos, y nada se alquila por token. Los modelos abiertos ya son lo bastante buenos para sostenerse solos, y lo que faltaba era el Estudio a su alrededor: eso es lo que construimos, en abierto.
La música debe ser libre de hacer y de compartir: quien no tiene voz, ni instrumento, ni Estudio tiene igualmente el derecho de poner en sonido sus pensamientos y sus sentimientos.
El Creador hace la canción, el Escritor la escribe con un modelo de chat, el Pulidor la termina, el Artista pinta sus imágenes, el Videógrafo planifica su videoclip, el Bibliotecario guarda cada toma y el Entrenador LoRA enseña a YuE2 tus propias canciones. Dentro del Estudio hay una guía para cada sala.
Estilo, letra, modo de planificación, decodificador, LoRAs en un camino del verde al rojo; la toma con su partitura, sus semillas y todo lo necesario para hacerla de nuevo.
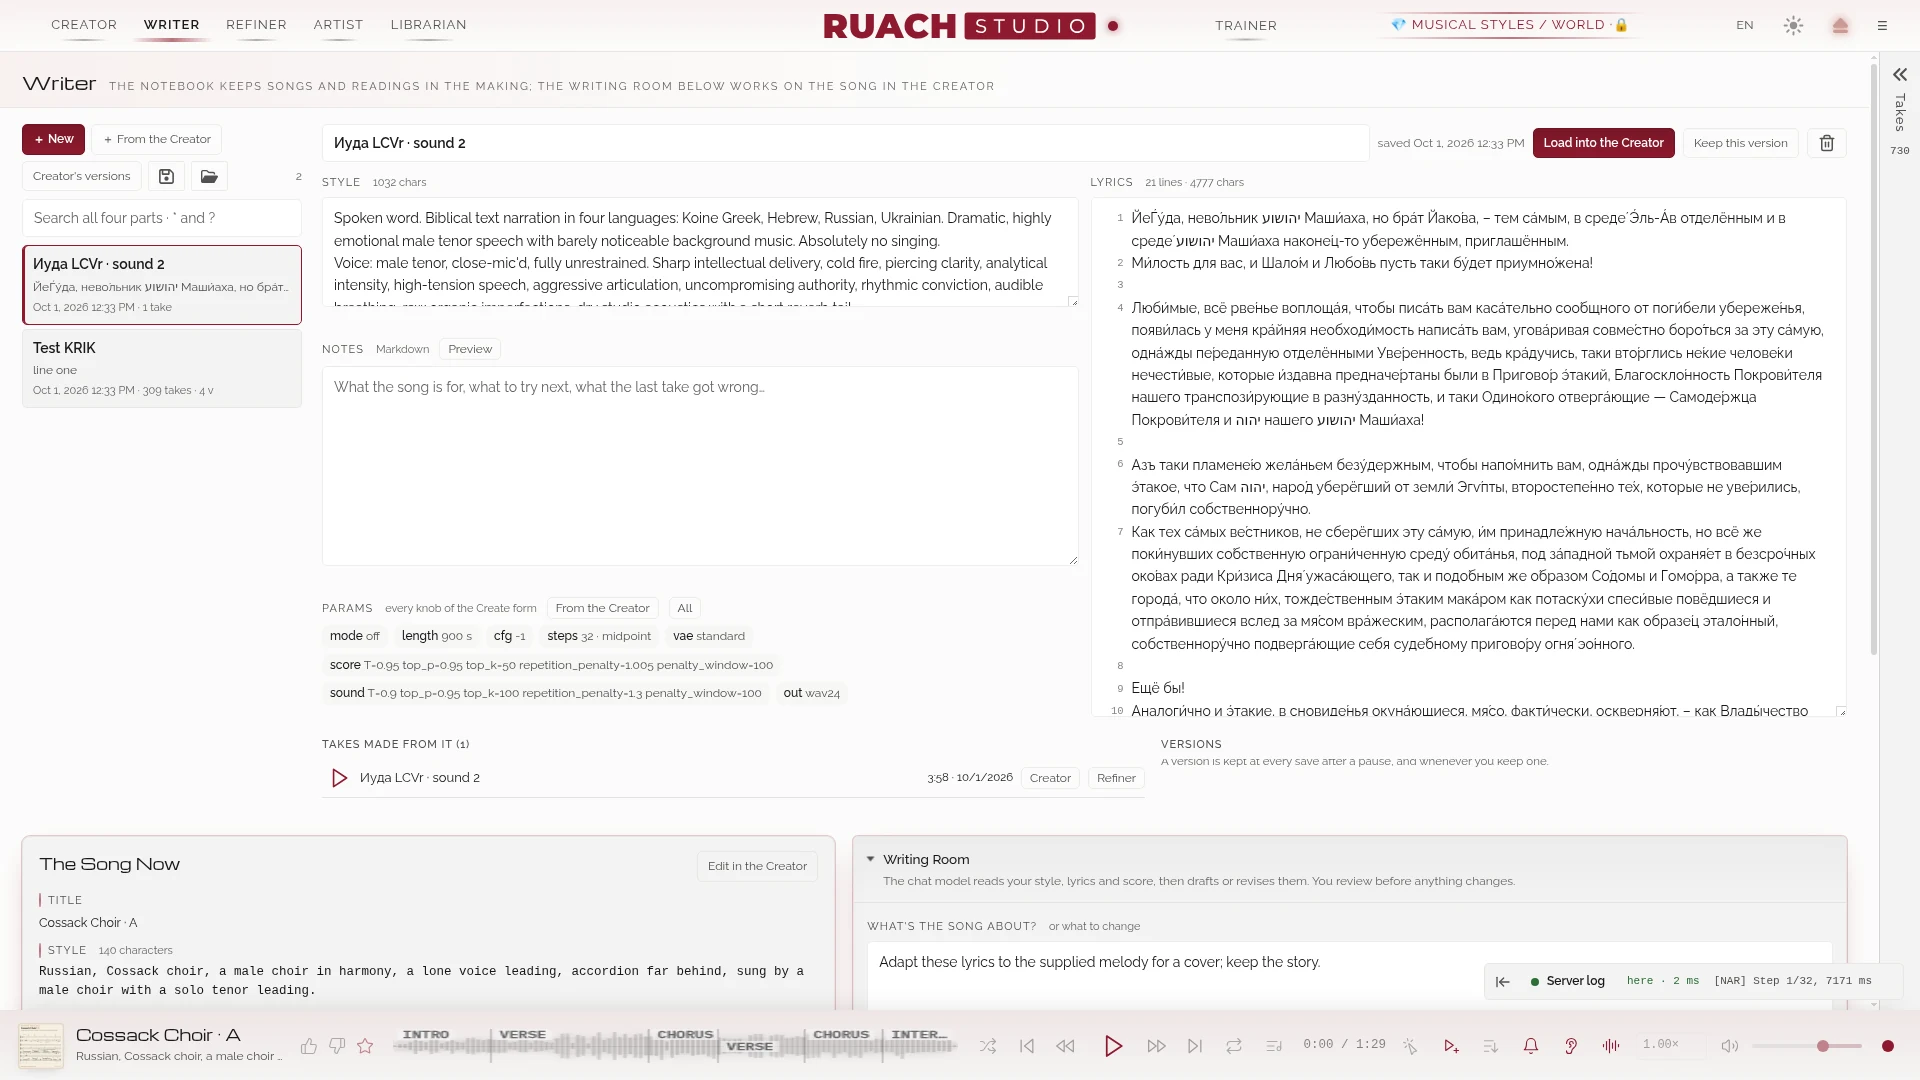
Canciones como documentos con versiones, perfiles de texto y un modelo de chat propio (u OpenRouter) que hace borradores y revisa contigo.
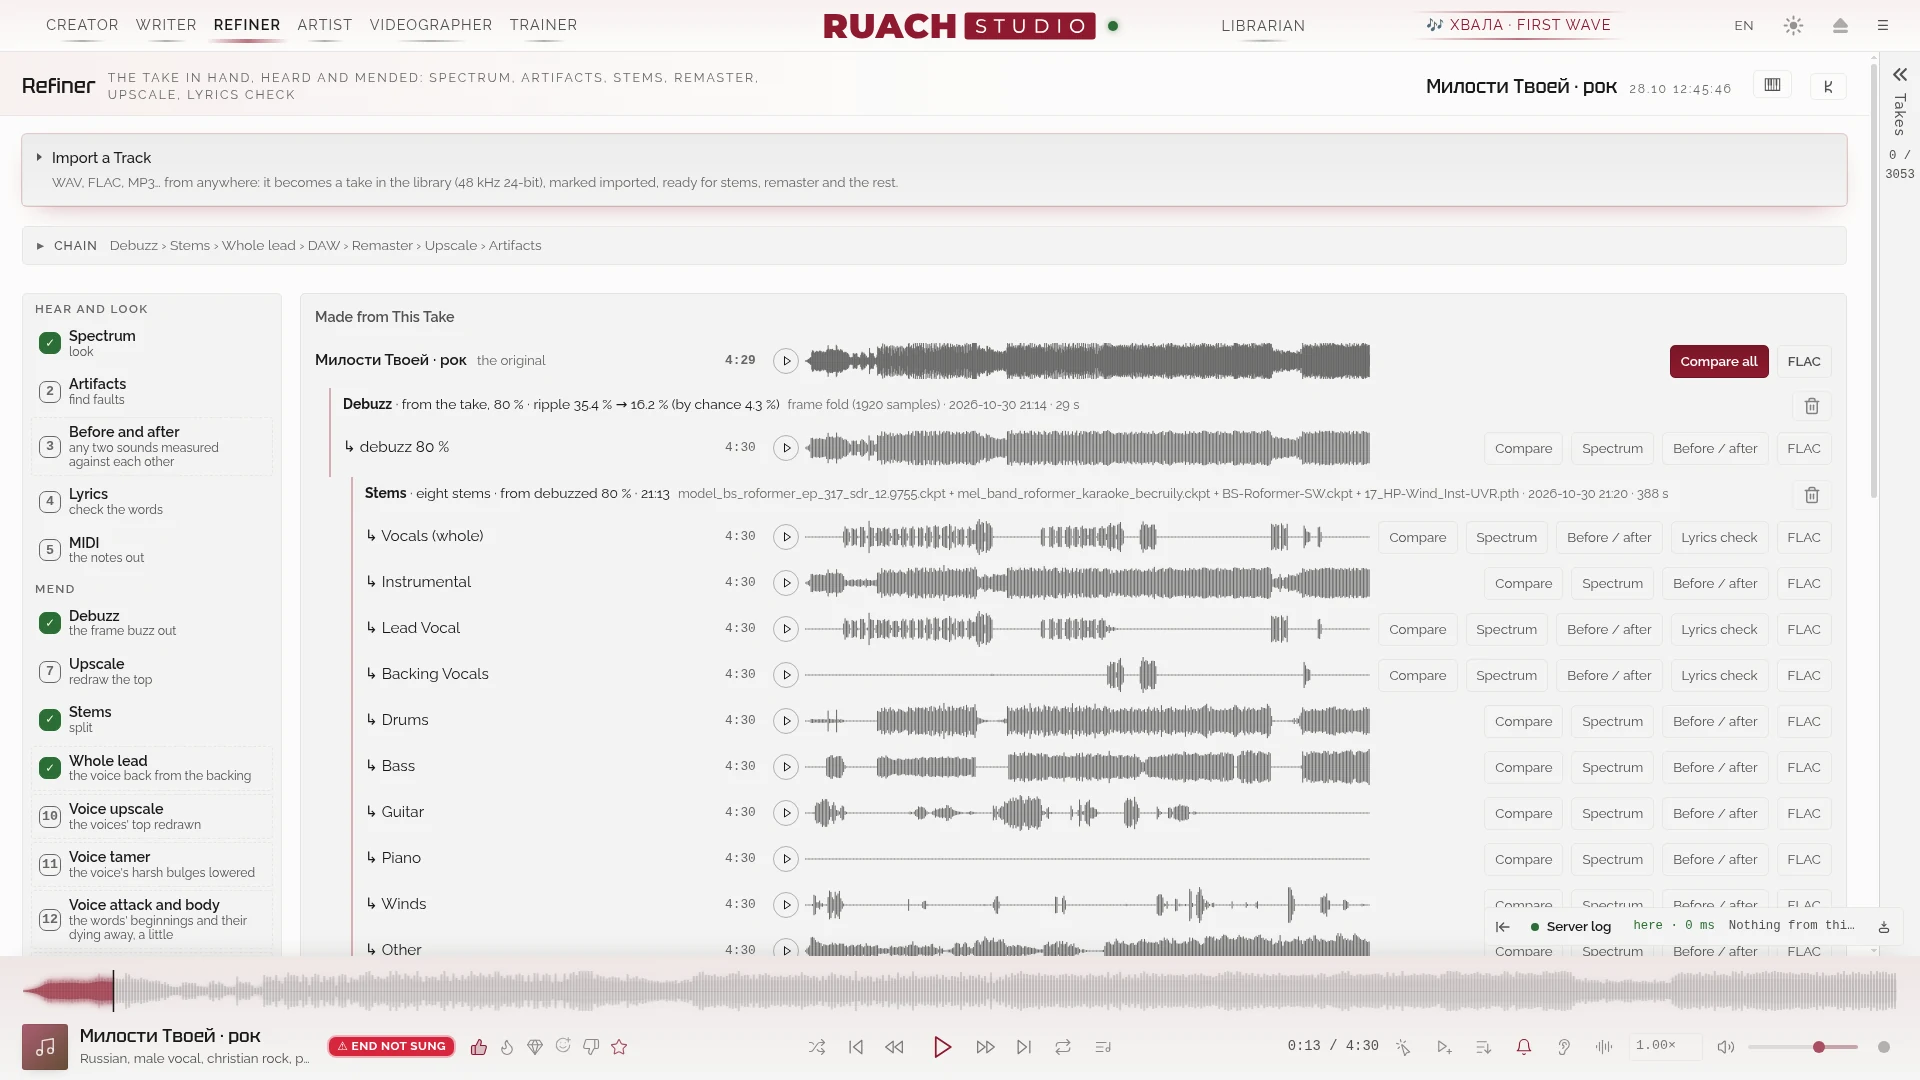
Espectro, artefactos, antizumbido, una revisión de la letra con Whisper, stems, remasterización, reescalado; una cadena los ejecuta todos.
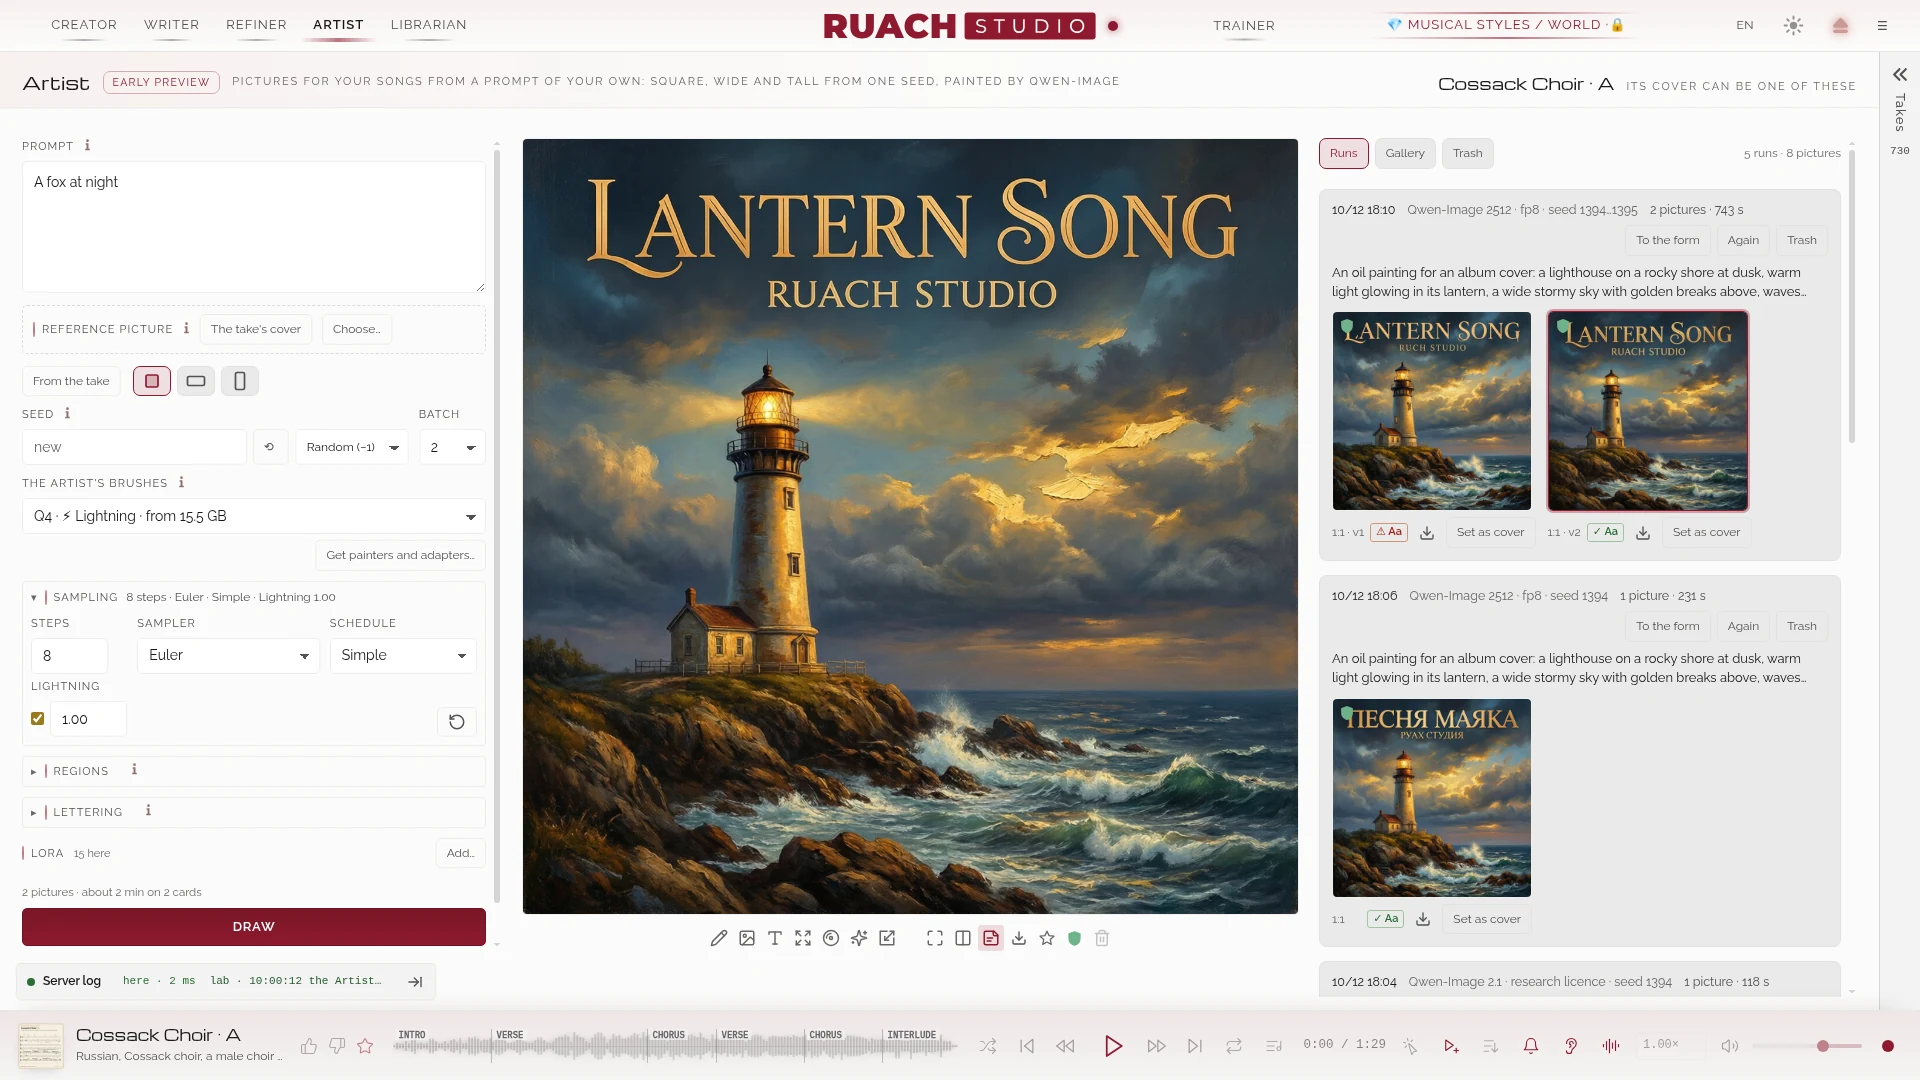
Imágenes para tus canciones desde un prompt propio: cuadrada, ancha y alta desde una semilla, pintadas por Qwen-Image 2512; la imagen se revela ante tus ojos y una cuadrada se vuelve la portada de la toma. Un adelanto.
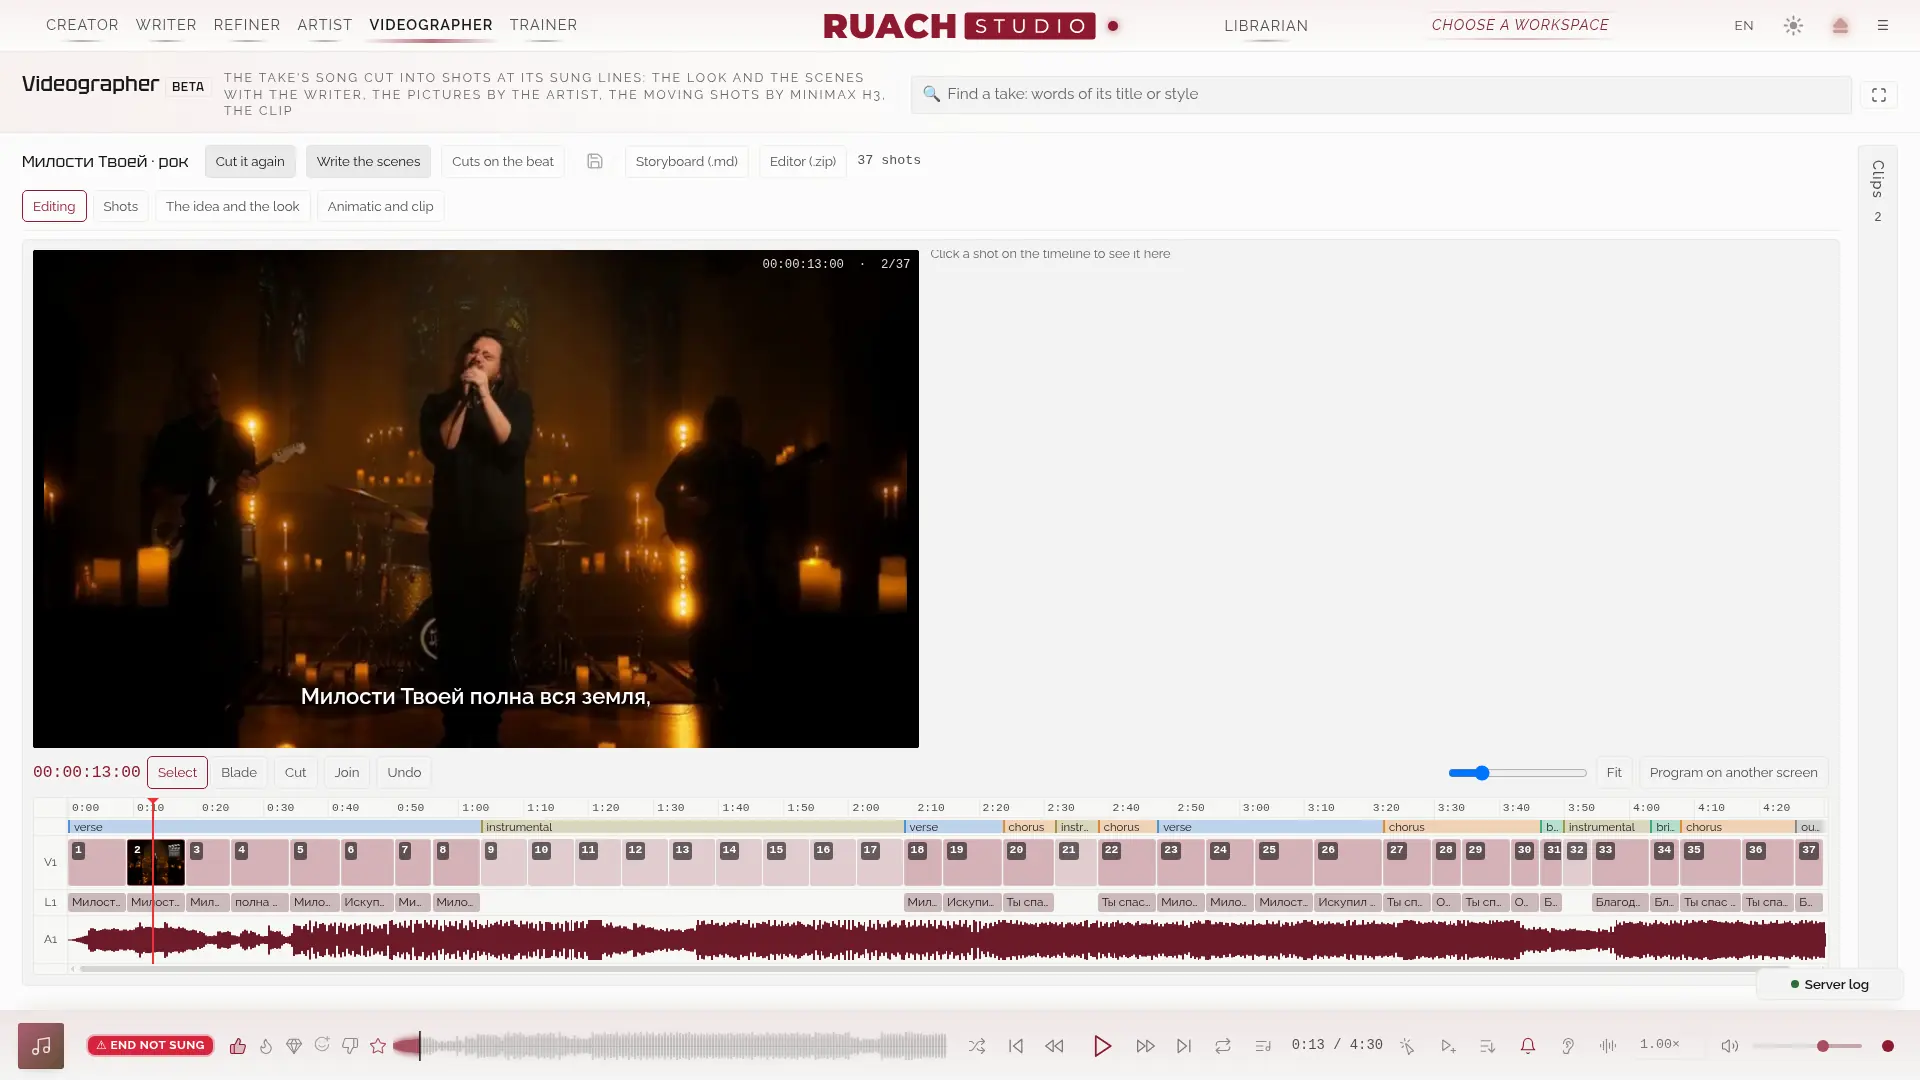
Un videoclip para la toma: su canción cortada en planos en los versos cantados, las escenas escritas con el Escritor, los fotogramas clave pintados por el Artista, los planos en movimiento por MiniMax H3; una línea de tiempo para montar, un aspecto (LUT 3D, grano), un animatic y el clip. Beta.
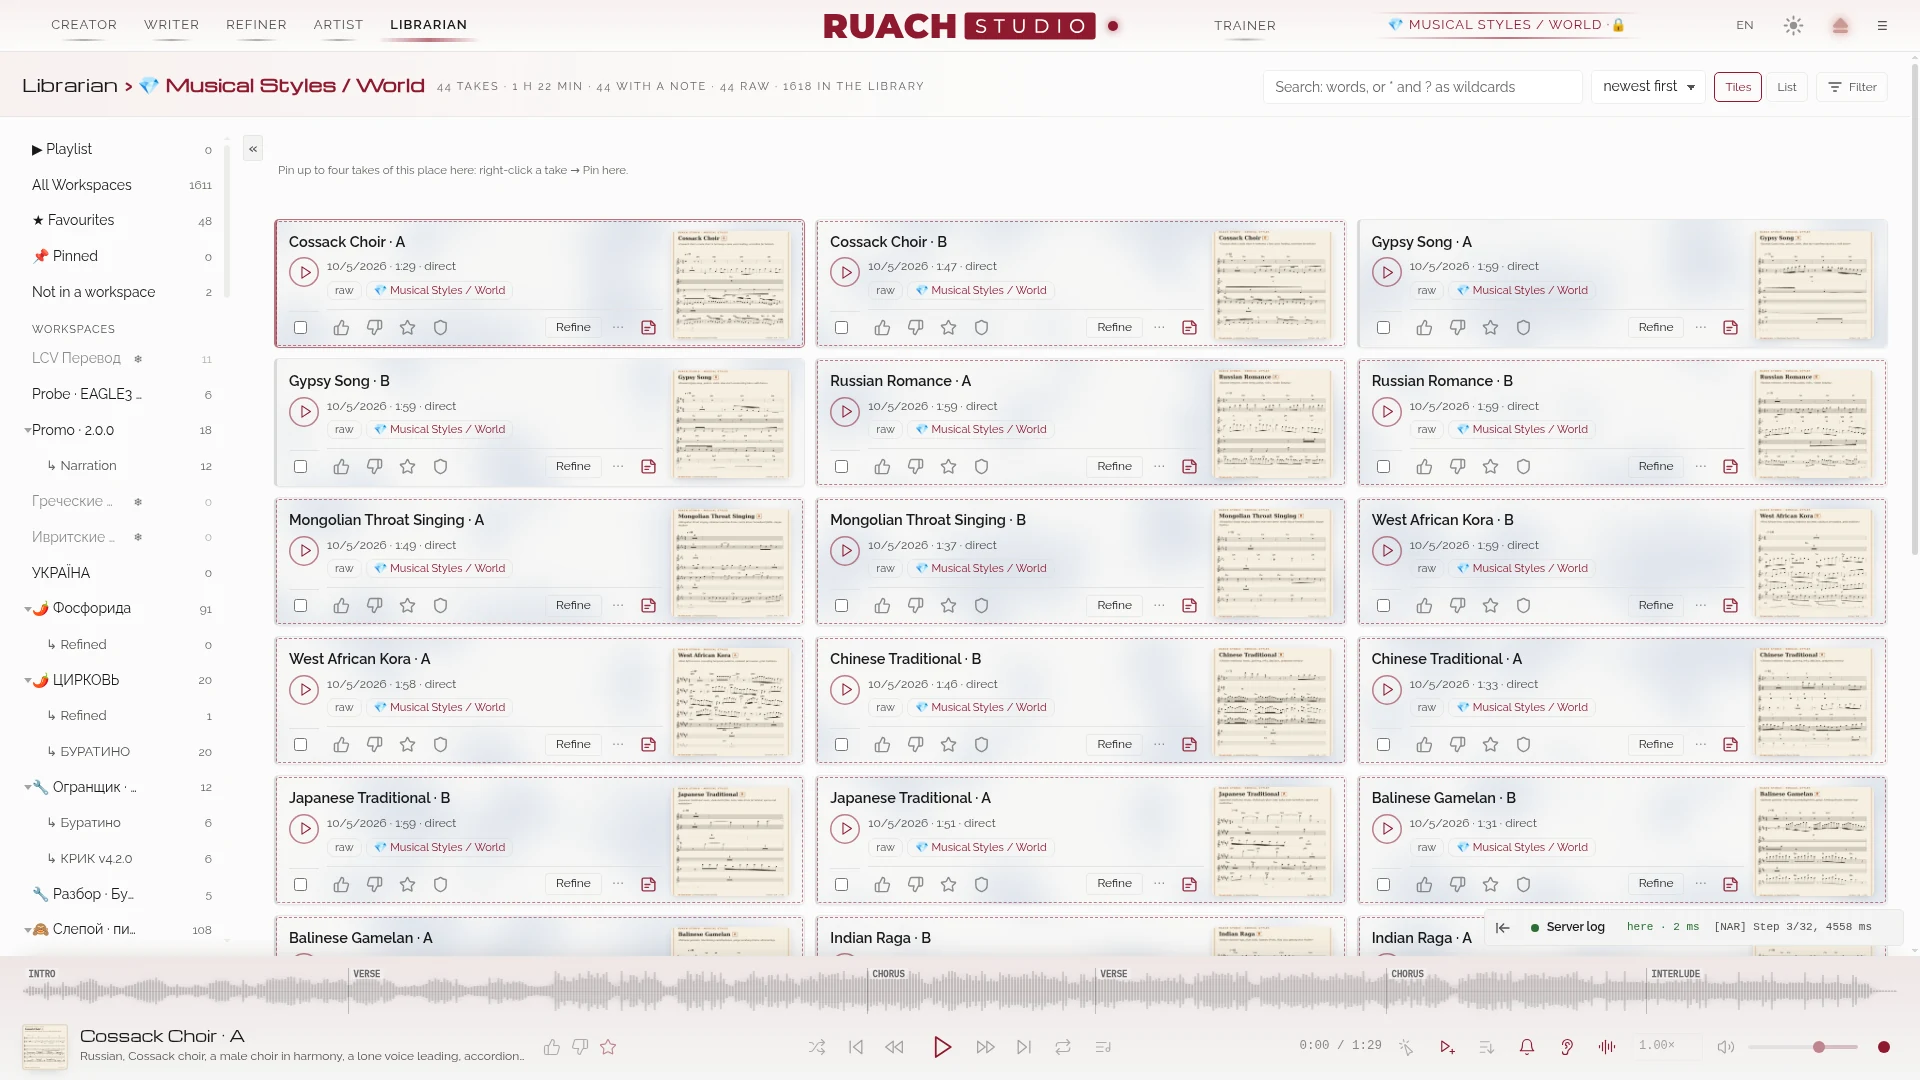
Cada toma en espacios: buscada, valorada, anotada, bloqueada, con portada, enviada a tu DAW; una papelera que devuelve.
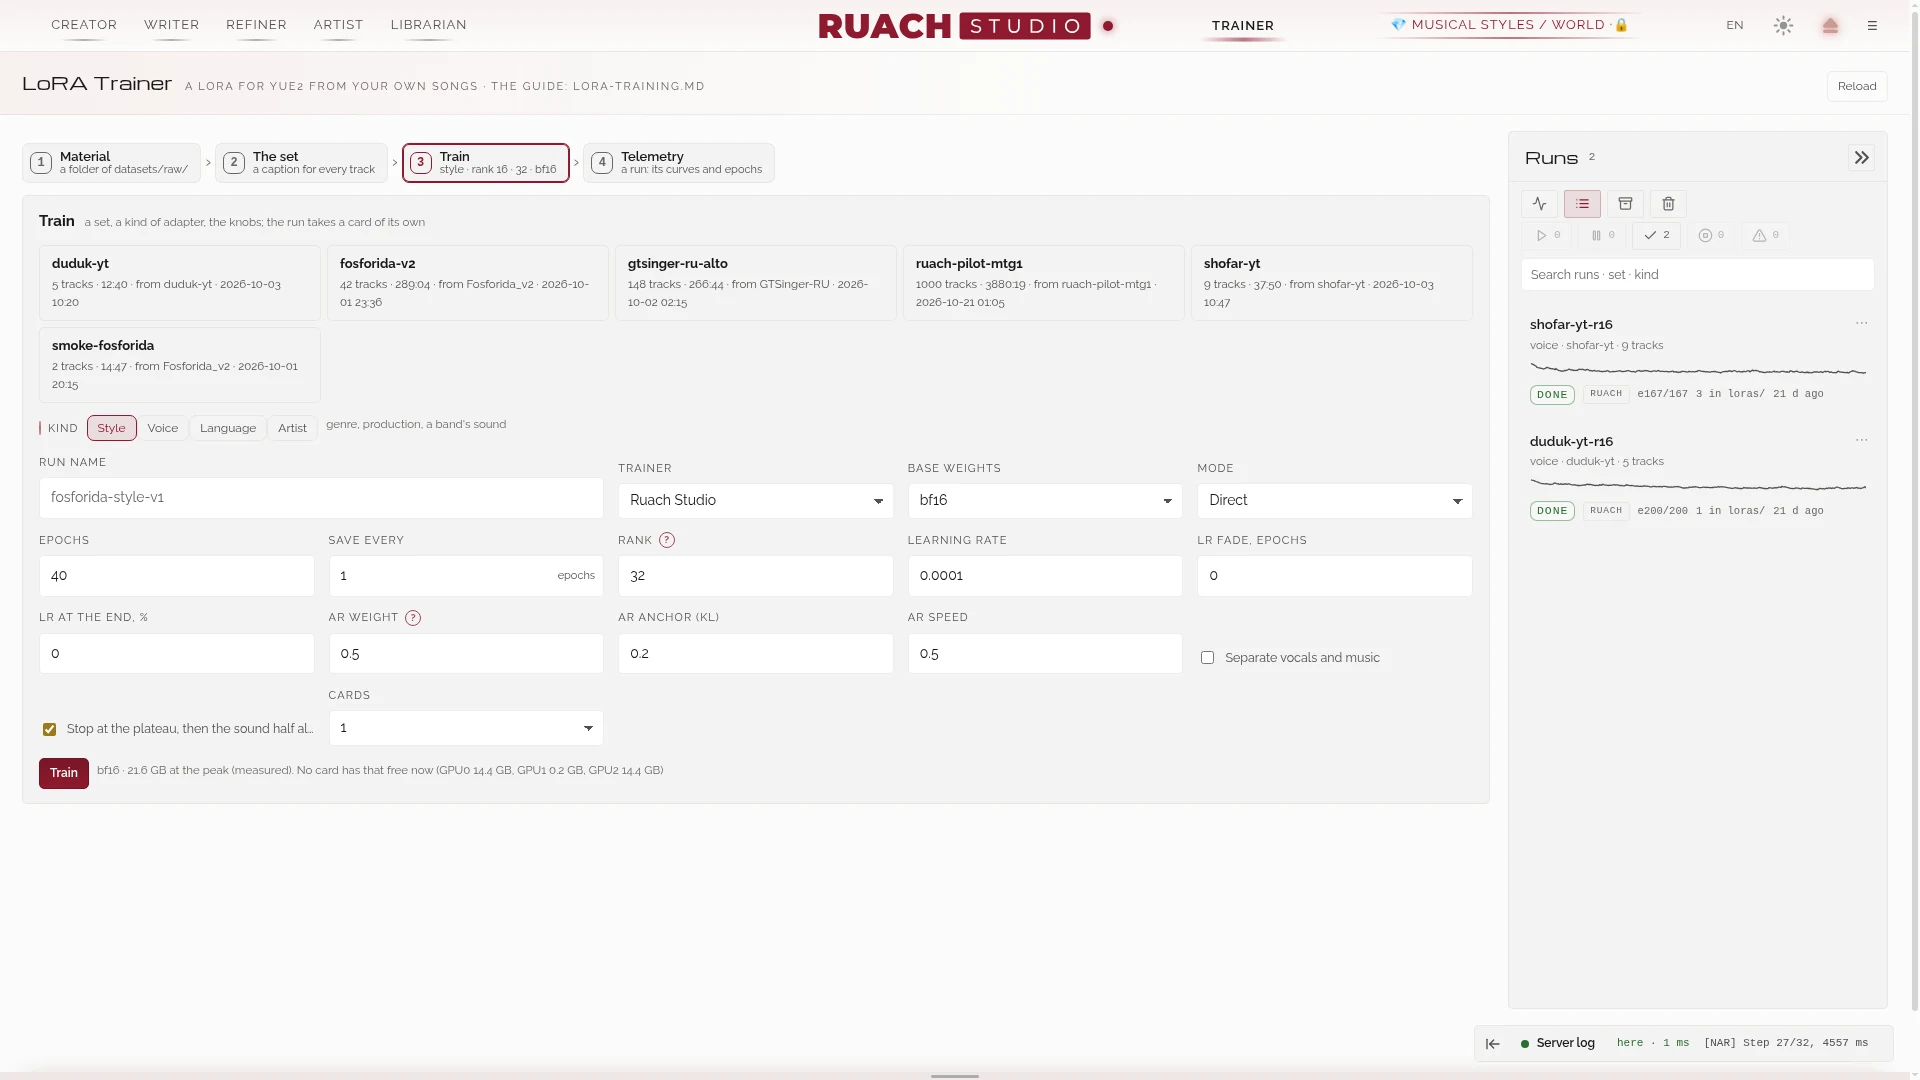
Adaptadores a partir de tus propias canciones: el conjunto, el entrenamiento, las curvas de ambas mitades explicadas, las épocas que conviene escuchar primero.
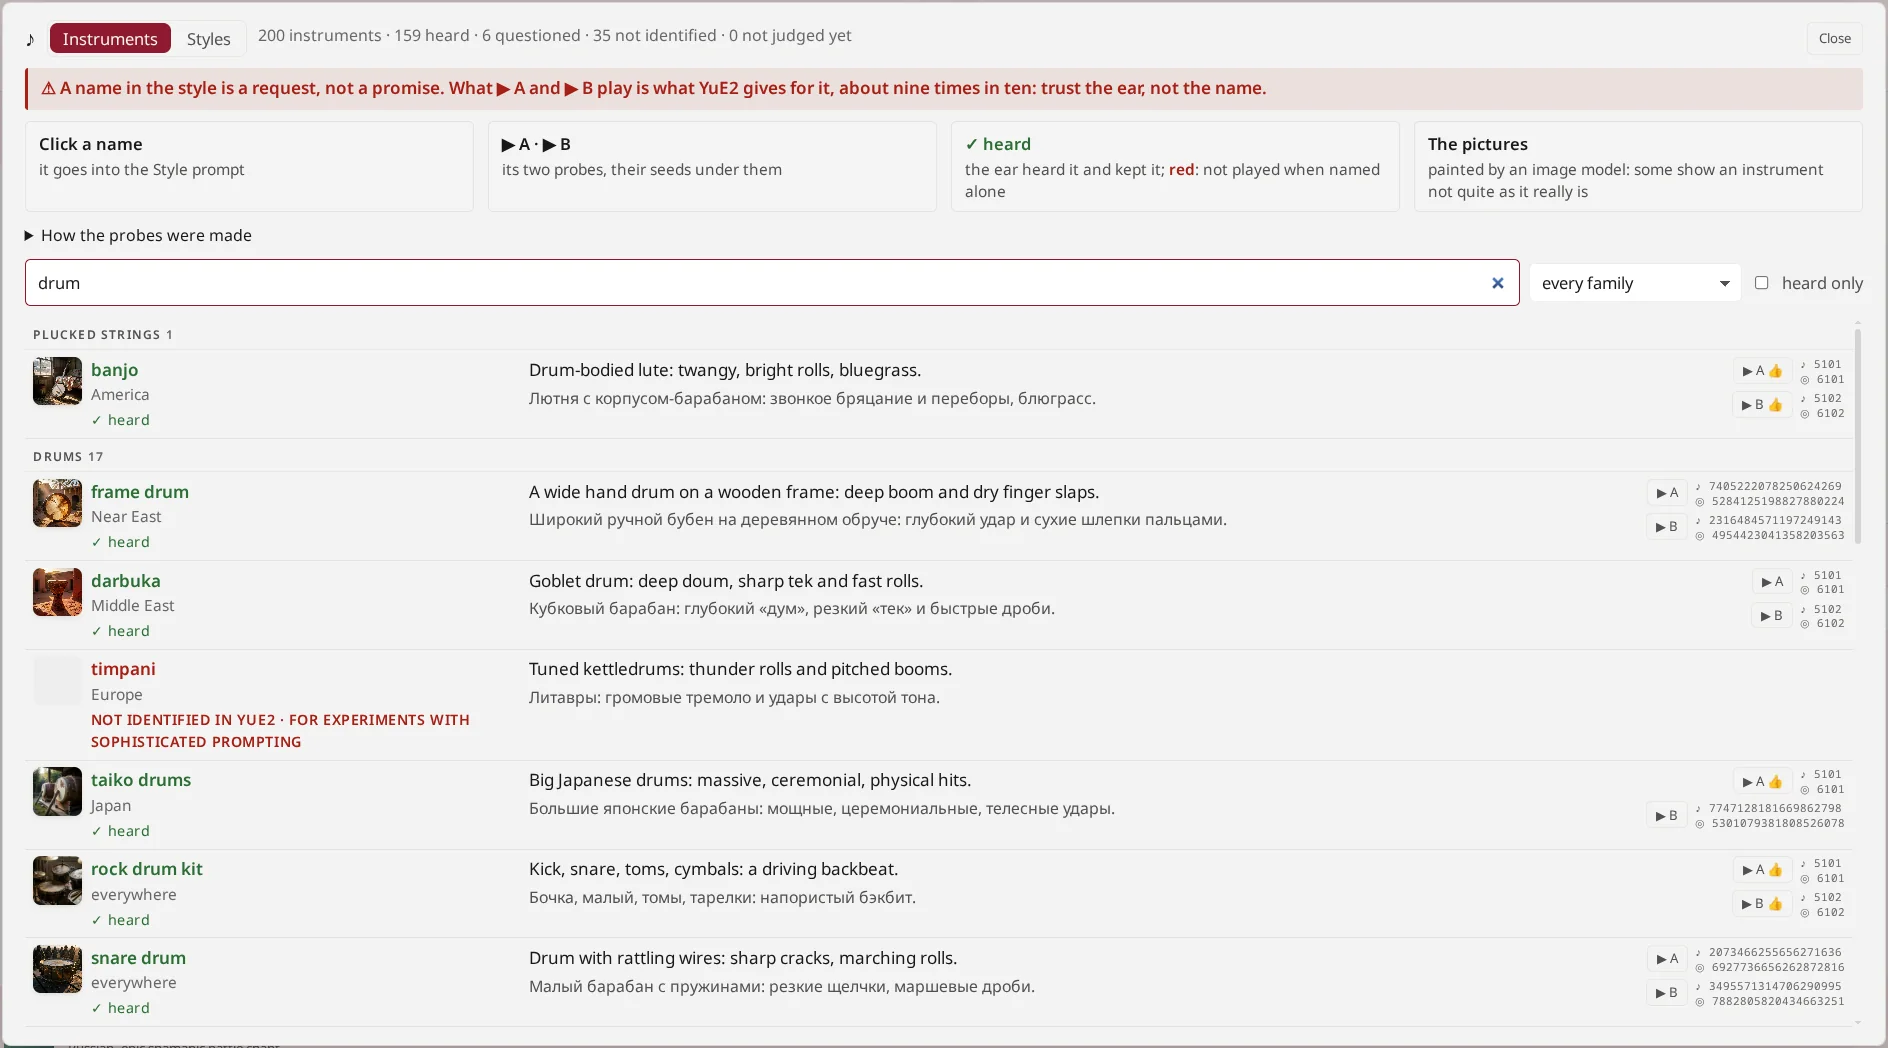
200 instrumentos probados y juzgados de oído: lo que YuE2 toca de verdad, lo que toca débil y lo que no conoce.
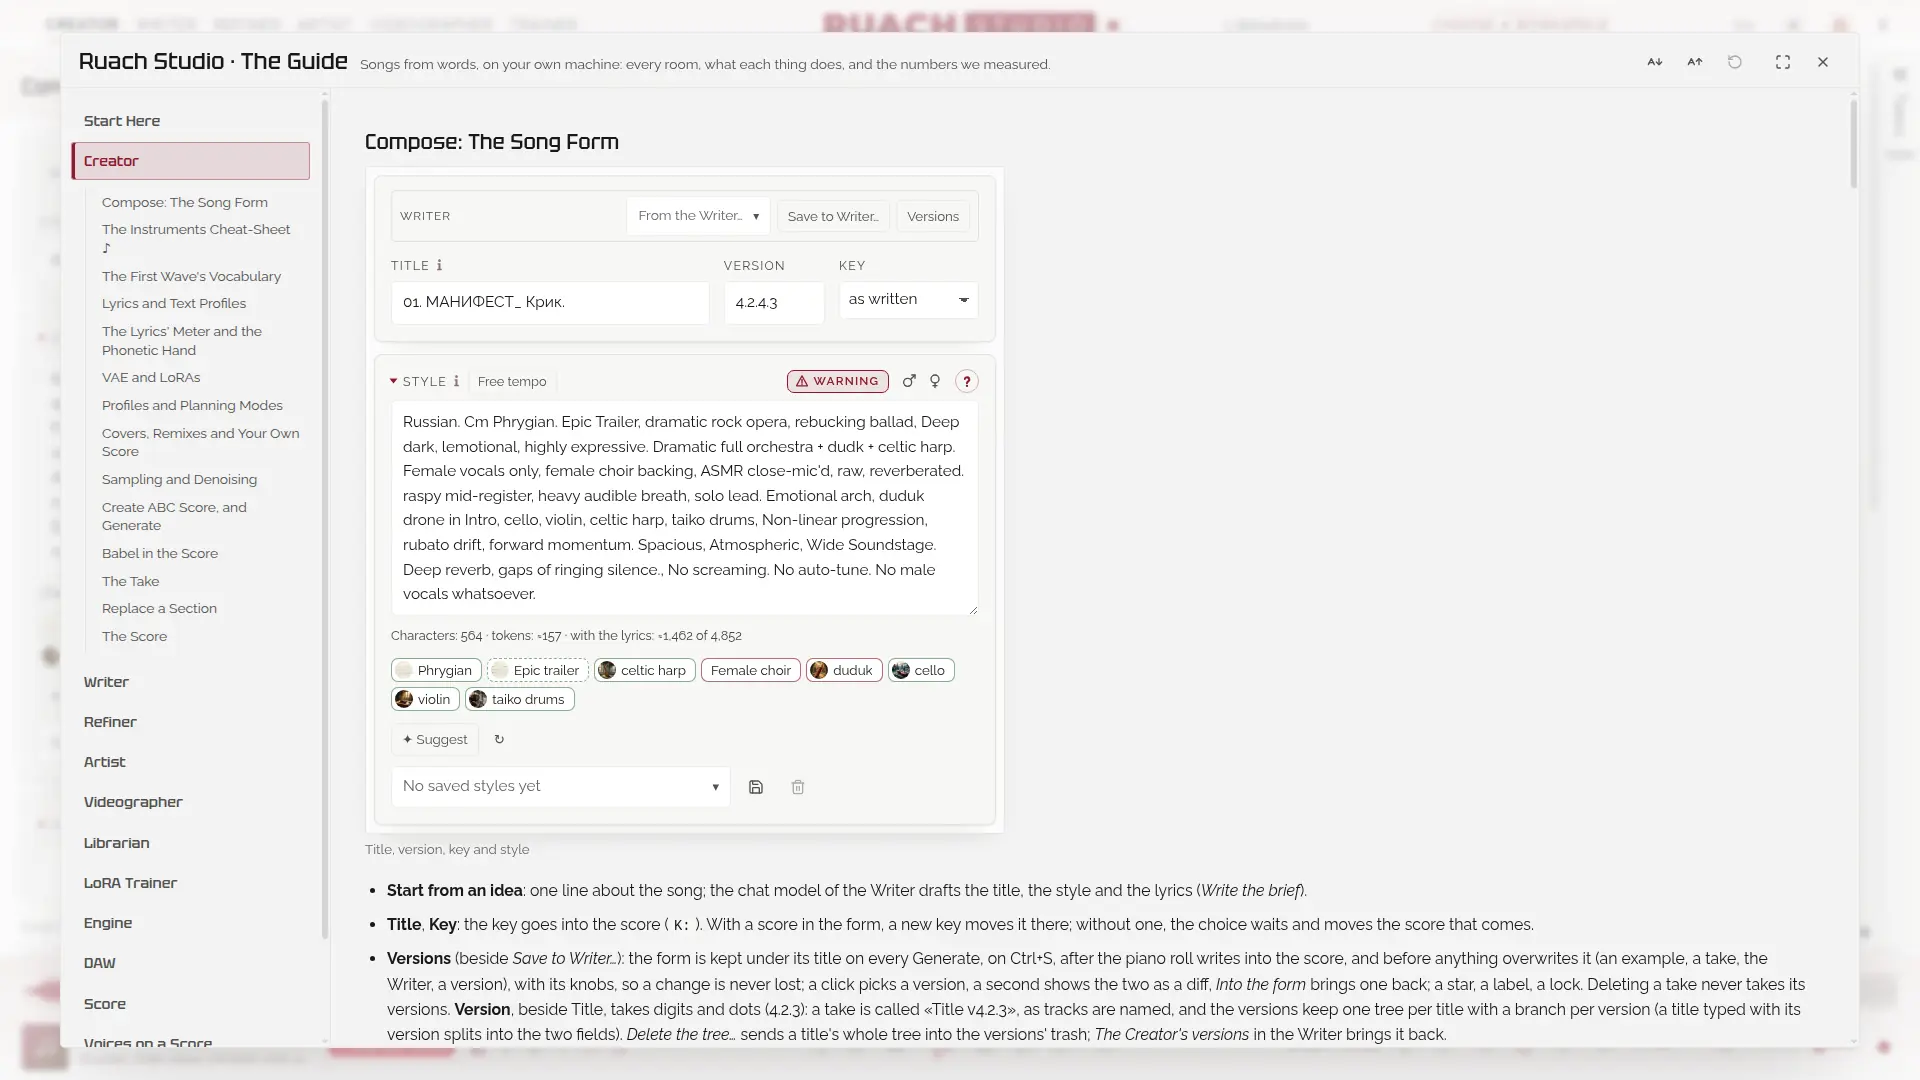
Todo el Estudio explicado dentro del Estudio, a una tecla: cada sala y cada mando, qué hace y las cifras que medimos, en doce idiomas. Hecho para el gusto de crear, no para horas de búsqueda en internet.
No es otro envoltorio de un modelo: es una estación de trabajo alrededor del modelo, abierta hasta el hueso, con cada cambio numerado y documentado.
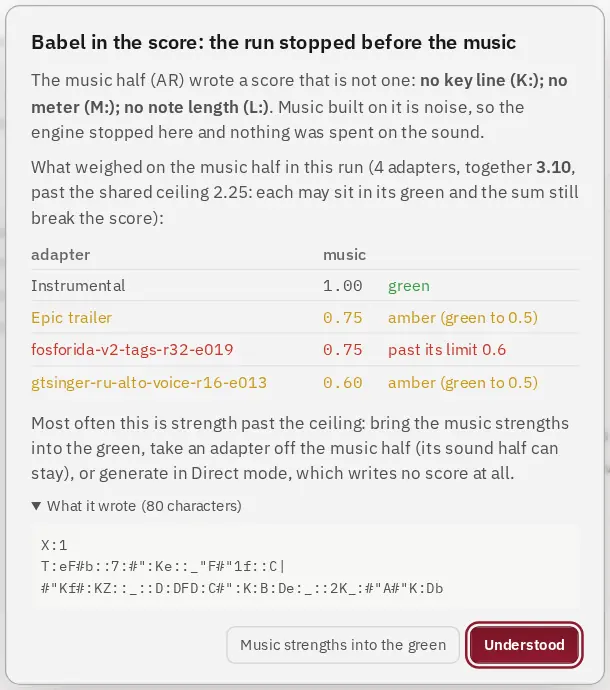
Cuando la mitad musical escribe una partitura rota (los adaptadores llevados demasiado lejos lo hacen), el motor detiene la ejecución antes de que se construya música sobre ella, en segundos, y dice por qué: qué adaptadores, cuánto se pasaron de sus límites, qué se escribió.
Las intensidades se mueven por caminos medidos; los adaptadores apilados comparten un techo medido.
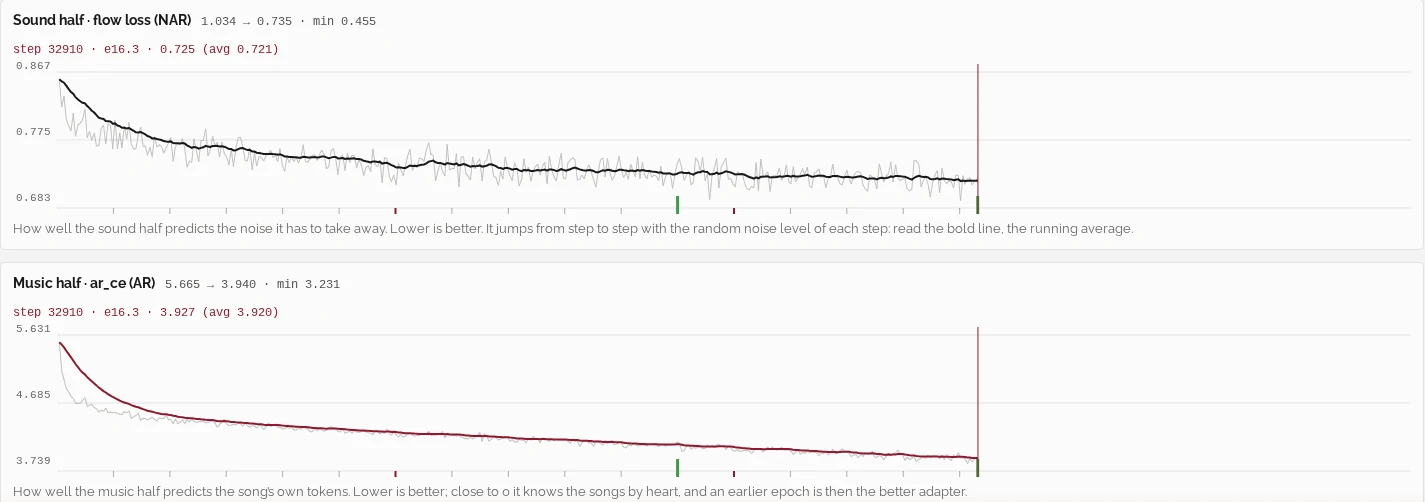
El Estudio entrena adaptadores por sí mismo, con pesos bf16 sin cuantizar. Frente a AI-Toolkit de Ostris con el mismo conjunto, la pérdida de la mitad musical coincide época a época con un margen de 0.015.
Rango 16 con 148 canciones: 2.1 s por paso en 12 GB. Rango 32 con 42 canciones enteras: 6.7 s por paso en 18 GB.
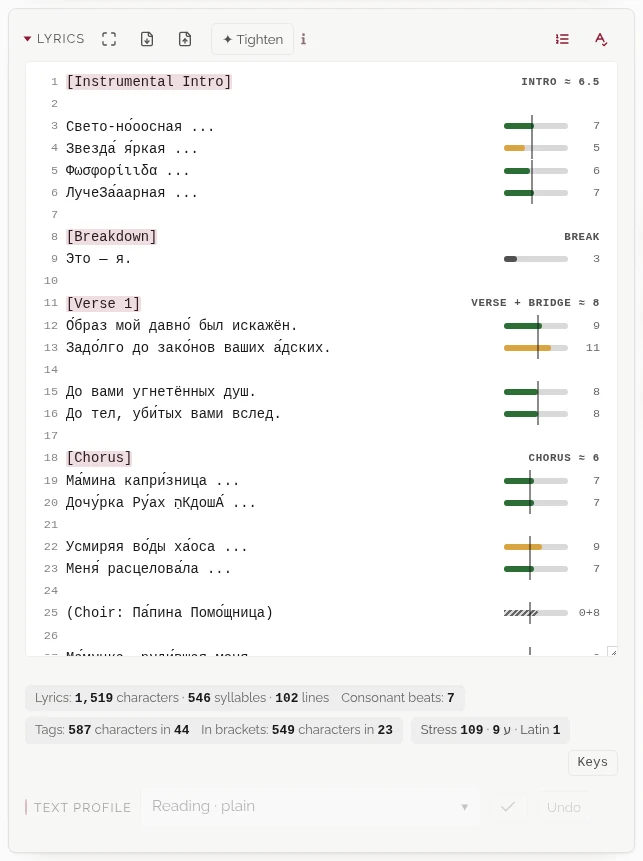
Junto a cada línea, sus tiempos frente a la regla de su sección: estrofa y puente un grupo, el pre-estribillo y el estribillo los suyos. Cada sílaba se cuenta con las reglas de su idioma, y las consonantes que toman un tiempo propio también cuentan; una pausa o un interludio dentro de una sección no abre grupo nuevo.
Escribe «[» al principio de una línea y se te sugieren las etiquetas de sección, como un editor de código sugiere palabras. Los acentos fuera de sitio se encuentran; Ctrl+F busca solo en ese cuadro.
Cada semana un vídeo dice que algún modelo mata a SUNO. Esto no es un modelo: es un Estudio entero alrededor de uno, con un fine-tune propio. Dónde gana y dónde gana todavía SUNO, dicho claro.
| Ruaj Estudio (YuE2) | SUNO | |
|---|---|---|
| dónde se ejecuta | tu GPU; tus canciones, letras y ajustes nunca salen de ella, y ya instalado no necesita internet | en su nube |
| cuánto cuesta | la electricidad: sin créditos, sin planes, sin límites diarios | una suscripción y créditos |
| el modelo | YuE2 y nuestro propio fine-tune, RS-FW, el primero grande y abierto: ambas mitades entrenadas de nuevo con 32.633 pistas, unas 1.800 horas, y publicada cada palabra que se les dijo | cerrado; con qué aprendió no se publica |
| la partitura | escrita primero, visible, editable, tuya (ABC, MIDI); un piano roll a toda la ventana | oculta |
| la letra | un contador junto a cada línea: sus tiempos frente a la regla de su sección, las sílabas con las reglas de cada idioma; las etiquetas de sección sugeridas al escribir «[» | un cuadro de texto; la letra te la escriben si la pides |
| repetir una toma | exactamente: dos semillas que guardas | no |
| guía (CFG) | dos, por separado: el tirón del estilo y el agarre de la letra, cada uno con su CFG | una perilla Style Influence |
| reemplazar una sección | sus palabras cantadas de nuevo entre las pausas que halla el oído, el resto de la toma intacto hasta la muestra: la costura no se oye; varias secciones de una vez | Replace Section: en nuestras pruebas casi nunca sirve, se oyen las costuras y la voz cambia |
| la familia de una toma | un árbol genealógico: cada recorte, versión y regeneración de la que vino una toma y lo que salió de ella, cada una con su onda | — |
| la biblioteca | espacios de trabajo con secciones, dieciséis reacciones, notas, protección y una papelera que devuelve, una búsqueda con comodines y «no», conjuntos a ciegas para escuchar con honestidad, una hoja y un pasaporte para cada toma | espacios de trabajo, likes y listas |
| comparar tomas | hasta doce versiones en un reproductor desde el mismo segundo, con nombre o a ciegas, a igual volumen, alineadas por su propio sonido | — |
| tu propio sonido | entrena una LoRA con tus canciones, en el Estudio | sin entrenamiento; las Personas reutilizan la voz y el estilo de una canción |
| lo que YuE2 no puede tocar | una orquesta MIDI sobre la propia partitura de la toma (sets SFZ, y Pianoteq si lo tienes) y naturaleza bajo la canción: fuego, lluvia, ríos, pájaros | — |
| tus propios instrumentos | El Constructor de bancos convierte las grabaciones de un instrumento (un duduk, un shofar) en un banco SFZ: voces, gritos y otros instrumentos quedan fuera al oído, las notas se encuentran tecla a tecla, afinadas y en bucle; en el DAW suena bajo la canción como fondo, como bordón en su tonalidad o como una línea MIDI | — |
| cada pico entero | ningún recorte a la salida: las largas colas de reverberación y el silencio quedan enteros; el árbol genealógico muestra dónde habría mordido el viejo recorte | entregado ya masterizado (en nuestro ring: −15,5 LUFS, −3,4 dBTP) |
| después del render | stems, debuzz, remaster, upscale, revisión de la letra y un máster a un volumen objetivo (Spotify −14, Apple Music −16, un CD −9), todo local | stems y un remaster, en la nube |
| un mezclador | un DAW en el Pulidor: pistas con EQ, puerta, compresor, anchura y envíos, automatización, marcadores, el sonido de una pista guardado como preset | Suno Studio, en el navegador, en su plan más alto |
| ver el sonido | el espectrograma de toda la toma sobre el reproductor, a tiempo con su onda: las secciones, el brillo y la sonoridad, el espectro y la nota bajo el puntero | una forma de onda |
| imágenes y vídeo | el Artista pinta la portada, el 16:9 y el 9:16 a partir de tus palabras; el Videógrafo planea el videoclip, pinta sus fotogramas clave y le da un aspecto (LUT 3D, grano, viñeta) | una imagen de portada |
| a un DAW | un proyecto de REAPER con la partitura, las secciones y la letra (experimental) | stems de audio |
| scripts y agentes | una API (OpenAPI 3.1) y un servidor MCP, en tu máquina y tu red | sin API pública |
| procedencia | Content Credentials (C2PA) firmadas en cada descarga, a tu nombre, si quieres | — |
| el código | abierto (AGPL), cada cambio numerado y documentado | cerrado |
| la interfaz | siete salas en una página, en doce idiomas; una pista en cada control y una guía en cada sala; el reproductor y las tomas en cada sala; teclas para lo que haces a menudo; se instala como aplicación | una aplicación web y aplicaciones móviles |
| pulido de fábrica | menos: una mezcla puede zumbar (el antizumbido ayuda), la letra puede desviarse (la revisión de la letra encuentra dónde), algunos instrumentos YuE2 los toca débiles o no los toca (una LoRA se los enseña) | más |
| qué necesitas | una GPU NVIDIA (24 GB para todo a plena precisión; 12–16 GB y 8 GB con copias más pequeñas), Linux, 34–41 GB de disco | un navegador |
«—»: no lo encontramos, en más de medio año con los planes de pago de SUNO. SUNO cambia rápido; esto es noviembre de 2026.
Veinte tarjetas, cada una con una línea de estilo y una letra, enviadas sin cambios a cada lado. SUNO v6 y Musicful V3 tal como los entregan sus servicios; los nuestros en bruto desde el motor, cantados de nuevo en noviembre con cada pico entero: el YuE2-3B de serie, nuestro propio ajuste fino RS-FW en tres de sus guardados y RS-TW 2.0. Aquí cada archivo suena al mismo volumen, así que ninguno gana por sonar más fuerte. Pulsa un nombre para escuchar; otro nombre en la misma tarjeta sigue desde el mismo segundo.
RS-TW 2.0 es nuestro segundo ajuste fino: su época 2.0, fusionada sobre RS-FW 2.4 a dos intensidades: ×0.75, el equilibrio seguro, y ×0.9, más tectónica, sin garantía de estabilidad. Los nuestros son dos semillas por tarjeta, ambas aquí, ninguna elegida sobre la otra: el interruptor del reproductor da la semilla 1 o la 2 y la mantiene de tarjeta en tarjeta, y las medias de la tabla cuentan las dos.
| medido en bruto, las medias | SUNO v6 | Musicful V3 | YuE2‑3B | Ruach Studio (RS-…): ajustes finos de YuE2 3B | ||||
|---|---|---|---|---|---|---|---|---|
| FW 0.7 | FW 1.5 | FW 2.4 | TW 2.0 ×0.75 | TW 2.0 ×0.9 | ||||
| error de Whisper en la letra, sobre la mezcla, % ↧ | 23.1 | 19.5 | 20.0 | 19.9 | 24.8 | 21.8 | 23.0 | 26.1 |
| error de Whisper en la letra, sobre la voz separada, % ↧ | 27.4 | 18.9 | 21.6 | 24.8 | 31.1 | 28.8 | 29.5 | 33.7 |
| arena en el silencio, 6–16 kHz, dB ↧ | -15.7 | -14.8 | -17.6 | -18.1 | -17.3 | -17.3 | -17.9 | -17.5 |
| tonos fijos sueltos ↧ | 2.2 | 1.9 | 4.33 | 2.0 | 2.27 | 2.23 | 2.15 | 1.6 |
| el zumbido de 25 Hz del decodificador en los agudos, dB ↧ | 8.3 | 8.0 | 11.4 | 11.6 | 11.6 | 11.5 | 11.6 | 11.1 |
| clics ↧ | 33.4 | 33.8 | 27.7 | 31.9 | 35.3 | 34.7 | 34.5 | 32.8 |
| tramos de recorte ↧ | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| suelo de ruido, la décima parte más silenciosa, dBFS ↧ | -26.6 | -25.2 | -27.7 | -27.6 | -27.0 | -26.6 | -27.1 | -28.2 |
| techo del espectro, kHz ↥ | 17.9 | 15.3 | 15.8 | 14.8 | 14.9 | 15.1 | 15.2 | 14.7 |
| frecuencia de caída del 95%, kHz ↥ | 2.5 | 2.6 | 2.2 | 2.1 | 2.2 | 2.0 | 1.7 | 1.7 |
| proporción de sub 20–60 Hz, dB ↥ | -8.6 | -10.2 | -10.0 | -9.6 | -9.9 | -10.4 | -10.0 | -9.8 |
| sonoridad tal como se entrega, LUFS → −14 | -15.5 | -14.3 | -14.5 | -14.7 | -14.7 | -14.4 | -14.6 | -14.8 |
| pico real tal como se entrega, dBTP → −1,0 | -3.4 | -0.5 | -0.2 | -0.2 | -0.1 | -0.2 | -0.3 | -0.1 |
| proporción de graves 60–150 Hz, dB ↥ | -6.0 | -5.6 | -4.3 | -4.8 | -4.5 | -4.5 | -4.4 | -4.8 |
| proporción de presencia 2–5 kHz, dB ↥ | -17.1 | -16.6 | -16.0 | -16.3 | -16.2 | -16.2 | -17.3 | -16.9 |
| factor de cresta, dB ↥ | 14.4 | 15.7 | 16.5 | 16.5 | 16.6 | 16.3 | 16.2 | 16.6 |
| rango de sonoridad, LU ↥ | 5.9 | 6.2 | 7.1 | 6.6 | 6.5 | 6.4 | 6.6 | 7.1 |
| dispersión de sonoridad p95−p10, dB ↥ | 9.4 | 9.0 | 11.5 | 10.8 | 10.4 | 10.3 | 10.8 | 11.7 |
| dispersión de la banda grave p95−p10, dB ↥ | 23.3 | 20.0 | 21.9 | 21.1 | 20.6 | 19.7 | 22.0 | 22.6 |
| correlación estéreo en los medios ↥ | 0.67 | 0.69 | 0.75 | 0.77 | 0.73 | 0.74 | 0.77 | 0.76 |
| duración, s ↥ | 156.8 | 154.5 | 148.6 | 148.1 | 154.8 | 151.9 | 152.8 | 149.7 |
primero · segundo · tercero de los ocho en cada fila, el primero también en negrita; ↥ más es mejor, ↧ menos es mejor, → mejor lo más cercano al valor indicado, el pico real por debajo. Las celdas con el mismo número comparten color.
Cada lado lo escucha Whisper large-v3 en una RTX 3090, la mezcla y la voz por igual: la primera fila de Whisper sobre la mezcla, la segunda sobre la voz separada, donde BS-Roformer separa de la música todas las voces de cada toma a la vez, la principal, las de apoyo y el coro, nunca solo la principal. Sin la música, Whisper a veces pierde versos enteros y escribe en las pausas palabras que nadie cantó, en todos los lados, así que las dos filas se leen mejor juntas.
FW y TW son los nombres en clave de nuestros dos ajustes finos de YuE2 3B: First Wave y Tsunami Wave. Tsunami Wave se entrenó con 109.250 pistas, unas 6.650 horas: el 66,7 % de las horas instrumental, el 31,6 % cantado, el 1,8 % hablado. Las voces están en inglés (7,0 % de las horas), ruso (5,8 %), hebreo (1,7 %), griego y ucraniano (0,6 % cada uno), francés y español (0,5 % cada uno), portugués (0,3 %), italiano (0,2 %) y catorce idiomas más, por debajo del 0,1 % cada uno; en el 15,9 % de las horas se oye una voz cuyo idioma no se identificó.
Lo suyo llega masterizado, lo nuestro en bruto, al nivel propio del decodificador, con cada pico entero: el volumen se deja al máster, que es cosa del Pulidor del Estudio. Otras semillas y otros prompts suenan distinto en cada lado; el ring muestra la calidad y la dispersión, no una clasificación final. La tabla completa y cómo se midió: la ficha del modelo.
Cada palabra que recibieron nuestros dos fine-tunes, contada y con buscador: las 109.250 pistas de entrenamiento de Tsunami Wave y las 32.633 de la Primera Ola antes que él. Géneros, instrumentos, voz, las palabras de emoción que el propio audio recibió, tonalidades y BPM, y las claves de las partituras. Pocos fine-tunes publican lo que se le dijo a su modelo.
El ring medido en vez de oído: 280 pistas, 40 por cada uno de nuestros seis lados, 20 de SUNO v6 y 20 de Musicful V3. Cada pista se llevó primero a −14 LUFS, para que el volumen no gane nada, y cada curva es el nivel propio de la pista, banda a banda, frente a toda su potencia: solo se compara la forma. Lo nuestro es la salida en bruto del motor y lo suyo llega masterizado, así que parte de las diferencias de abajo son del máster.
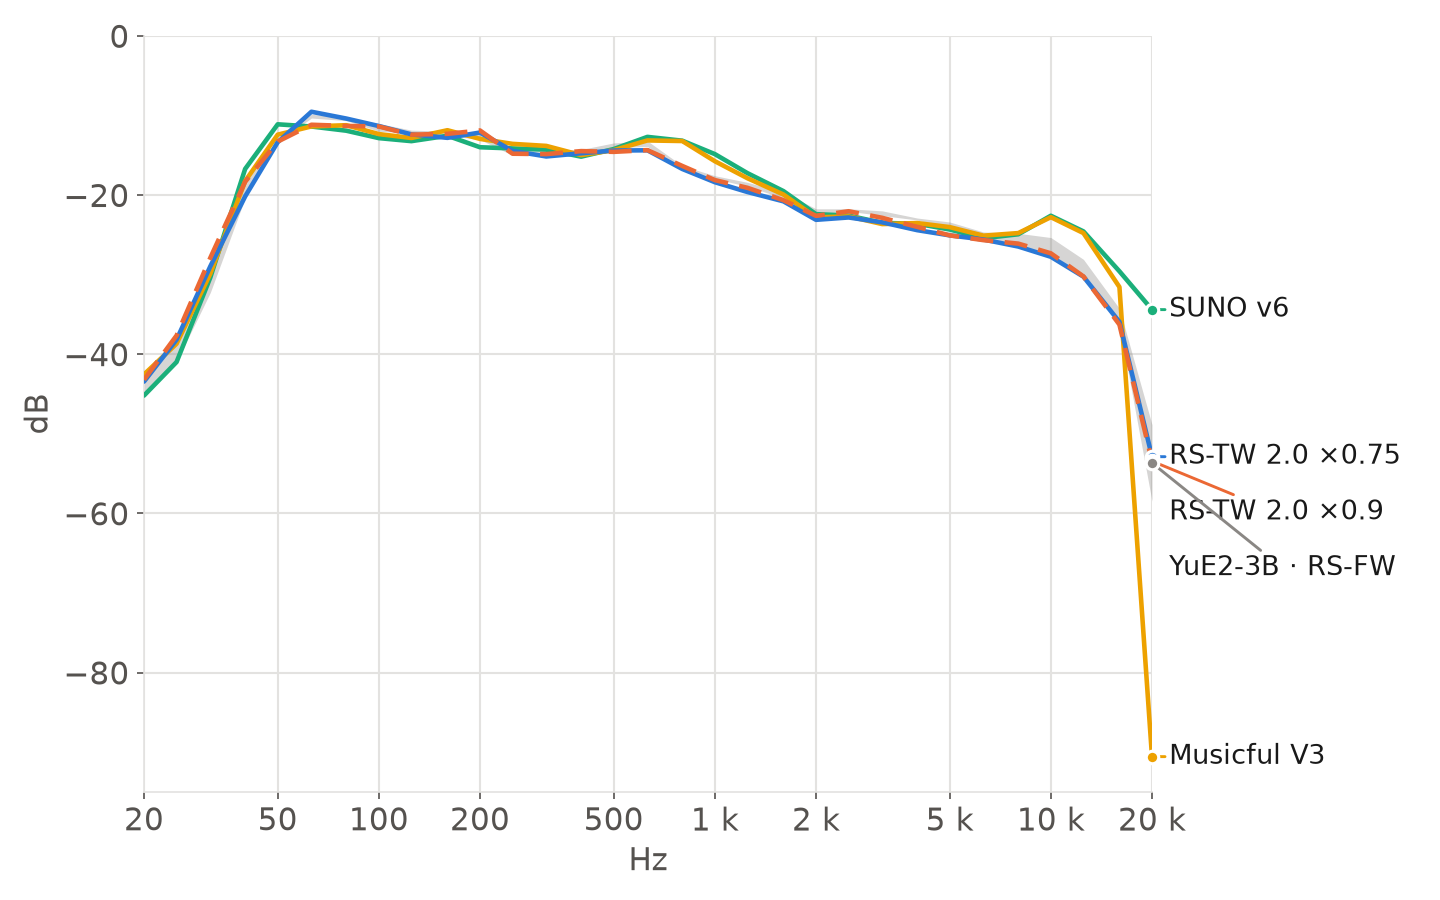
De 100 Hz a 10 kHz las curvas medias de los ocho lados quedan dentro de 5,2 dB unas de otras. Por encima de 16 kHz se separan. Musicful V3 no guarda nada por encima de 16 kHz en 38 de sus 40 pistas: a 20 kHz su media está en −90,6 dB, un muro donde los demás tienen una pendiente. SUNO v6 es el que más conserva ahí arriba, −31,0 dB en 16–20 kHz; los nuestros quedan entre −39,3 y −42,3 dB, y también se cortan a veces en 16 kHz, en 1 a 6 pistas de 40, sobre todo RS-TW 2.0 ×0.9.
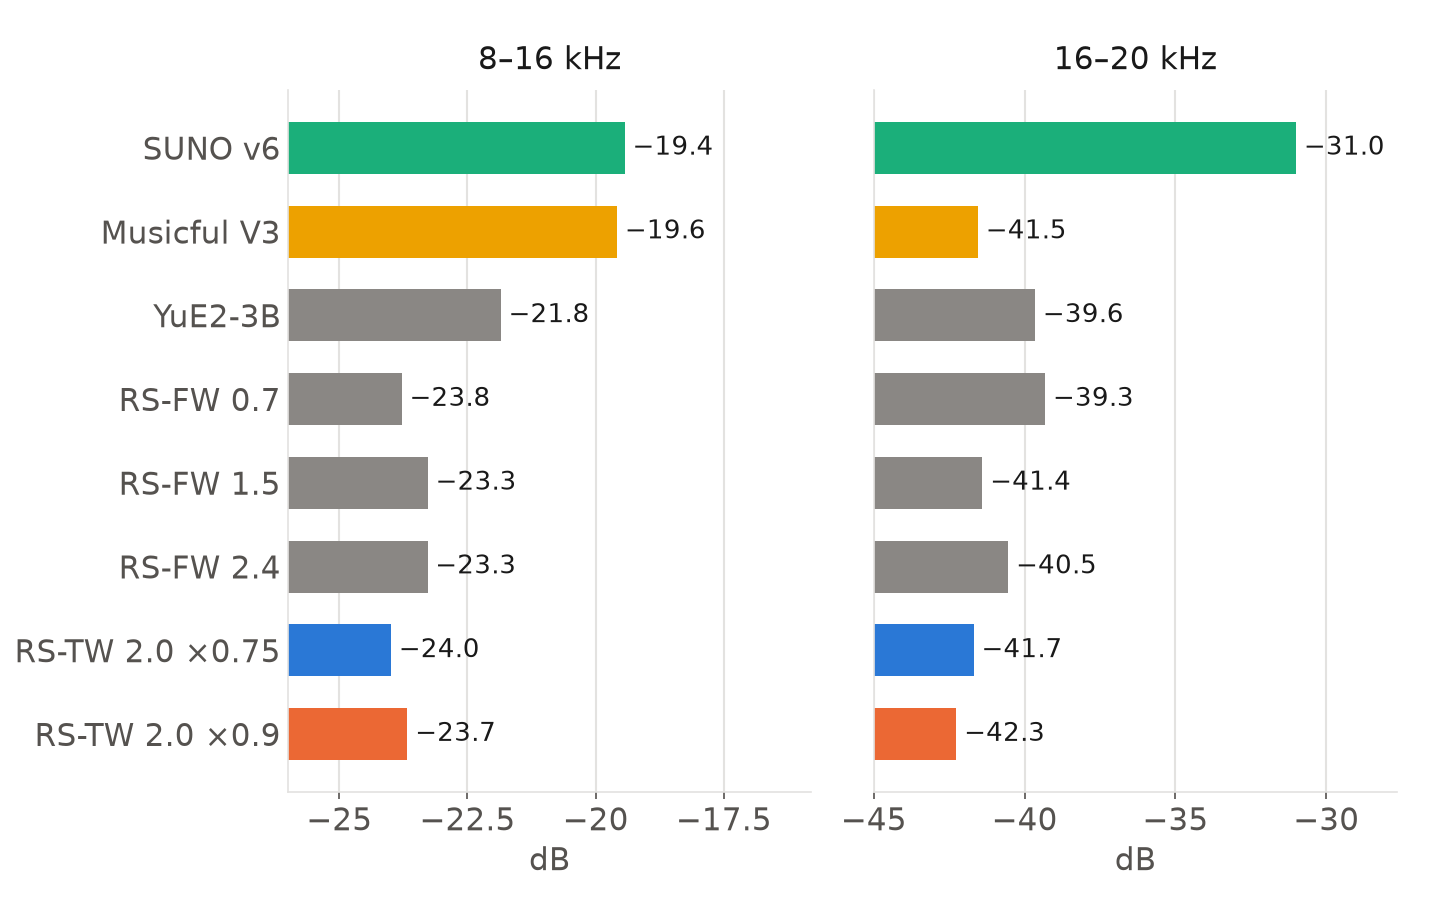
En la banda del aire, 8–16 kHz, SUNO v6 y Musicful V3 están en −19,4 y −19,6 dB de la potencia de sus pistas; nuestros seis lados, entre −21,8 y −24,0 dB. Un máster suele levantar el aire, y los nuestros no han tenido ninguno: en el Estudio eso es cosa del Pulidor, una vez cantada la canción.
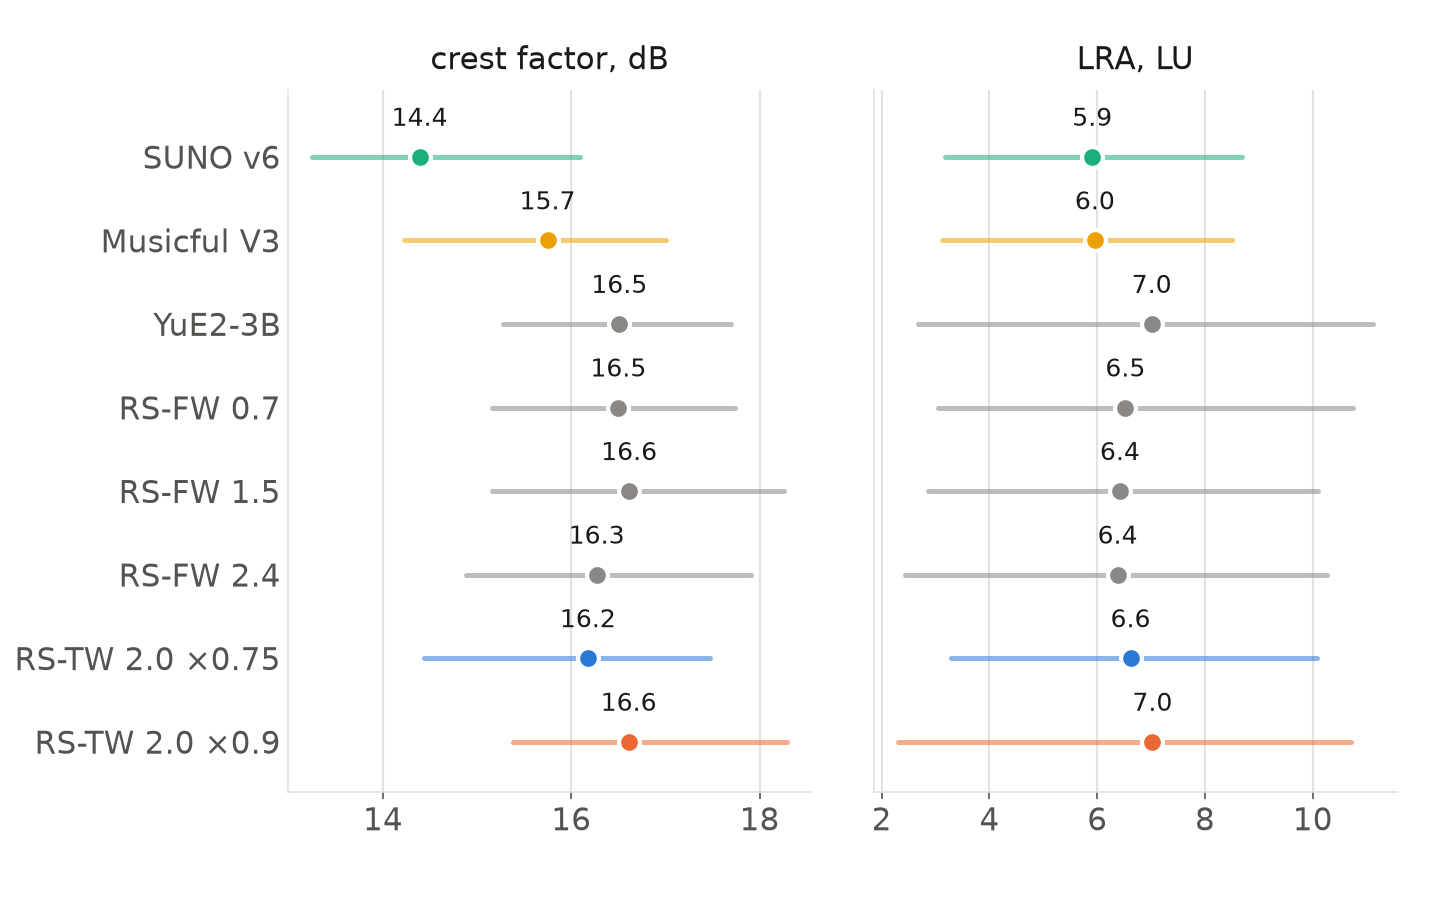
Factor de cresta, el pico sobre la media: SUNO v6 14,4 dB, Musicful V3 15,7 dB, los nuestros de 16,2 a 16,6 dB. Rango de sonoridad: los suyos 5,9 y 6,0 LU, los nuestros de 6,4 a 7,0 LU. RS-TW 2.0 ×0.9 es el más amplio de nuestros ajustes finos, 16,6 dB y 7,0 LU, tan amplio como el YuE2-3B de serie (16,5 dB, 7,0 LU): su tectónica, en números. ×0.75 es el más contenido, 16,2 dB y 6,6 LU.
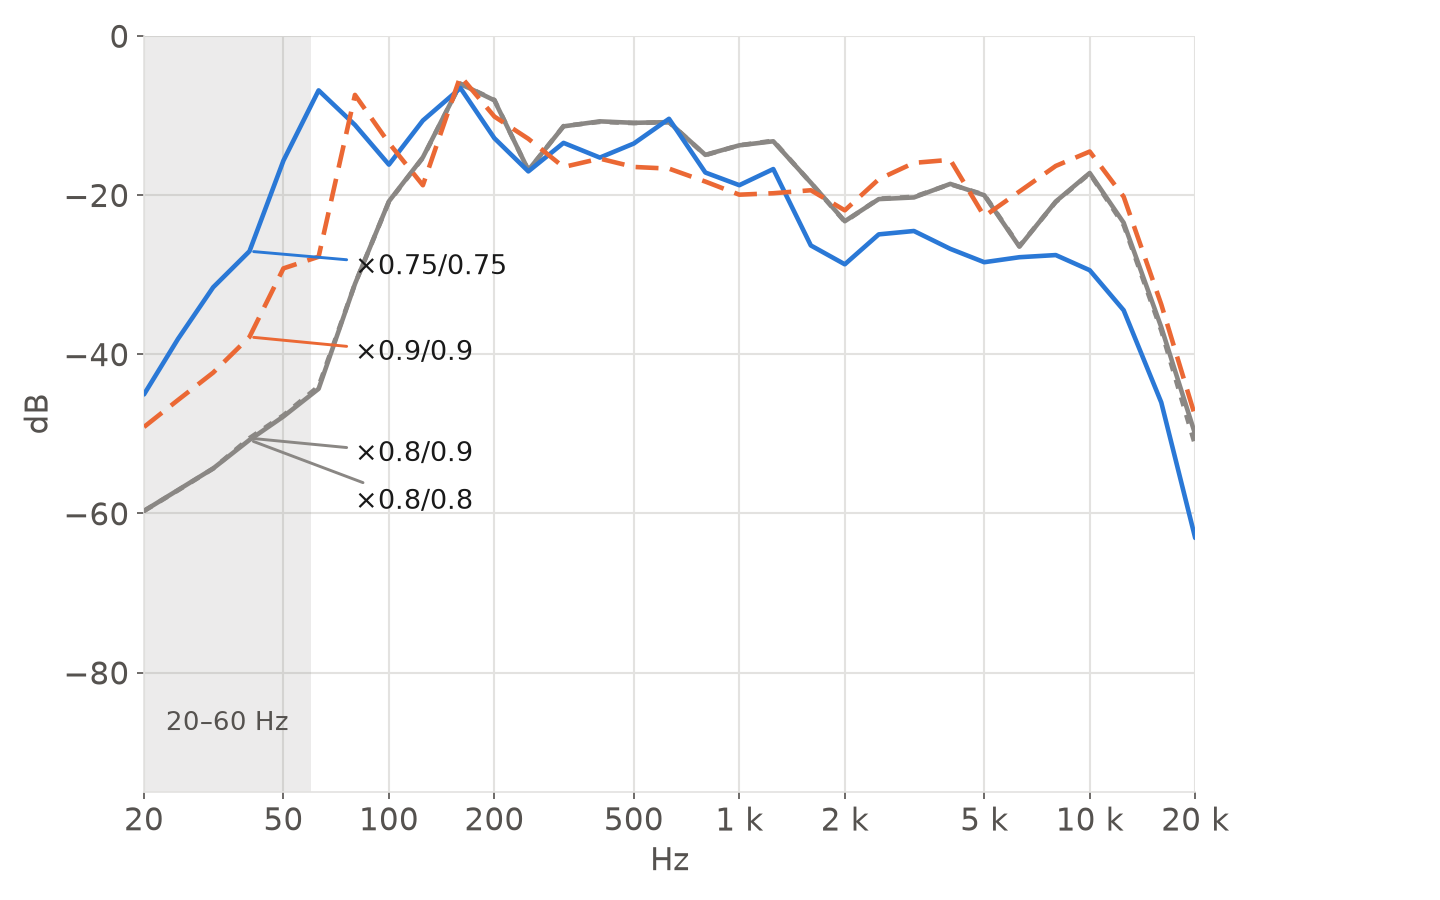
El conjunto a ciegas: doce tarjetas cantadas a cuatro intensidades de Tsunami Wave sobre RS-FW 2.4, con la misma semilla en cada intensidad. En el Salmo 22 en griego, el paso de ×0.75/0.75 a ×0.8/0.8 le quitó 36 dB al subgrave, 20–60 Hz, de −7,9 a −44,3 dB: el suelo se fue de debajo de la canción. En las doce tarjetas el vaivén es más suave, el subgrave en −8,5 dB con ×0.75/0.75 y entre −10,4 y −11,0 dB con las otras tres, y ×0.75/0.75 es el que más se acerca a la curva mediana del propio ring en 6 tarjetas de 12, a una distancia media de 4,1 dB frente a 4,8 a 5,2 dB. Por eso ×0.75 pasa a ser el modelo por defecto del Estudio en 2.0.6, y ×0.9 el que no promete estabilidad.
Medido con nuestro propio código en la CPU: bandas de tercio de octava a partir de un espectro de Welch, la sonoridad y su rango según ITU-R BS.1770-4 y EBU Tech 3342. Cada imagen se abre más grande con un clic.
Las 280 tomas del ring, medidas por su anchura. En cada una de cuatro bandas, la señal lateral, la mitad de la diferencia de los dos canales, se compara con la central, la mitad de su suma: cuanto más alta la lateral sobre la central en dB, más ancha suena esa banda, y una toma en mono no tendría lateral alguna. La panorámica es cuánto oscila la diferencia de nivel entre el canal izquierdo y el derecho a lo largo de una toma, de su percentil 5 a su percentil 95, en dB. Cada número es la mediana de las tomas de un lado: 20 para SUNO v6 y para Musicful V3, 40 para cada uno de los nuestros. Aquí más ancho no es mejor, solo más ancho: esta tabla no da puestos.
La lateral sobre la central en cuatro bandas, dB, las medianas de las tomas de cada lado: cuanto más arriba, más ancho.
| medido en bruto, las medianas | lateral sobre central, dB | panorámica, dB | |||
|---|---|---|---|---|---|
| graves 20–200 Hz | medios 0,2–2 kHz | agudos 2–8 kHz | aire 8–20 kHz | ||
| SUNO v6 | −12.5 | −7.0 | −6.8 | −9.6 | 6.4 |
| Musicful V3 | −13.0 | −7.2 | −5.9 | −7.9 | 6.6 |
| YuE2-3B | −17.4 | −8.2 | −7.9 | −10.6 | 6.4 |
| RS-FW 0.7 | −17.2 | −8.5 | −7.3 | −10.9 | 5.9 |
| RS-FW 1.5 | −17.4 | −7.5 | −6.6 | −10.2 | 6.3 |
| RS-FW 2.4 | −16.5 | −8.0 | −7.9 | −11.2 | 6.4 |
| RS-TW 2.0 ×0.75 | −19.0 | −8.1 | −7.9 | −11.6 | 6.0 |
| RS-TW 2.0 ×0.9 | −20.1 | −8.9 | −8.2 | −12.0 | 5.9 |
Nuestras fusiones dejan los medios y los agudos donde los tiene el YuE2-3B de serie, a no más de 1,3 dB. RS-TW 2.0 es un poco más estrecho en los extremos: ×0.75 en 1,6 dB en los graves, 1,0 dB en el aire y 0,4 dB en la panorámica, ×0.9 en 2,7, 1,4 y 0,5 dB. SUNO v6 y Musicful V3 abren los graves 4,9 y 4,4 dB más que el YuE2-3B de serie.
Al oído de Viktor, los extremos más estrechos de RS-TW 2.0 suenan más firmes, no como estéreo perdido: el YuE2-3B de serie a menudo aparca una guitarra en un solo canal durante 15 a 20 segundos.
Medido con nuestro propio código en la CPU: un espectro de tiempo corto de 4096 puntos cada 50 ms sobre los primeros 240 segundos de cada toma, la central y la lateral como (L+R)/2 y (L−R)/2, la panorámica a partir de la diferencia de nivel de los canales en 200 Hz – 8 kHz, en los momentos a menos de 40 dB del más fuerte de la toma.
fetch-models.sh); los modelos del Artista 39–43 GB más, los conjuntos 💎 5,6 GB, cada uno solo cuando lo pidasNo en GPU gratuitas en la nube. Ruach Studio no funciona en Google Colab, Kaggle ni en ninguna GPU gratuita de cuadernos, así que no pierdas una tarde ahí: es un Estudio entero, no un cuaderno. Compila su motor de C++/CUDA en la máquina donde vive, mantiene a su lado un servidor y un laboratorio de servicios en Python, y ocupa unos 34–41 GB de disco (74–84 GB con el Artista). La tarjeta, la memoria, el disco que se borra y el límite de horas de una sesión gratuita no lo sostienen. Pide tu propio ordenador con Linux, o un servidor que alquiles y conserves, con una tarjeta NVIDIA: 24 GB para todo, 16 GB con las copias menores del modelo.
Medido archivo por archivo con las listas fijadas de los repositorios del Estudio y en el disco de una instalación nueva (1 GB = 10⁹ bytes). La instalación trae el Creador, el Bibliotecario y la cadena del Pulidor; cualquier otra sala llega solo cuando la pides, desde Motor → Modelos y LoRA → Por sala, que primero mide el espacio libre y no descarga lo que no cabría.
| tarjeta de 24 GB | tarjeta de 12–16 GB | tarjeta de 8 GB | |
|---|---|---|---|
| el programa y su motor, compilado aquí (se descargan 0,2 GB) | 0,9 GB | 0,9 GB | 0,9 GB |
| sus dos Python, con PyTorch para CUDA 12.8 en cada uno (se descargan 8,7 GB) | 16,5 GB | 16,5 GB | 16,5 GB |
| YuE2 y el ajuste fino propio de Ruach Studio, en el cuantizado de la tarjeta | 14,9 GB | 8,2 GB | 8,2 GB |
| el resto: dos decodificadores más, el transcriptor, Whisper, los modelos de stems, UniverSR y Apollo-vocal, los LoRA | 8,8 GB | 8,8 GB | 8,8 GB |
| la instalación | 41,1 GB | 34,4 GB | 34,4 GB |
| + Escritor: su modelo de lenguaje con llama.cpp | 7,4 GB | 7,4 GB | 6,2 GB |
| + Pulidor: MuScriptor y FlashSR | 6,1 GB | 6,1 GB | 6,1 GB |
| + Artista: sus ayudantes y Qwen-Image 2512 (Q6 con 24 GB, Q4 por debajo) | 42,9 GB | 39,3 GB | 39,3 GB |
| + Videógrafo: MiniMax H3 y SeedVR2 | 86,3 GB | necesita 24 GB | necesita 24 GB |
| + Entrenador LoRA: su base y el oyente de estilo | 20,2 GB | 16,3 GB | 12,9 GB |
| todas las salas | 204,0 GB | 103,5 GB | 98,9 GB |
Solo cuando lo pides por su nombre: los demás motores de sonido (las fusiones IRA, IRAE y RS-FW, de 35 a 86 GB según el cuantizado), los adaptadores del Artista (7,5 GB) y los ajustes finos (20,4 GB cada uno), todos los niveles de MiniMax H3 (201 GB) o BF16 (478 GB), los conjuntos 💎 (5,6 GB). No cuentan: el controlador de NVIDIA y el CUDA toolkit, Pianoteq (lo compras tú), tus tomas.
2.0.5 es el Estudio en el que hacemos cada día nuestras propias canciones. Estas son las piezas más grandes en camino, para 2.1.0 y después.
Viktor Zhuromskyy, the author of Ruach Studio, does not publish it for the hype. He made it for himself. After more than half a year of struggling with Suno on paid plans, and of searching for a model worth working with (ACE-Step, MiniMax and others), he set out to build an audio studio of his own, on his own machine. He settled on YuE2: of all the open models, it is the best value and the most refined.
He did not knock the Studio together just to have something that runs. He built it his own way, because his creative work is his own too, refined and one of a kind: his translations, his interlinear texts and much more. He fit into it as much as he could, polished the interface as far as he could, and made creating in it not poking and clicking among crutches and potholes, but as productive as it can be.
That is the whole story. Now the Studio is yours as well.
Виктор Журомский, автор Ruach Studio, публикует её не ради хайпа. Он делал её для себя. После более чем полугода мучений с Suno на платных тарифах и поисков достойной модели (ACE-Step, MiniMax и другие) он взялся построить собственную аудиостудию, на своей машине. Выбор пал на YuE2: из всех открытых моделей она самая рентабельная и самая изысканная.
Студию он делал не тяп-ляп, лишь бы работало, а в своём стиле, потому что и творчество у него своё, изысканное и неповторимое: собственные переводы, подстрочники и многое другое. Он постарался вместить в неё максимум, отполировать интерфейс до блеска и сделать творчество в Студии не тыканьем и кликаньем среди костылей и ям, а по-настоящему продуктивным.
Вот и вся история. Теперь эта Студия и ваша.
Віктор Журомський, автор Ruach Studio, публікує її не заради хайпу. Він творив її для себе. Після понад пів року мук із Suno на платних тарифах і пошуків гідної моделі (ACE-Step, MiniMax та інші) він узявся збудувати власну аудіостудію, на своїй машині. Вибір упав на YuE2: з усіх відкритих моделей вона найвигідніша й найвишуканіша.
Студію він творив не абияк, аби лиш працювало, а у своєму стилі, бо й творчість у нього своя, вишукана й неповторна: власні переклади, підрядники та багато іншого. Він намагався вмістити в неї максимум, відшліфувати інтерфейс до блиску, щоб творчість у Студії була не тицянням і клацанням серед милиць і ям, а справді продуктивною.
Ось і вся історія. Тепер ця Студія і ваша.
Віктар Журомскі, аўтар Ruach Studio, публікуе яе не дзеля хайпу. Ён тварыў яе для сябе. Пасля больш як паўгода пакут з Suno на платных тарыфах і пошукаў годнай мадэлі (ACE-Step, MiniMax і іншыя) ён узяўся пабудаваць уласную аўдыястудыю, на сваёй машыне. Выбар упаў на YuE2: з усіх адкрытых мадэляў яна самая выгадная і самая вытанчаная.
Студыю ён тварыў не абы-як, абы працавала, а ў сваім стылі, бо і творчасць у яго свая, вытанчаная і непаўторная: уласныя пераклады, падрадкоўнікі і шмат іншага. Ён стараўся змясціць у яе максімум, адшліфаваць інтэрфейс да бляску, каб творчасць у Студыі была не тыцканнем і клікамі сярод мыліц і ям, а сапраўды прадуктыўнай.
Вось і ўся гісторыя. Цяпер гэтая Студыя і ваша.
Ο Viktor Zhuromskyy, ο δημιουργός του Ruach Studio, δεν το δημοσιεύει για εντυπωσιασμό. Το έφτιαξε για τον εαυτό του. Ύστερα από περισσότερους από έξι μήνες ταλαιπωρίας με το Suno σε πληρωμένα πακέτα, και αναζήτησης ενός μοντέλου που να αξίζει (ACE-Step, MiniMax και άλλα), αποφάσισε να φτιάξει ένα δικό του στούντιο ήχου, στο δικό του μηχάνημα. Κατέληξε στο YuE2: από όλα τα ανοιχτά μοντέλα είναι το πιο συμφέρον και το πιο εκλεπτυσμένο.
Δεν έστησε το Στούντιο πρόχειρα, απλώς για να λειτουργεί. Το έφτιαξε με το δικό του ύφος, γιατί και η δημιουργία του είναι δική του, εκλεπτυσμένη και μοναδική: οι μεταφράσεις του, τα διάστιχα κείμενά του και πολλά άλλα. Προσπάθησε να χωρέσει σε αυτό όσο περισσότερα γινόταν, να γυαλίσει το περιβάλλον ως την τελευταία λεπτομέρεια και να κάνει τη δημιουργία στο Στούντιο όχι άσκοπα κλικ ανάμεσα σε δεκανίκια και λακκούβες, αλλά κάτι πραγματικά παραγωγικό.
Αυτή είναι όλη η ιστορία. Τώρα το Στούντιο είναι και δικό σας.
Viktor Zhuromskyy, el autor de Ruach Studio, no lo publica para llamar la atención. Lo hizo para sí mismo. Tras más de medio año de sufrir con Suno en planes de pago y de buscar un modelo que mereciera la pena (ACE-Step, MiniMax y otros), se propuso construir su propio estudio de audio, en su propia máquina. Se quedó con YuE2: de todos los modelos abiertos, es el más rentable y el más refinado.
No montó el Estudio de cualquier manera, solo para que funcionara. Lo hizo a su estilo, porque su creación también es suya, refinada e irrepetible: sus traducciones, sus textos interlineales y mucho más. Procuró meter en él todo lo posible, pulir la interfaz hasta el último detalle y hacer que crear en el Estudio no sea dar clics a ciegas entre muletas y baches, sino algo de verdad productivo.
Esa es toda la historia. Ahora el Estudio también es tuyo.
Viktor Zhuromskyy, l'autore di Ruach Studio, non lo pubblica per fare clamore. Lo ha costruito per sé. Dopo più di sei mesi di tormenti con Suno sui piani a pagamento, e di ricerche di un modello all'altezza (ACE-Step, MiniMax e altri), ha deciso di crearsi uno studio audio tutto suo, sulla sua macchina. La scelta è caduta su YuE2: fra tutti i modelli aperti è il più conveniente e il più raffinato.
Non ha messo insieme lo Studio alla buona, giusto perché funzionasse. Lo ha fatto a modo suo, perché anche la sua opera creativa è sua, raffinata e irripetibile: le sue traduzioni, i suoi testi interlineari e molto altro. Ha cercato di farci stare il massimo, di rifinire l'interfaccia fino all'ultimo dettaglio e di rendere il creare nello Studio non un cliccare a vuoto tra stampelle e buche, ma qualcosa di davvero produttivo.
Questa è tutta la storia. Ora lo Studio è anche tuo.
Viktor Zhuromskyy, l'auteur de Ruach Studio, ne le publie pas pour faire parler de lui. Il l'a fait pour lui-même. Après plus de six mois à se débattre avec Suno sur des formules payantes, et à chercher un modèle qui en vaille la peine (ACE-Step, MiniMax et d'autres), il s'est mis à construire son propre studio audio, sur sa propre machine. Son choix s'est arrêté sur YuE2 : de tous les modèles ouverts, c'est le plus rentable et le plus raffiné.
Il n'a pas bricolé le Studio à la va-vite, juste pour avoir quelque chose qui tourne. Il l'a fait à sa manière, parce que sa création est la sienne, raffinée et inimitable : ses traductions, ses textes interlinéaires et bien plus encore. Il y a fait entrer tout ce qu'il a pu, a poli l'interface aussi loin qu'il a pu, et a fait de la création dans le Studio non pas un tâtonnement de clics entre béquilles et nids-de-poule, mais quelque chose de vraiment productif.
Voilà toute l'histoire. Maintenant, le Studio est aussi à toi.
Viktor Zhuromskyy, o autor do Ruach Studio, não o publica pelo hype. Ele o fez para si mesmo. Depois de mais de meio ano sofrendo com o Suno em planos pagos, e procurando um modelo que valesse a pena (ACE-Step, MiniMax e outros), ele decidiu construir o seu próprio estúdio de áudio, na sua própria máquina. A escolha caiu no YuE2: de todos os modelos abertos, é o de melhor custo-benefício e o mais refinado.
Ele não montou o Estúdio de qualquer jeito, só para ter algo que rodasse. Fez do seu jeito, porque a criação dele é dele, refinada e inimitável: as suas traduções, os seus textos interlineares e muito mais. Colocou nele o máximo que pôde, poliu a interface até onde pôde e fez da criação no Estúdio não um cutucar e clicar entre muletas e buracos, mas algo de fato produtivo.
Essa é a história toda. Agora o Estúdio também é seu.
Viktor Zhuromskyy, der Autor von Ruach Studio, veröffentlicht es nicht für den Hype. Er hat es für sich selbst gemacht. Nach mehr als einem halben Jahr Mühe mit Suno in bezahlten Tarifen und der Suche nach einem Modell, mit dem sich arbeiten lässt (ACE-Step, MiniMax und andere), machte er sich daran, ein eigenes Audiostudio zu bauen, auf seiner eigenen Maschine. Die Wahl fiel auf YuE2: von allen offenen Modellen das lohnendste und das ausgefeilteste.
Er hat das Studio nicht zusammengeschustert, nur damit irgendetwas läuft. Er hat es auf seine Art gebaut, denn auch sein Schaffen ist sein eigenes, erlesen und unverwechselbar: seine Übersetzungen, seine Interlinearübersetzungen und vieles mehr. Er hat so viel hineingepackt, wie er konnte, die Oberfläche poliert, so weit er konnte, und das Schaffen darin nicht zu einem Stochern und Klicken zwischen Krücken und Schlaglöchern gemacht, sondern zu etwas wirklich Produktivem.
Das ist die ganze Geschichte. Jetzt ist das Studio auch deins.
Ruach Studio の作者 Viktor Zhuromskyy は、話題づくりのためにこれを公開しているのではありません。自分のために作ったのです。有料プランで Suno と半年以上格闘し、取り組むに値するモデルを探し回った末に(ACE-Step、MiniMax ほか)、彼は自分のマシンの上に自分だけのオーディオスタジオを作ろうと決めました。選んだのは YuE2 でした。オープンなモデルの中で、最も割に合い、最も洗練されているからです。
彼は、とりあえず動けばいいという作り方はしませんでした。自分の流儀で作りました。彼の創作は彼自身のもの、洗練された唯一無二のものだからです:自身の翻訳、行間対訳のテキスト、そのほか多くのもの。詰め込めるだけ詰め込み、磨けるだけインターフェースを磨き、スタジオでの創作を、松葉杖と穴ぼこの間を手探りでクリックすることではなく、本当に生産的なものにしました。
話はこれで全部です。これからは、このスタジオはあなたのものでもあります。
Ruach Studio 的作者 Viktor Zhuromskyy 发布它并不是为了炒作。他是为自己做的。在付费套餐上和 Suno 折腾了半年多,又四处寻找值得投入的模型(ACE-Step、MiniMax 等)之后,他决定在自己的机器上搭建一个属于自己的音频工作室。他选定了 YuE2:在所有开放模型中,它最划算,也最精致。
他没有随便拼凑一个能跑就行的工作室,而是按自己的方式来做,因为他的创作也是他自己的,精致而独一无二:他的译本、他的逐行对照文本,还有许多别的。他尽可能多地装进其中,把界面打磨到力所能及的极致,让在这个工作室里的创作不再是在拐杖和坑洼之间胡乱点击,而是真正高效的事。
故事就是这样。现在,这个工作室也是你的了。