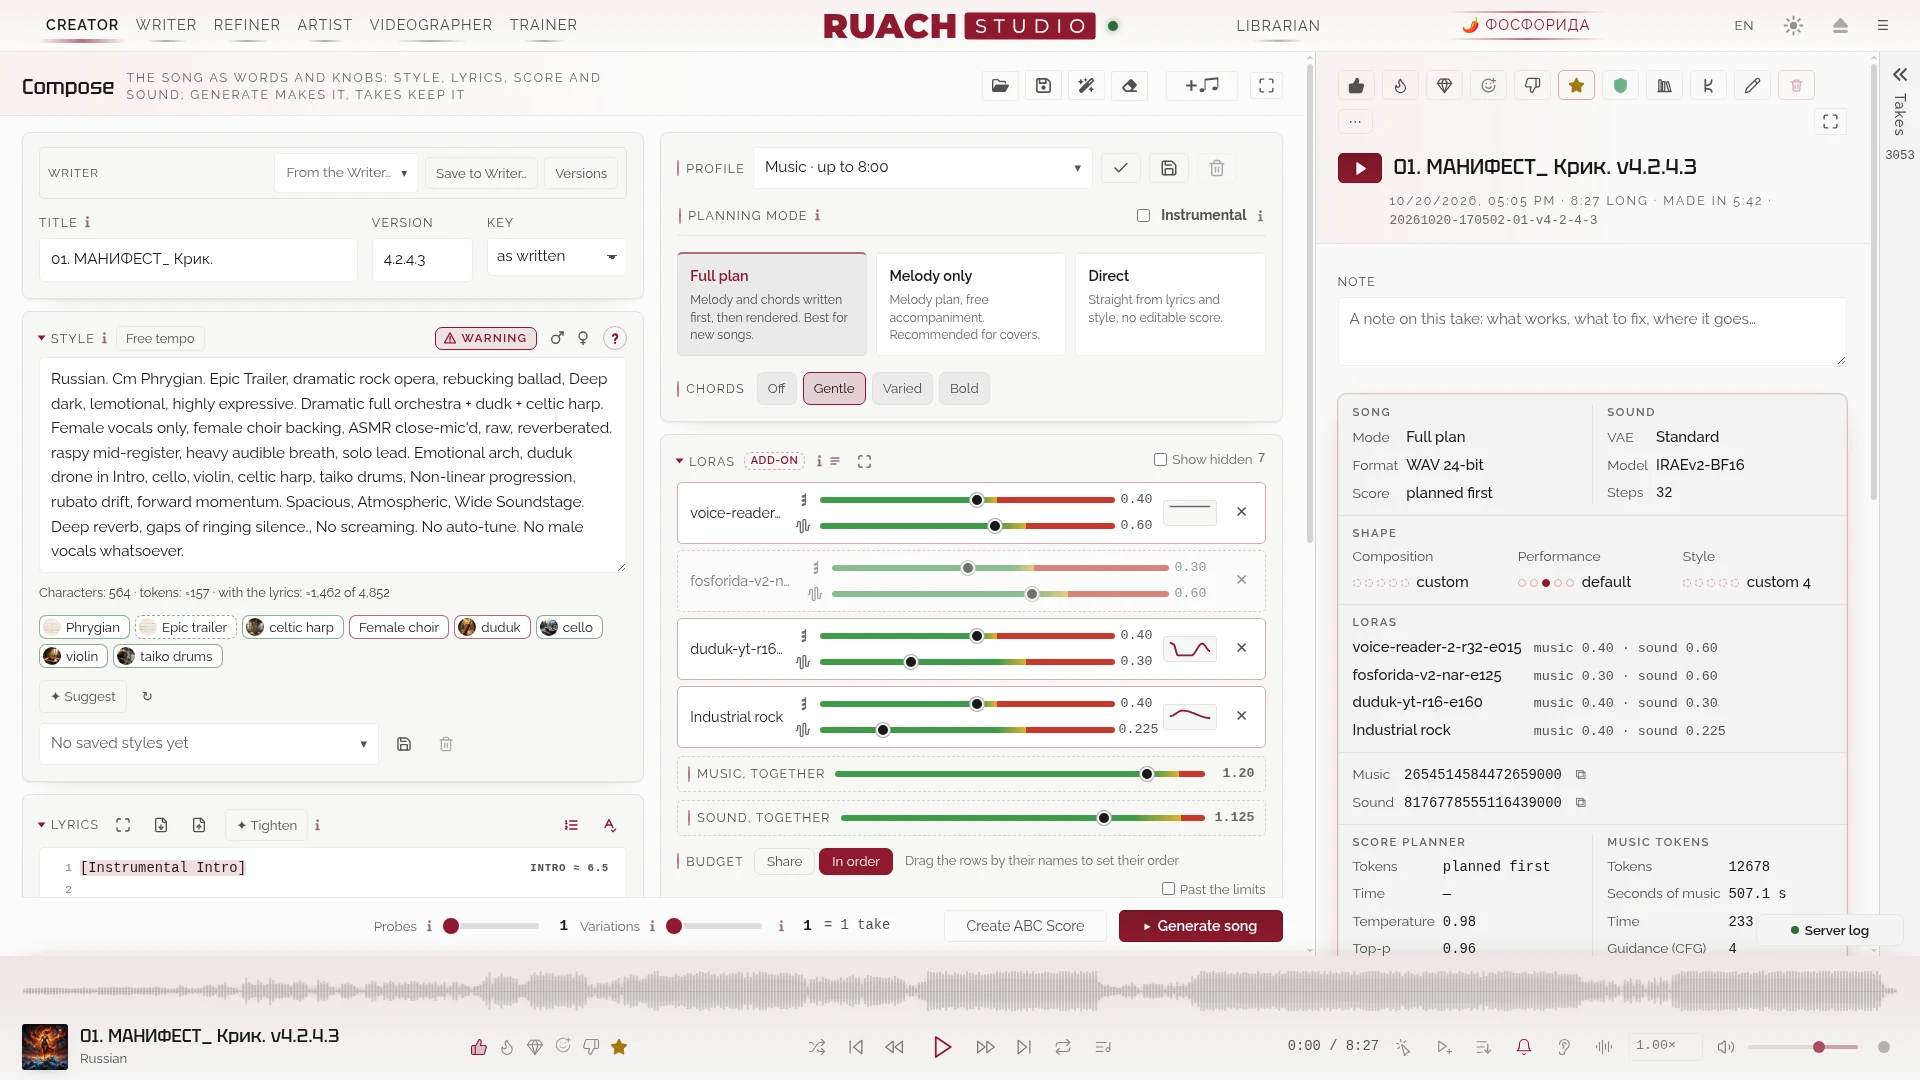
Creatore
Stile, testo, modalità di pianificazione, decoder, LoRA su una strada dal verde al rosso; il take con la sua partitura, i suoi semi e tutto ciò che serve per rifarlo.
Un intero Studio attorno a YuE2, il modello aperto di canzoni. Scrivi lo stile e il testo, e lo Studio compone, canta e rende la canzone sulla tua GPU. Le tue canzoni, parole e impostazioni non la lasciano mai.
2.0.5 · ogni picco intero, l'albero genealogico e lo Studio via https · novembre 2026
Ruach Studio è generazione musicale aperta che gira sul tuo hardware: il modello, la partitura, gli adattatori e ogni take restano tuoi, e niente si affitta a token. I modelli aperti ora sono abbastanza buoni da reggersi da soli, e ciò che mancava è lo Studio attorno a loro: è questo che costruiamo, alla luce del sole.
La musica dev'essere libera da creare e da condividere: chi non ha voce, né strumento, né Studio ha comunque il diritto di affidare al suono i propri pensieri e sentimenti.
Il Creatore fa la canzone, lo Scrittore la scrive con un modello di chat, il Rifinitore la finisce, l'Artista dipinge le sue immagini, il Videografo progetta il suo videoclip, il Bibliotecario conserva ogni take e l'Addestratore LoRA insegna a YuE2 le tue canzoni. Dentro lo Studio c'è una guida per ogni stanza.
Stile, testo, modalità di pianificazione, decoder, LoRA su una strada dal verde al rosso; il take con la sua partitura, i suoi semi e tutto ciò che serve per rifarlo.
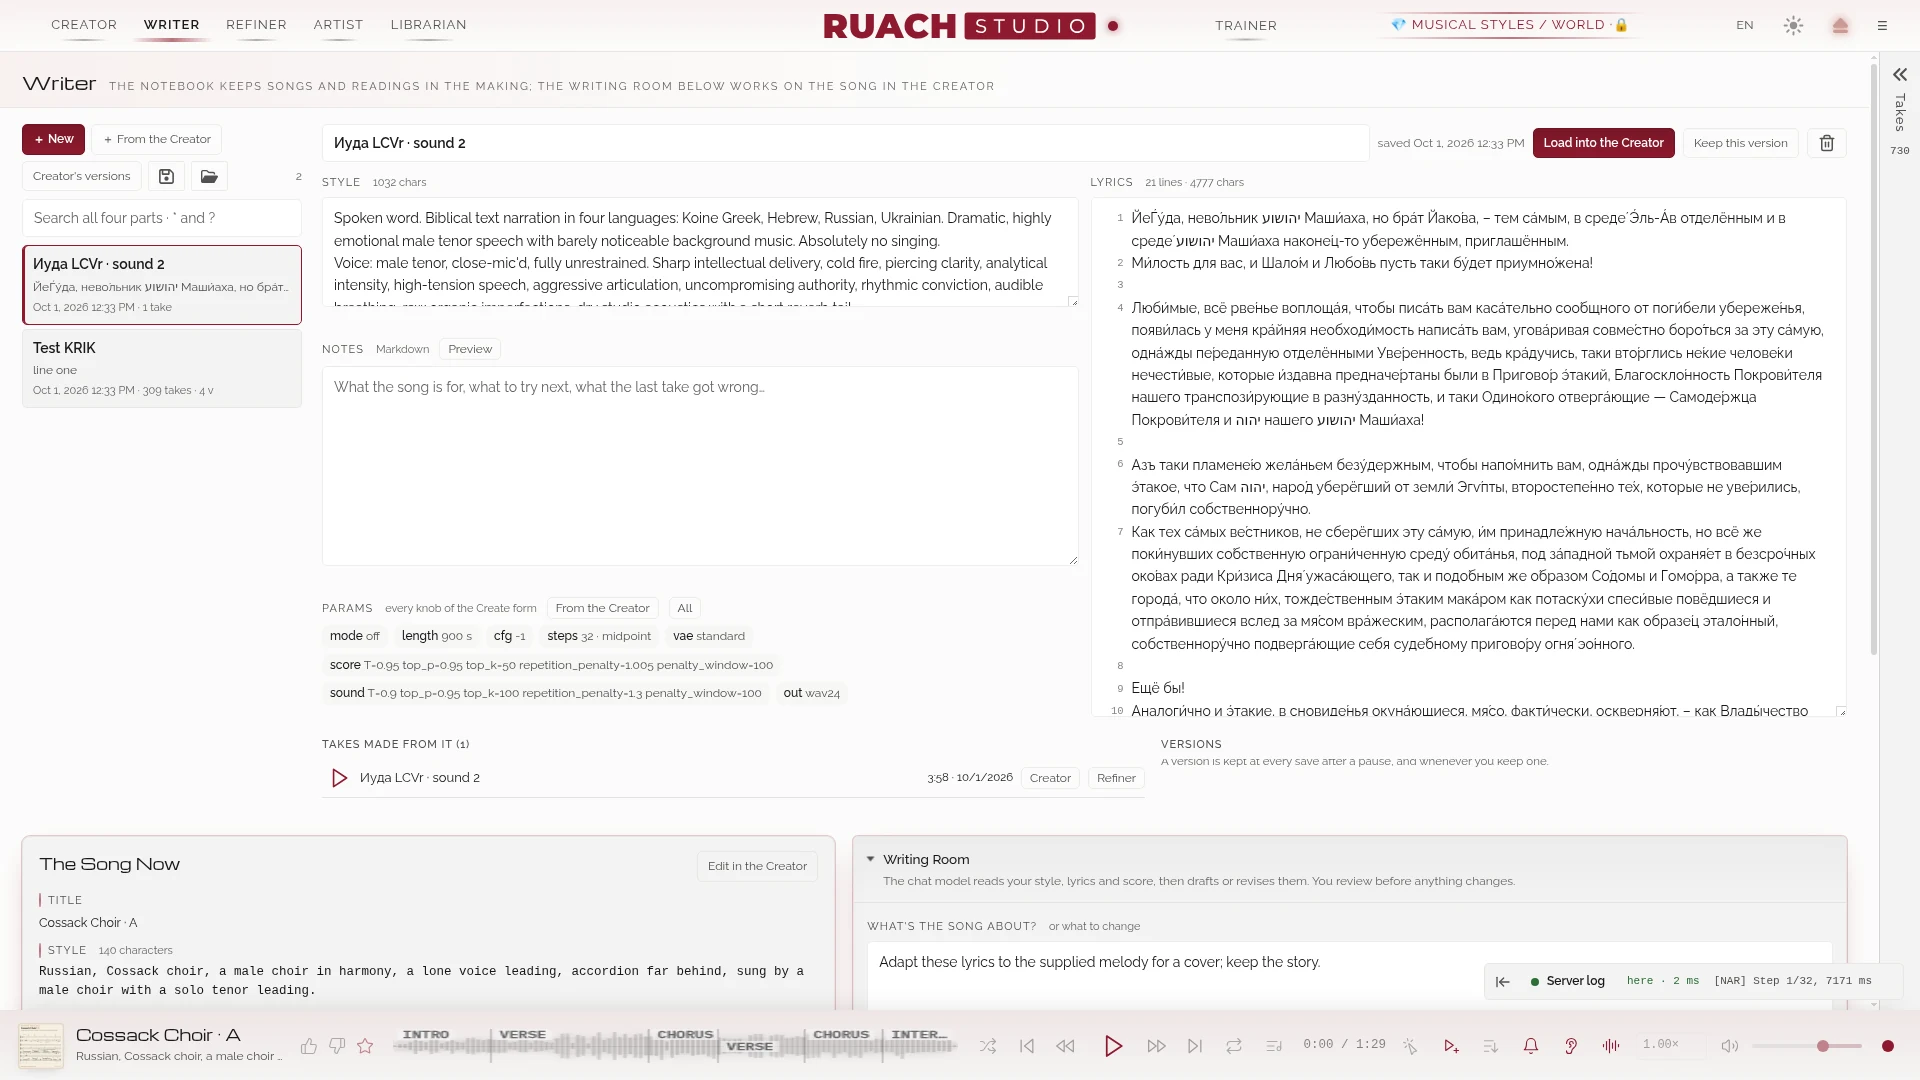
Canzoni come documenti con versioni, profili di testo e un tuo modello di chat (o OpenRouter) che abbozza e rivede con te.
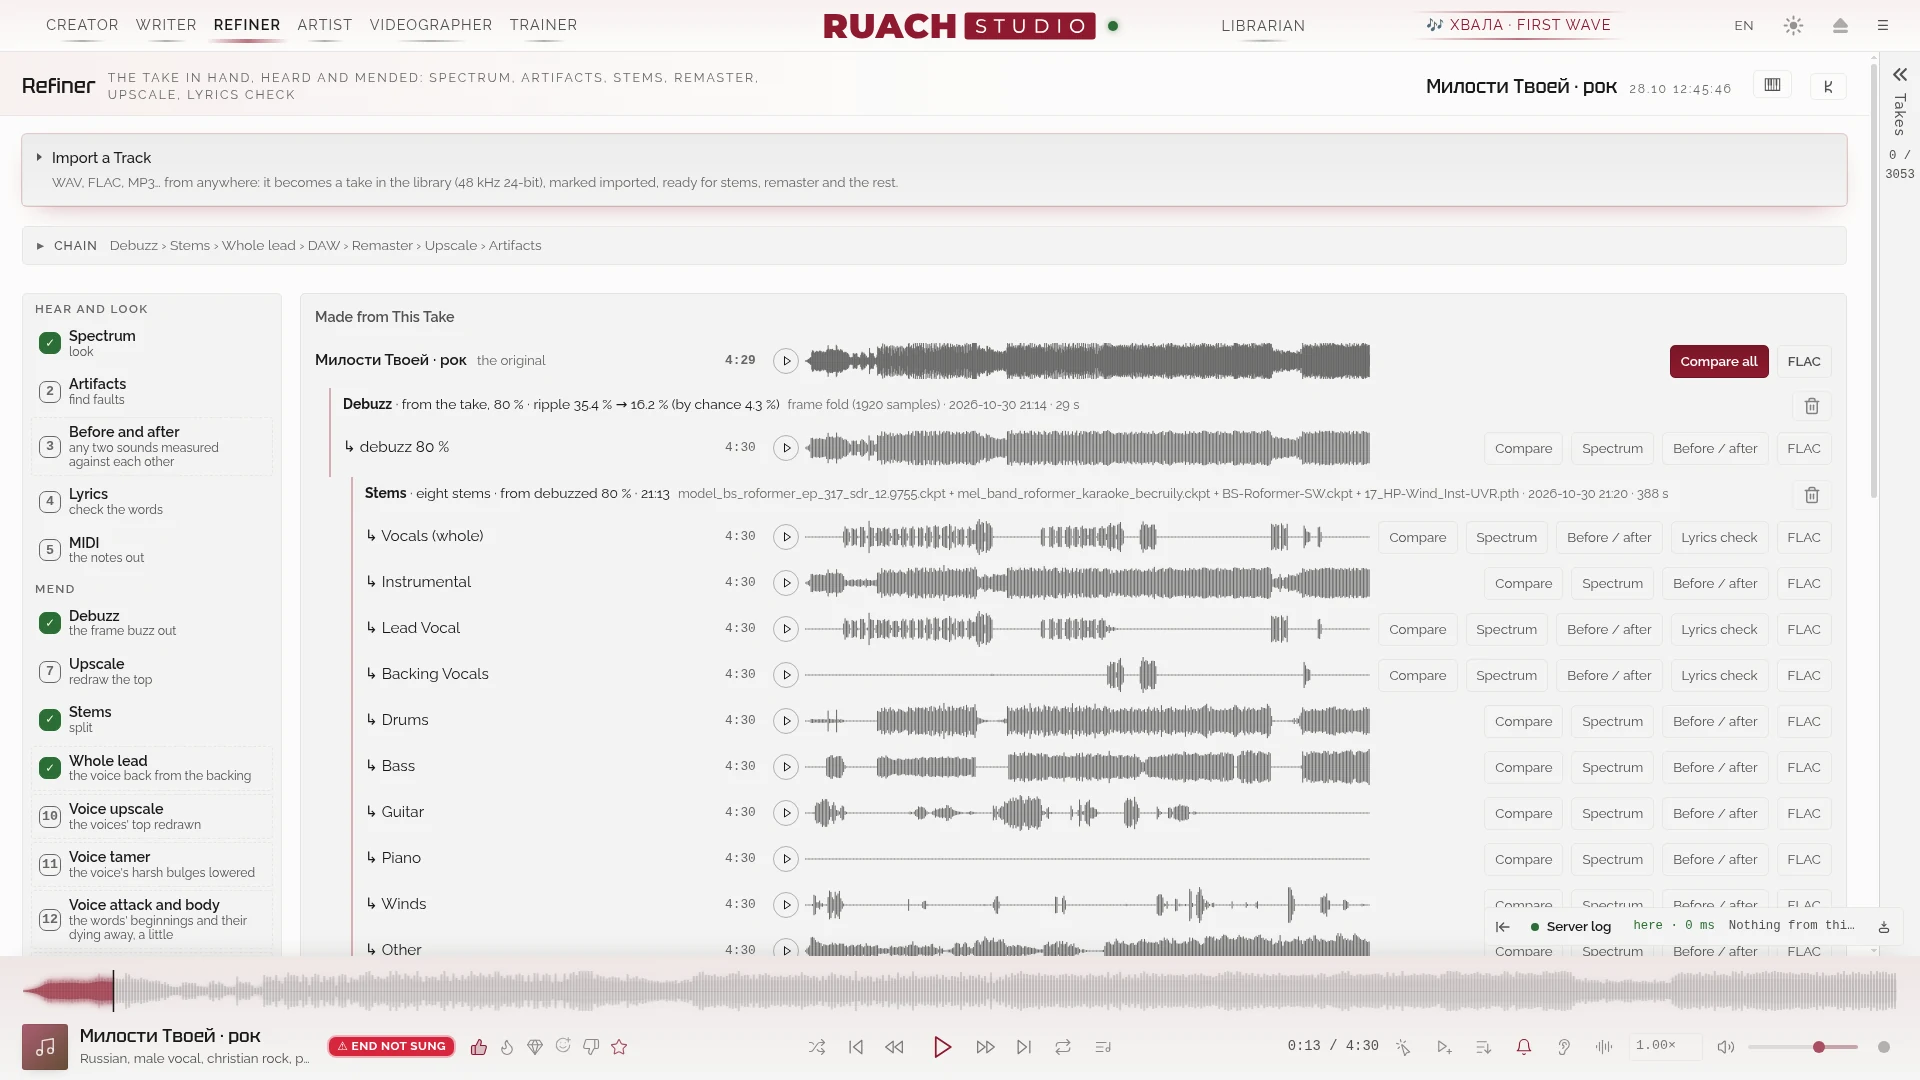
Spettro, artefatti, antironzio, una verifica del testo con Whisper, stem, remaster, upscale; una catena li esegue tutti.
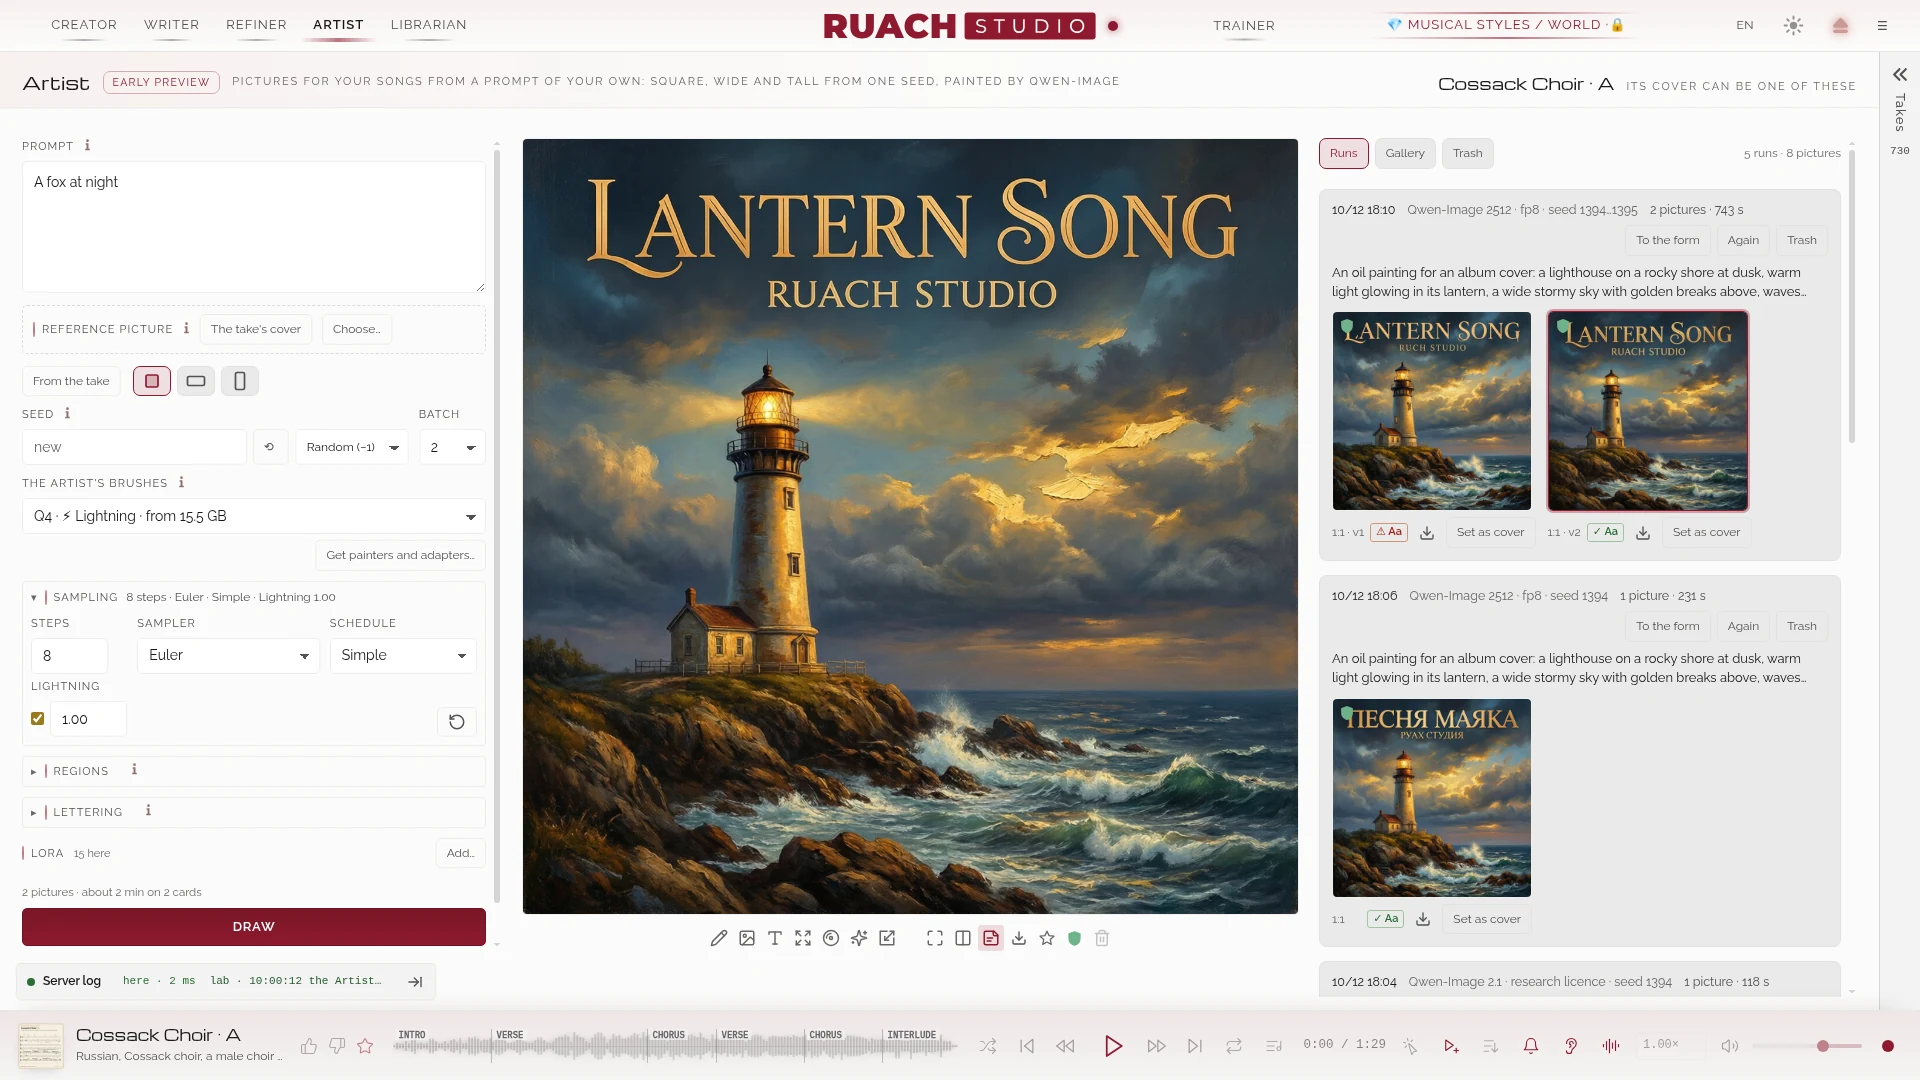
Immagini per le tue canzoni da un prompt tuo: quadrata, larga e alta da un solo seed, dipinte da Qwen-Image 2512; l'immagine si rivela davanti ai tuoi occhi e una quadrata diventa la copertina del take. Un'anteprima.
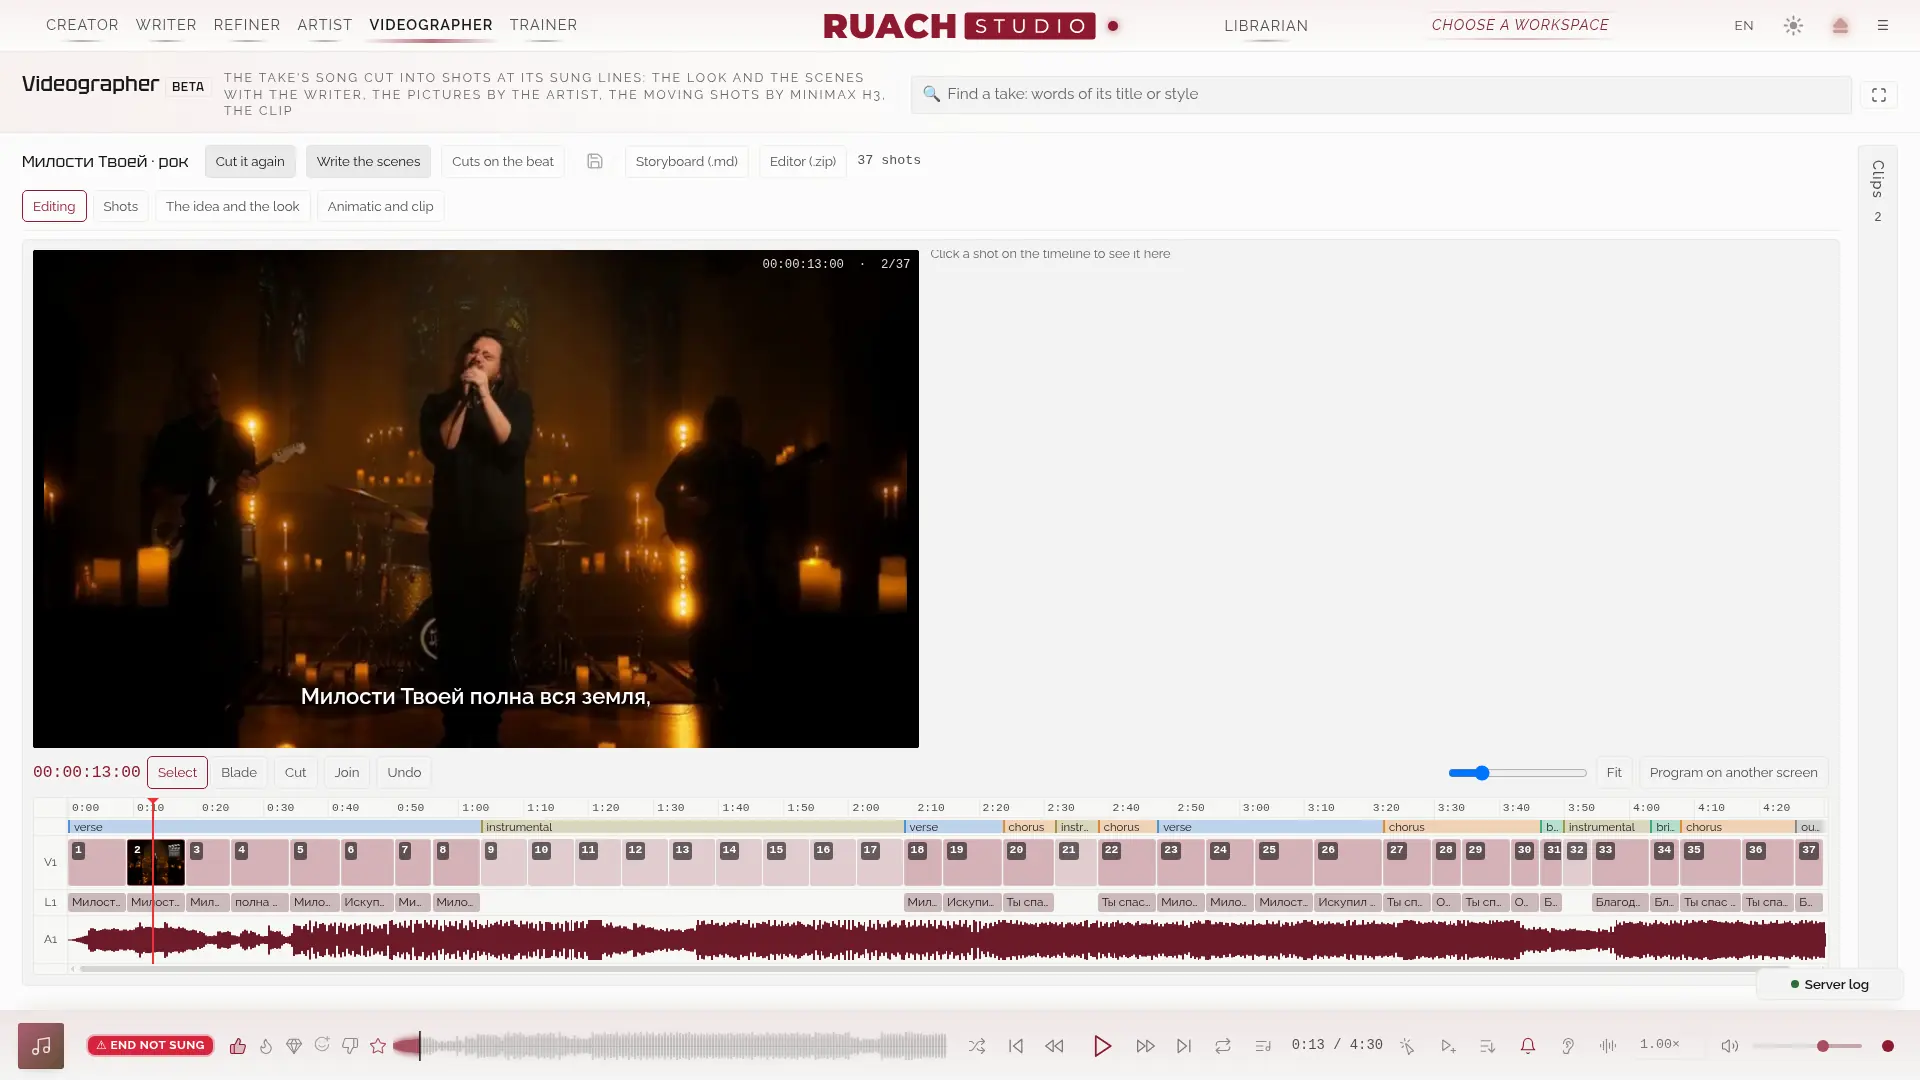
Un videoclip per la take: la canzone tagliata in inquadrature sui versi cantati, le scene scritte con lo Scrittore, i fotogrammi chiave dipinti dall'Artista, le inquadrature in movimento da MiniMax H3; una timeline per montare, un look (LUT 3D, grana), un animatic e il clip. Beta.
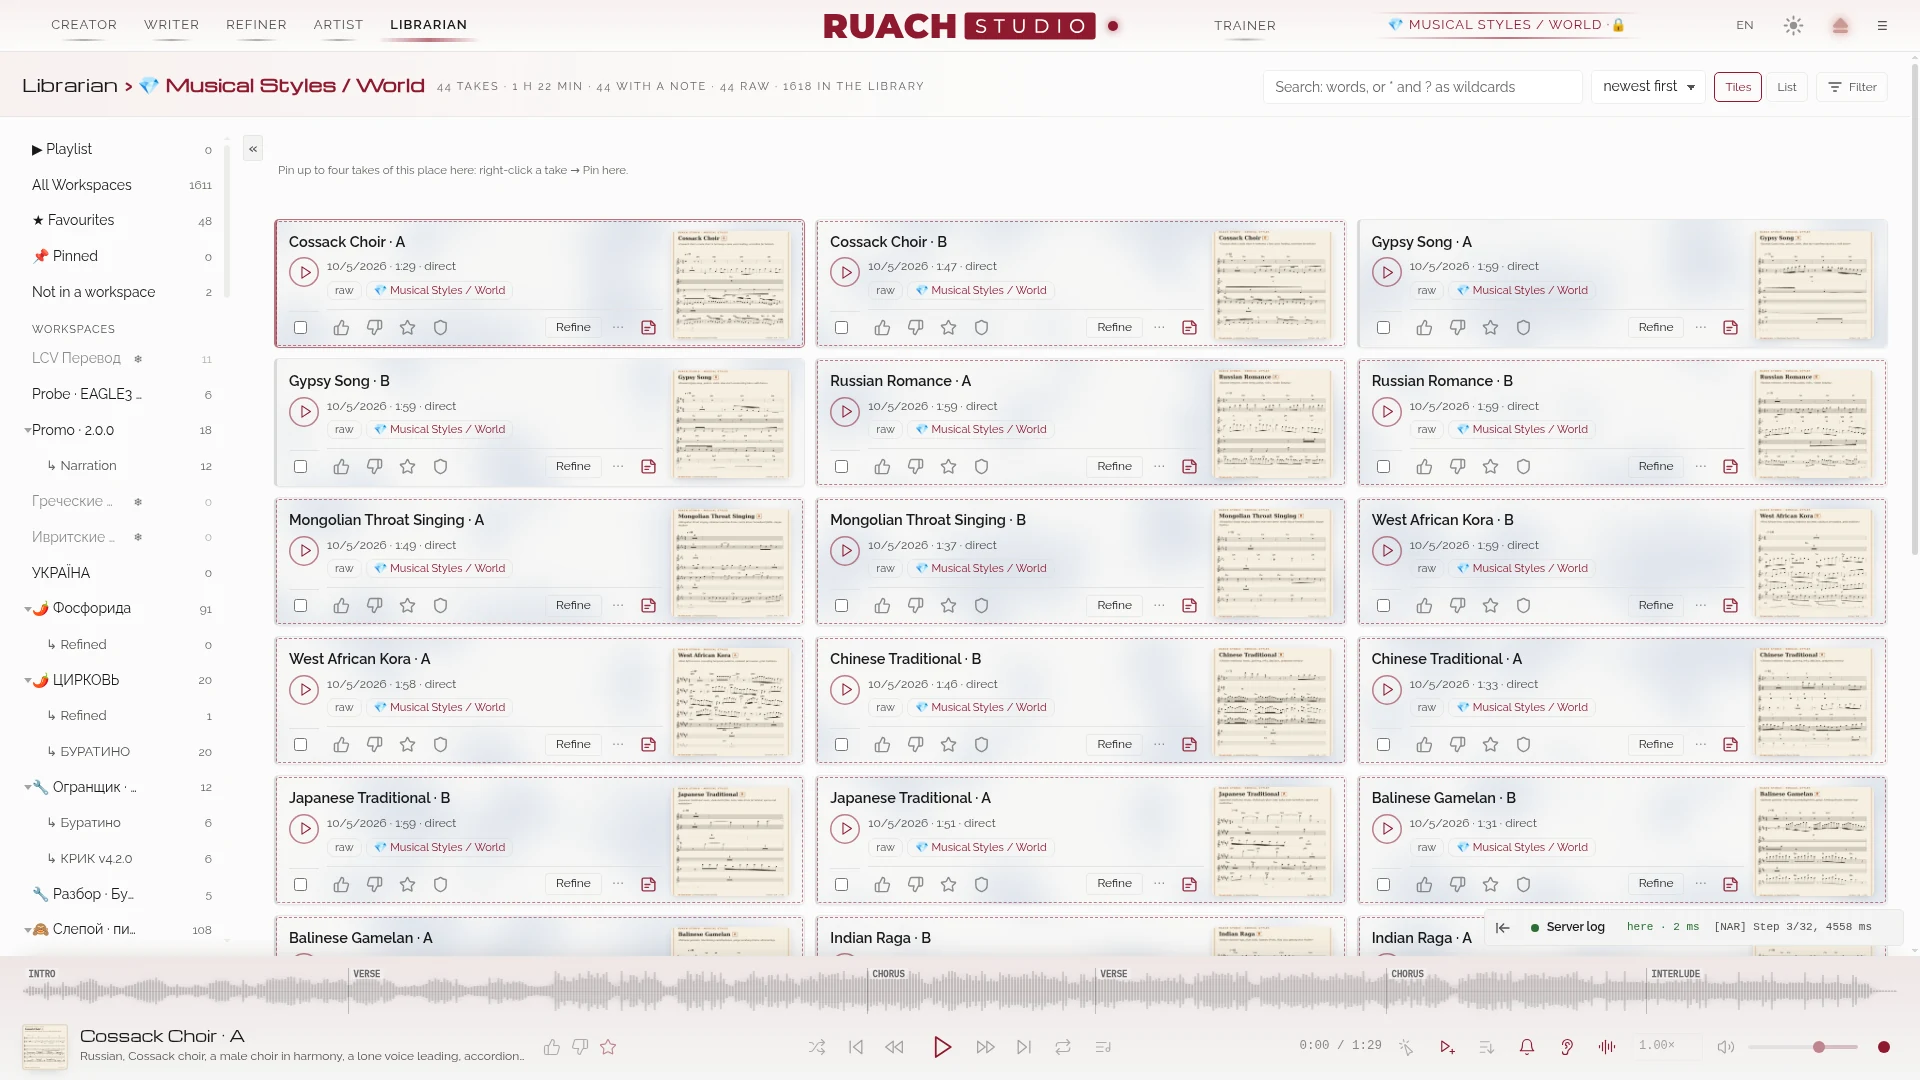
Ogni take negli spazi: cercato, votato, annotato, bloccato, con copertina, mandato alla tua DAW; un cestino che restituisce.
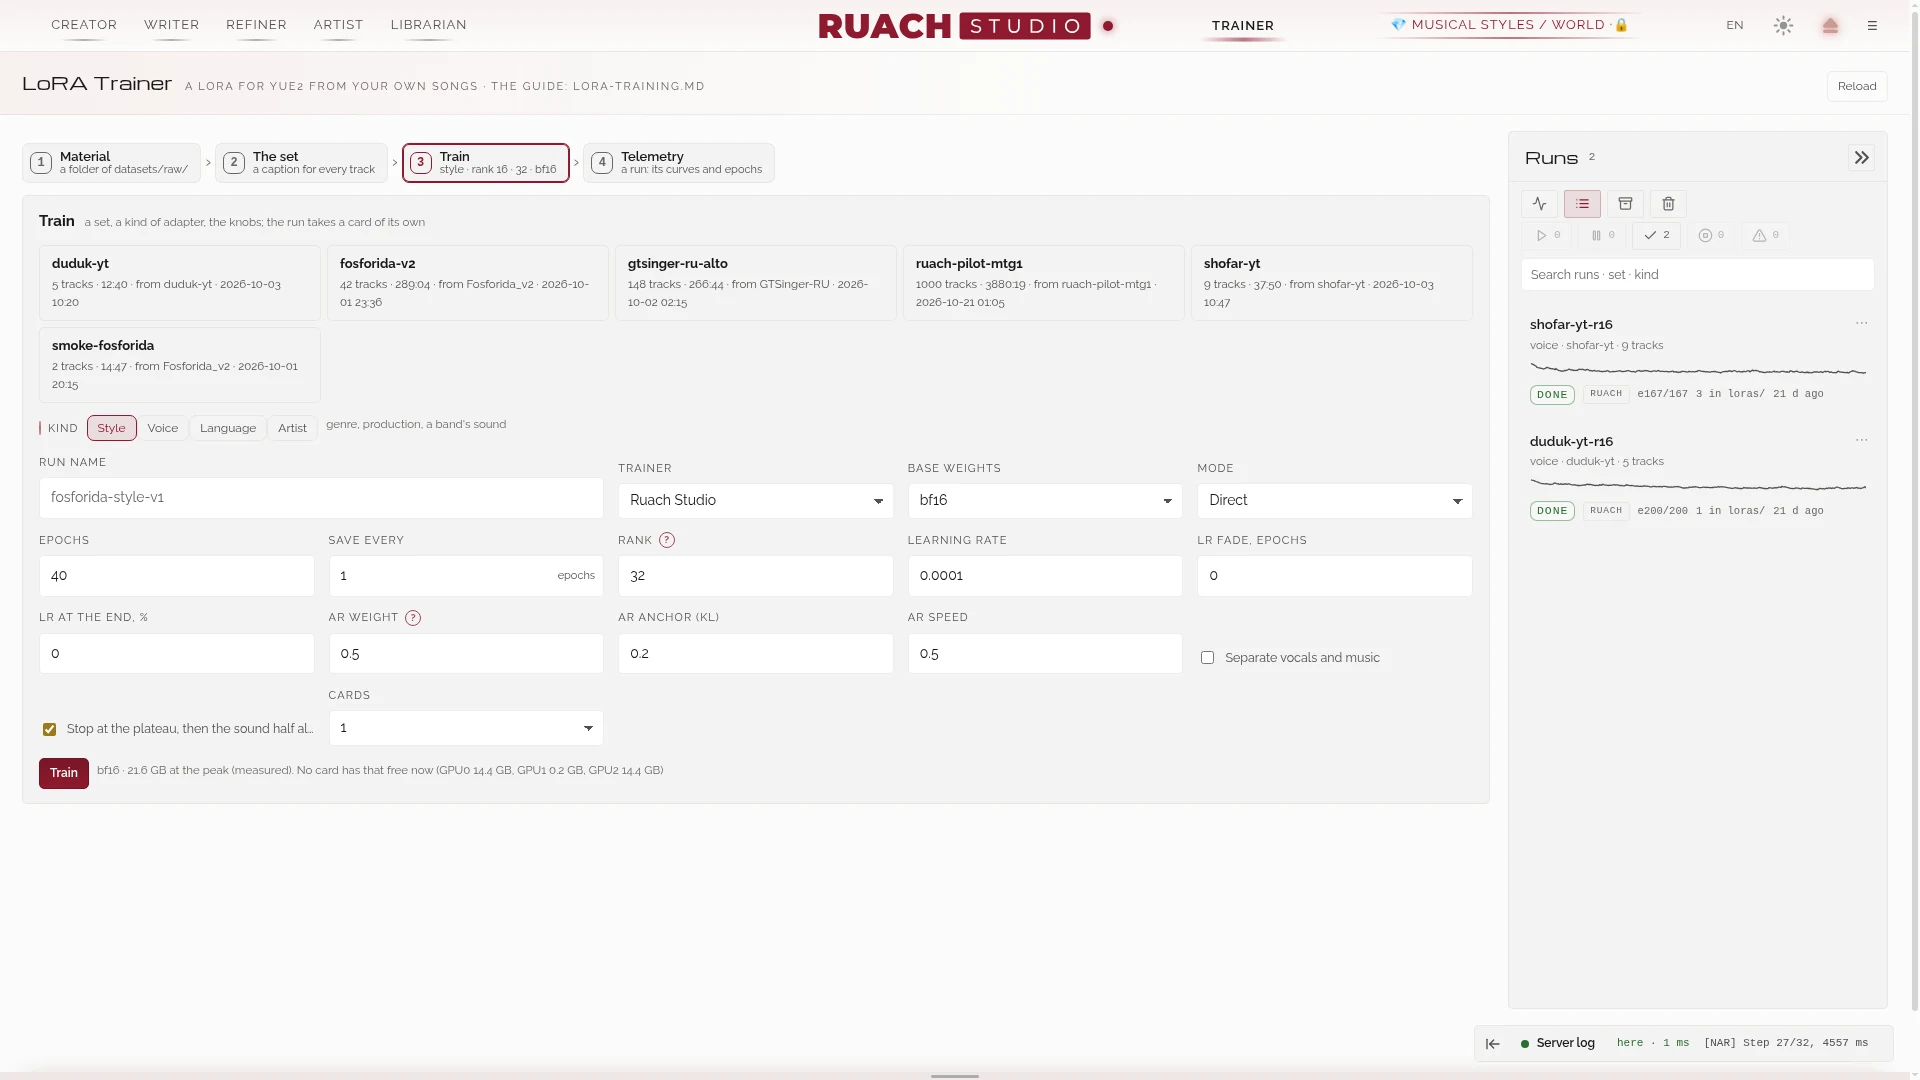
Adattatori dalle tue canzoni: il set, l'addestramento, le curve di entrambe le metà spiegate, le epoche da ascoltare per prime.
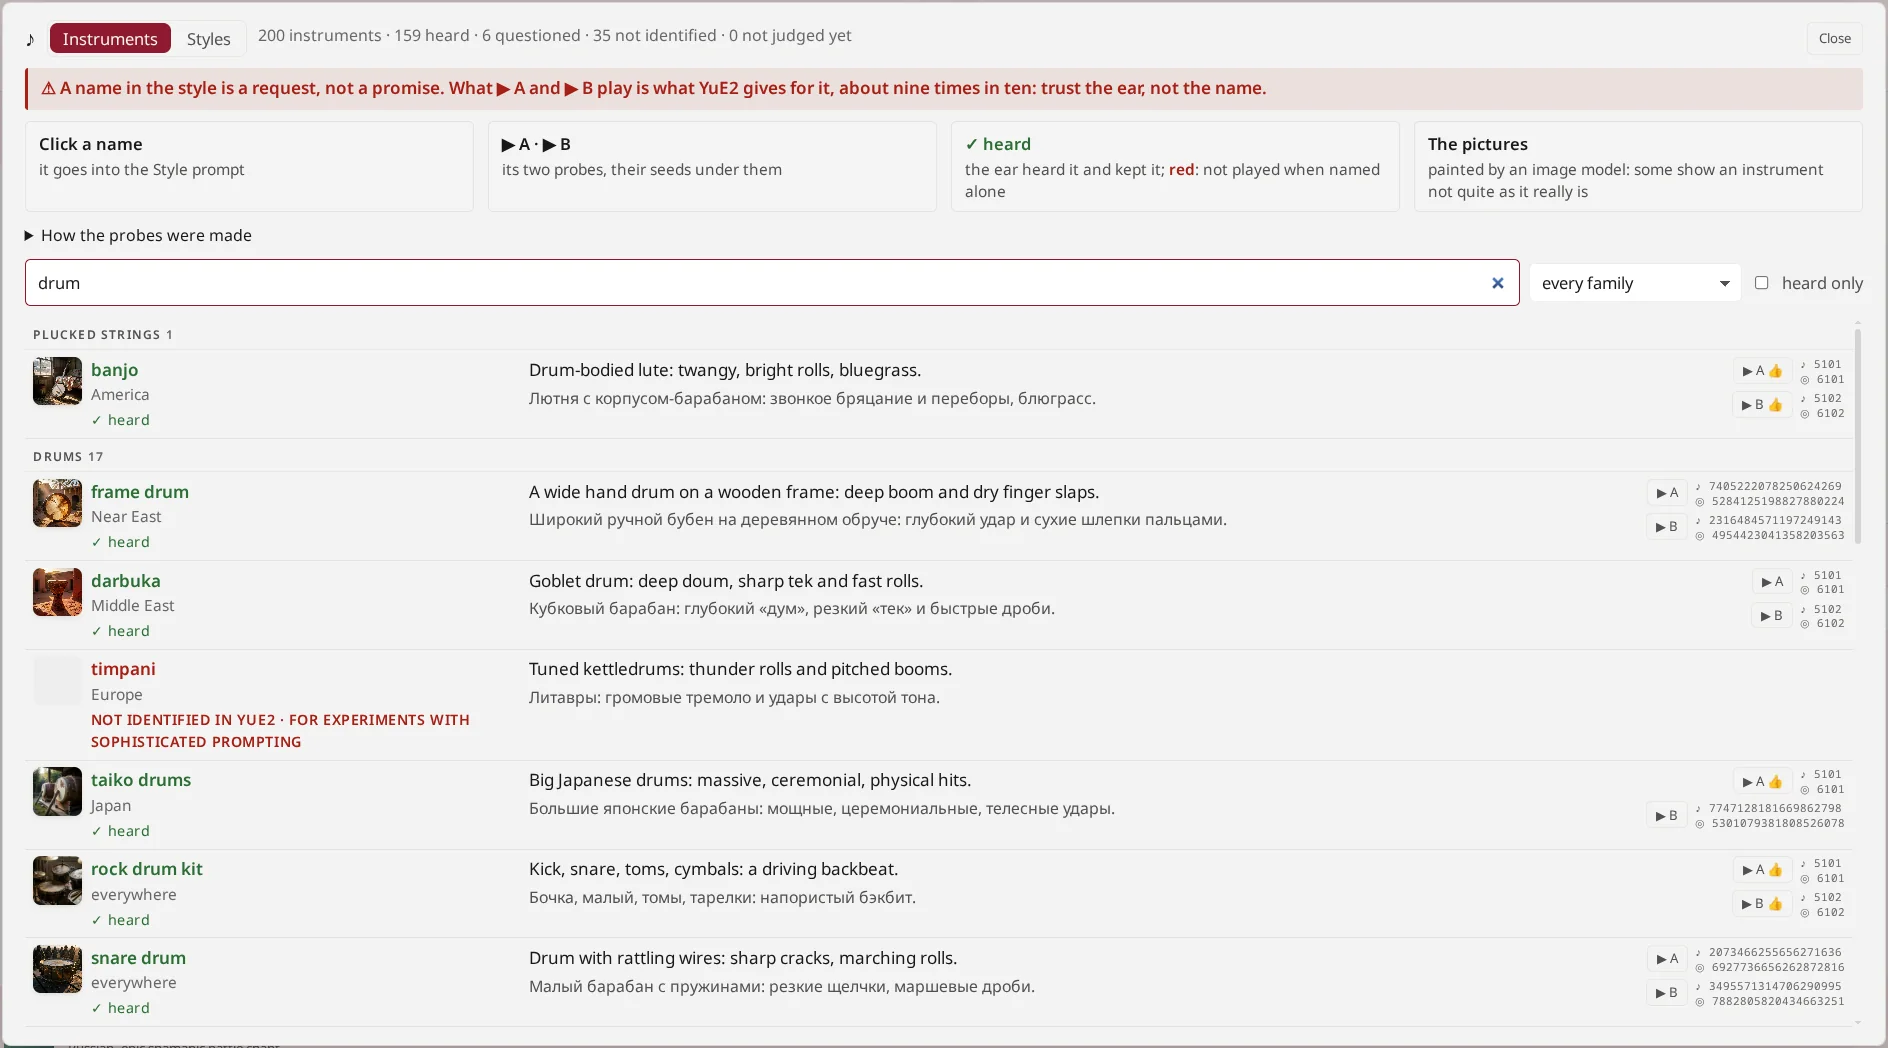
200 strumenti provati e giudicati a orecchio: cosa suona davvero YuE2, cosa suona debole e cosa non conosce.
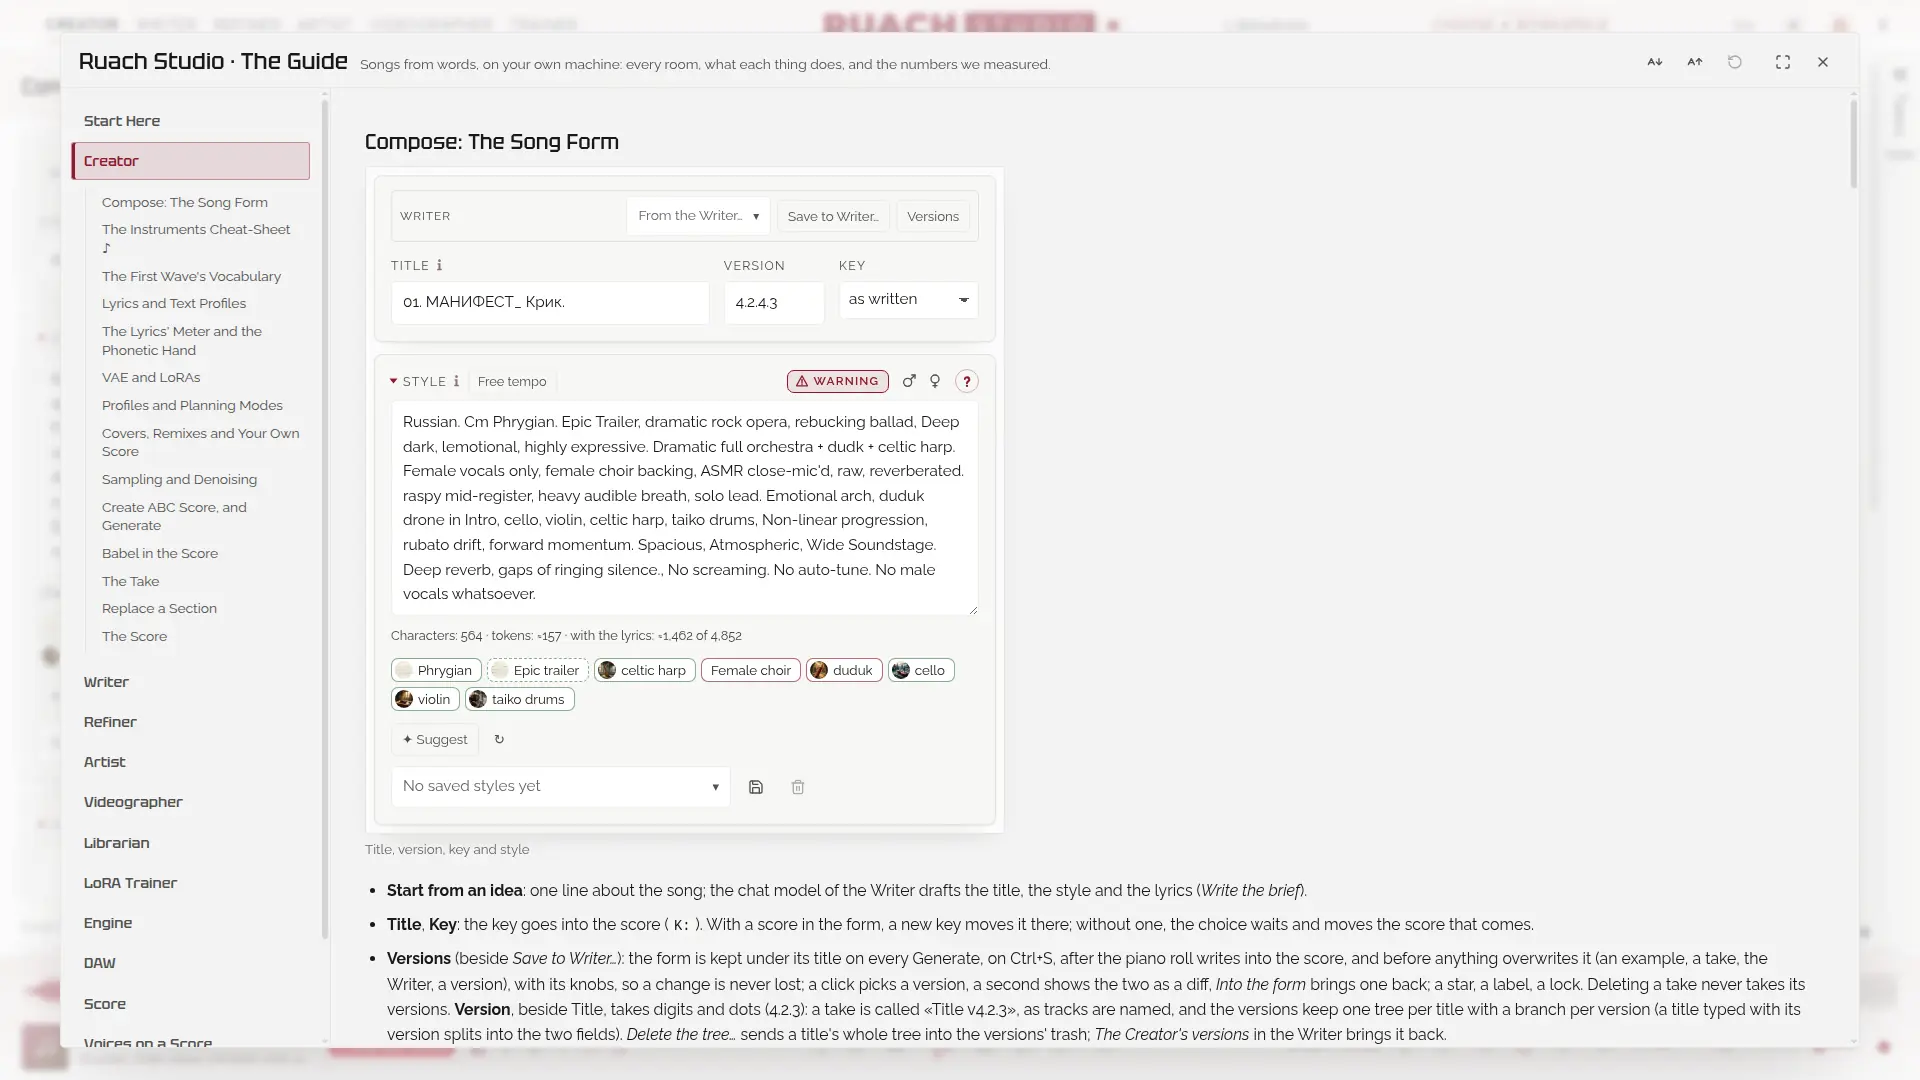
Tutto lo Studio spiegato dentro lo Studio, a un tasto di distanza: ogni stanza e ogni manopola, cosa fa e i numeri che abbiamo misurato, in dodici lingue. Fatto per la gioia di creare, non per ore di ricerche in rete.
Non l'ennesimo involucro di un modello: una stazione di lavoro attorno al modello, aperta fino all'osso, ogni modifica numerata e documentata.
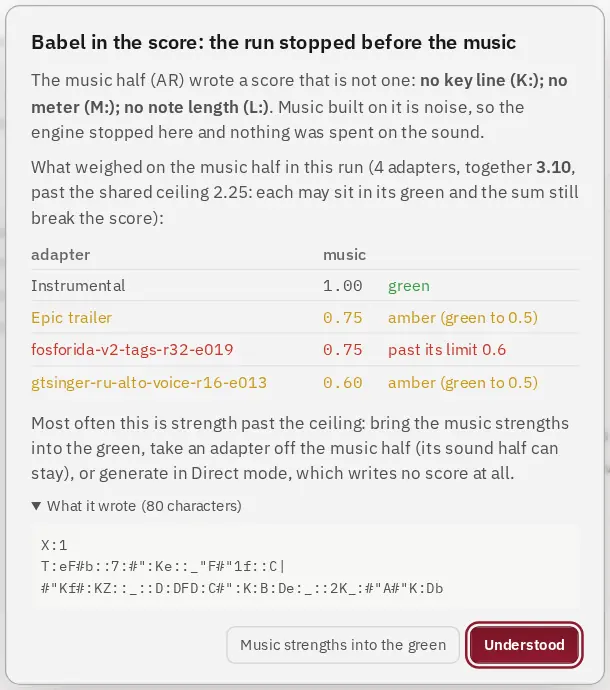
Quando la metà musicale scrive una partitura rotta (succede con adattatori spinti troppo in là), il motore ferma l'esecuzione prima che ci si costruisca sopra della musica, in pochi secondi, e dice perché: quali adattatori, quanto oltre i loro limiti, cosa è stato scritto.
Le intensità stanno su strade misurate; gli adattatori sovrapposti condividono un tetto misurato.
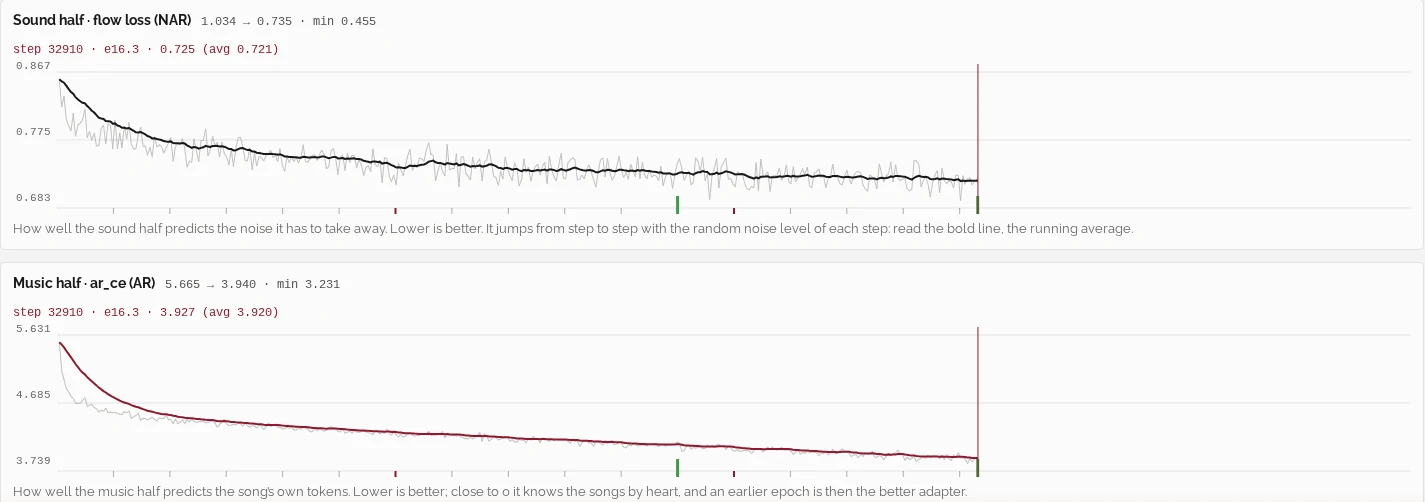
Lo Studio addestra da sé gli adattatori, su pesi bf16 non quantizzati. Rispetto ad AI-Toolkit di Ostris sullo stesso set, la loss della metà musicale coincide epoca per epoca entro 0.015.
Rank 16 su 148 canzoni: 2.1 s a passo in 12 GB. Rank 32 su 42 canzoni intere: 6.7 s a passo in 18 GB.
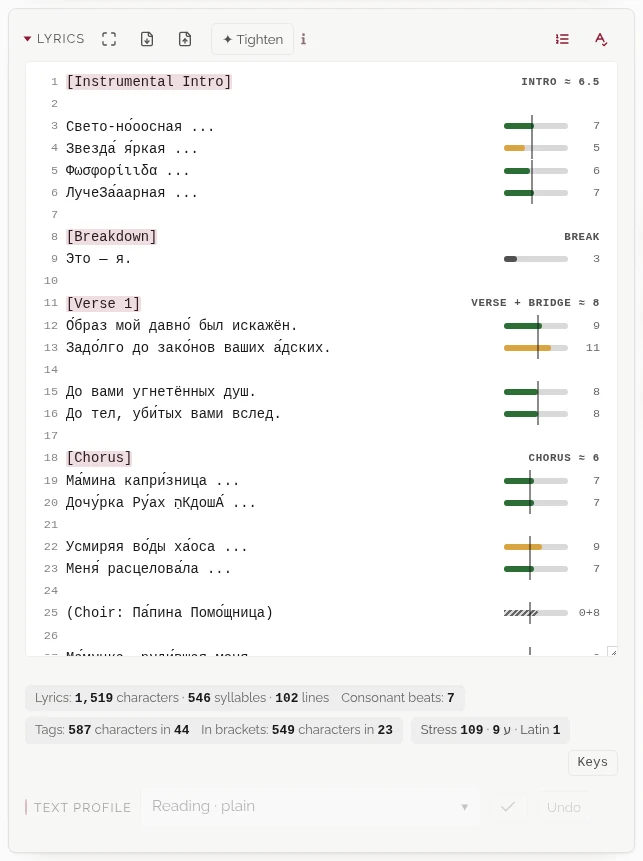
Accanto a ogni riga i suoi battiti, contro il righello della sua sezione: strofa e ponte un gruppo, pre-ritornello e ritornello i loro. Ogni sillaba si conta con le regole della sua lingua, e anche le consonanti che prendono un battito proprio contano; una pausa o un interludio dentro una sezione non apre un gruppo nuovo.
Scrivi «[» all'inizio di una riga e i tag di sezione vengono suggeriti, come un editor di codice suggerisce le parole. Gli accenti fuori posto si trovano; Ctrl+F cerca solo in quel riquadro.
Ogni settimana un video dice che qualche modello uccide SUNO. Questo non è un modello: è uno Studio intero intorno a uno, con un fine-tune suo. Dove vince e dove vince ancora SUNO, detto chiaramente.
| Ruach Studio (YuE2) | SUNO | |
|---|---|---|
| dove gira | la tua GPU; le tue canzoni, i testi e le impostazioni non la lasciano mai, e una volta installato non serve internet | nel loro cloud |
| quanto costa | la corrente: niente crediti, niente piani, niente limiti giornalieri | un abbonamento e dei crediti |
| il modello | YuE2 e il nostro fine-tune, RS-FW, il primo grande aperto: entrambe le metà riaddestrate su 32.633 brani, circa 1.800 ore, e pubblicata ogni parola che gli è stata detta | chiuso; su cosa ha imparato non è pubblicato |
| la partitura | scritta per prima, mostrata, modificabile, tua (ABC, MIDI); un piano roll su tutta la finestra | nascosta |
| il testo | un contatore accanto a ogni riga: i suoi battiti contro il righello della sezione, le sillabe con le regole di ogni lingua; i tag di sezione suggeriti mentre scrivi «[» | una casella di testo; il testo te lo scrivono su richiesta |
| ripetere un take | esattamente: due semi che conservi | no |
| guida (CFG) | due, separate: la spinta dello stile e la presa del testo, ognuna col suo CFG | una manopola Style Influence |
| sostituire una sezione | le sue parole cantate di nuovo tra le pause che trova l'orecchio, il resto della presa intatto fino al campione: la cucitura non si sente; più sezioni in un colpo | Replace Section: nelle nostre prove quasi mai utilizzabile, le cuciture si sentono e la voce cambia |
| la famiglia di una take | un albero genealogico: ogni taglio, versione e rigenerazione da cui una take è venuta, e ciò che ne è uscito, ciascuno con la sua forma d'onda | — |
| la libreria | spazi di lavoro con sezioni, sedici reazioni, note, protezione e un cestino che restituisce, una ricerca con caratteri jolly e «non», set alla cieca per un ascolto onesto, un volantino e un passaporto per ogni ripresa | spazi di lavoro, mi piace e playlist |
| confrontare le take | fino a dodici versioni in un solo lettore dallo stesso secondo, con il nome o alla cieca, allo stesso volume, allineate sul loro stesso suono | — |
| il tuo suono | addestra una LoRA sulle tue canzoni, nello Studio | nessun addestramento; le Personas riprendono la voce e lo stile di una canzone |
| ciò che YuE2 non sa suonare | un'orchestra MIDI sulla partitura stessa della take (set SFZ, e Pianoteq se ce l'hai) e la natura sotto la canzone: fuoco, pioggia, fiumi, uccelli | — |
| i tuoi strumenti | Il Costruttore di banchi fa delle registrazioni di uno strumento (un duduk, uno shofar) un banco SFZ: voci, grida e altri strumenti tolti a orecchio, le note trovate tasto per tasto, accordate e in loop; nella DAW suona sotto il brano come tappeto, come bordone nella sua tonalità o come linea MIDI | — |
| ogni picco intero | nessun clipping in uscita: le lunghe code di riverbero e il silenzio restano interi; l'albero genealogico mostra dove avrebbe morso il vecchio taglio | consegnato già masterizzato (nel nostro ring: −15,5 LUFS, −3,4 dBTP) |
| dopo il render | stem, debuzz, remaster, upscale, controllo del testo e un master su un volume obiettivo (Spotify −14, Apple Music −16, un CD −9), tutto in locale | stem e un remaster, nel cloud |
| un mixer | una DAW nel Rifinitore: tracce con EQ, gate, compressore, ampiezza e mandate, automazione, marker, il suono di una traccia come preset | Suno Studio, nel browser, nel piano più alto |
| vedere il suono | lo spettrogramma dell'intero take sopra il lettore, in tempo con la sua onda: le sezioni, la brillantezza e il volume, lo spettro e la nota sotto il puntatore | una forma d'onda |
| immagini e video | l'Artista dipinge la copertina, il 16:9 e il 9:16 dalle tue parole; il Videografo pianifica il videoclip, ne dipinge i fotogrammi chiave e gli dà un look (LUT 3D, grana, vignettatura) | un'immagine di copertina |
| in una DAW | un progetto REAPER con la partitura, le sezioni e il testo (sperimentale) | stem audio |
| script e agenti | un'API (OpenAPI 3.1) e un server MCP, sulla tua macchina e nella tua rete | nessuna API pubblica |
| provenienza | Content Credentials (C2PA) firmate in ogni download, a tuo nome, se vuoi | — |
| il codice | aperto (AGPL), ogni modifica numerata e documentata | chiuso |
| l'interfaccia | sette stanze in una pagina, in dodici lingue; un suggerimento su ogni controllo e una guida in ogni stanza; il lettore e le riprese in ogni stanza; tasti per ciò che fai spesso; installabile come app | un'app web e app per dispositivi mobili |
| rifinitura pronta all'uso | meno: un mix può ronzare (l'antironzio aiuta), il testo può scivolare (la verifica del testo trova dove), alcuni strumenti YuE2 li suona deboli o non li suona affatto (una LoRA li insegna) | più |
| cosa serve | una GPU NVIDIA (24 GB per tutto a piena precisione; 12–16 GB e 8 GB con copie più piccole), Linux, 34–41 GB di disco | un browser |
«—»: non l'abbiamo trovato, in più di sei mesi sui piani a pagamento di SUNO. SUNO cambia in fretta; la tabella è di novembre 2026.
Venti schede, ciascuna con una riga di stile e un testo, inviate invariate a ogni parte. SUNO v6 e Musicful V3 come li consegnano i loro servizi; i nostri grezzi dal motore, cantati di nuovo a novembre con ogni picco intero: lo YuE2-3B di serie, il nostro fine-tune RS-FW in tre dei suoi salvataggi e RS-TW 2.0. Qui ogni file suona allo stesso volume, così nessuno vince perché è più forte. Premi un nome per ascoltare; un altro nome sulla stessa scheda prosegue dallo stesso secondo.
RS-TW 2.0 è il nostro secondo fine-tune: la sua epoca 2.0, fusa sopra RS-FW 2.4 a due intensità: ×0.75, l'equilibrio sicuro, e ×0.9, più tettonica, senza garanzia di stabilità. I nostri sono due seed per scheda, entrambi qui, nessuno scelto al posto dell'altro: l'interruttore nel lettore dà il seed 1 o il seed 2 e lo mantiene da una scheda all'altra, e le medie della tabella li contano entrambi.
| misurato grezzo, le medie | SUNO v6 | Musicful V3 | YuE2‑3B | Ruach Studio (RS-…): fine-tune di YuE2 3B | ||||
|---|---|---|---|---|---|---|---|---|
| FW 0.7 | FW 1.5 | FW 2.4 | TW 2.0 ×0.75 | TW 2.0 ×0.9 | ||||
| errore di Whisper sul testo, sul mix, % ↧ | 23.1 | 19.5 | 20.0 | 19.9 | 24.8 | 21.8 | 23.0 | 26.1 |
| errore di Whisper sul testo, sulla voce separata, % ↧ | 27.4 | 18.9 | 21.6 | 24.8 | 31.1 | 28.8 | 29.5 | 33.7 |
| sabbia nel silenzio, 6–16 kHz, dB ↧ | -15.7 | -14.8 | -17.6 | -18.1 | -17.3 | -17.3 | -17.9 | -17.5 |
| toni fissi vaganti ↧ | 2.2 | 1.9 | 4.33 | 2.0 | 2.27 | 2.23 | 2.15 | 1.6 |
| il ronzio a 25 Hz del decodificatore sugli acuti, dB ↧ | 8.3 | 8.0 | 11.4 | 11.6 | 11.6 | 11.5 | 11.6 | 11.1 |
| clic ↧ | 33.4 | 33.8 | 27.7 | 31.9 | 35.3 | 34.7 | 34.5 | 32.8 |
| tratti di clipping ↧ | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| rumore di fondo, il decimo più silenzioso, dBFS ↧ | -26.6 | -25.2 | -27.7 | -27.6 | -27.0 | -26.6 | -27.1 | -28.2 |
| il limite superiore dello spettro, kHz ↥ | 17.9 | 15.3 | 15.8 | 14.8 | 14.9 | 15.1 | 15.2 | 14.7 |
| roll-off al 95%, kHz ↥ | 2.5 | 2.6 | 2.2 | 2.1 | 2.2 | 2.0 | 1.7 | 1.7 |
| quota di sub 20–60 Hz, dB ↥ | -8.6 | -10.2 | -10.0 | -9.6 | -9.9 | -10.4 | -10.0 | -9.8 |
| loudness così come consegnata, LUFS → −14 | -15.5 | -14.3 | -14.5 | -14.7 | -14.7 | -14.4 | -14.6 | -14.8 |
| true peak così come consegnato, dBTP → −1,0 | -3.4 | -0.5 | -0.2 | -0.2 | -0.1 | -0.2 | -0.3 | -0.1 |
| quota di bassi 60–150 Hz, dB ↥ | -6.0 | -5.6 | -4.3 | -4.8 | -4.5 | -4.5 | -4.4 | -4.8 |
| quota di presenza 2–5 kHz, dB ↥ | -17.1 | -16.6 | -16.0 | -16.3 | -16.2 | -16.2 | -17.3 | -16.9 |
| fattore di cresta, dB ↥ | 14.4 | 15.7 | 16.5 | 16.5 | 16.6 | 16.3 | 16.2 | 16.6 |
| gamma di loudness, LU ↥ | 5.9 | 6.2 | 7.1 | 6.6 | 6.5 | 6.4 | 6.6 | 7.1 |
| dispersione della loudness p95−p10, dB ↥ | 9.4 | 9.0 | 11.5 | 10.8 | 10.4 | 10.3 | 10.8 | 11.7 |
| dispersione della banda bassa p95−p10, dB ↥ | 23.3 | 20.0 | 21.9 | 21.1 | 20.6 | 19.7 | 22.0 | 22.6 |
| correlazione stereo sui medi ↥ | 0.67 | 0.69 | 0.75 | 0.77 | 0.73 | 0.74 | 0.77 | 0.76 |
| durata, s ↥ | 156.8 | 154.5 | 148.6 | 148.1 | 154.8 | 151.9 | 152.8 | 149.7 |
primo · secondo · terzo degli otto in ogni riga, il primo anche in grassetto; ↥ più alto è meglio, ↧ più basso è meglio, → meglio il più vicino al valore indicato, il true peak da sotto. Le celle con lo stesso numero hanno lo stesso colore.
Ogni parte la ascolta Whisper large-v3 su una RTX 3090, il mix e la voce allo stesso modo: la prima riga di Whisper sul mix, la seconda sulla voce separata, dove BS-Roformer separa dalla musica tutte le voci di ogni brano, la principale, le voci di supporto e il coro insieme, mai la sola principale. Senza la musica Whisper a volte perde versi interi e scrive nelle pause parole che nessuno ha cantato, su ogni lato, perciò le due righe vanno lette insieme.
FW e TW sono i nomi in codice dei nostri due fine-tune di YuE2 3B: First Wave e Tsunami Wave. Tsunami Wave è stato addestrato su 109.250 brani, circa 6.650 ore: il 66,7% delle ore strumentale, il 31,6% cantato, l'1,8% parlato. Le voci sono in inglese (7,0% delle ore), russo (5,8%), ebraico (1,7%), greco e ucraino (0,6% ciascuno), francese e spagnolo (0,5% ciascuno), portoghese (0,3%), italiano (0,2%) e altre quattordici lingue sotto lo 0,1% ciascuna; nel 15,9% delle ore si sente una voce la cui lingua non è stata identificata.
I loro arrivano masterizzati, i nostri grezzi, al livello proprio del decoder, con ogni picco intero: il volume è lasciato al master, compito del Rifinitore dello Studio. Altri seed e altri prompt suonano diversi da ogni parte; il ring mostra la qualità e la dispersione, non una classifica finale. La tabella intera e come è stata misurata: la scheda del modello.
Ogni parola che i nostri due fine-tune hanno ricevuto, contata e da cercare: i 109.250 brani di addestramento di Tsunami Wave e i 32.633 della Prima Onda prima di lui. Generi, strumenti, voce, le parole d'emozione date dall'audio stesso, tonalità e BPM, e le chiavi delle partiture. Pochi fine-tune pubblicano ciò che è stato detto al loro modello.
Il ring misurato invece che ascoltato: 280 brani, 40 per ciascuna delle nostre sei parti, 20 di SUNO v6 e 20 di Musicful V3. Ogni brano è stato prima portato a −14 LUFS, perché il volume non vinca nulla, e ogni curva è il livello del brano, banda per banda, rispetto a tutta la sua potenza: si confronta solo la forma. I nostri sono l'uscita grezza del motore, i loro arrivano masterizzati, quindi parte delle differenze qui sotto è del master.
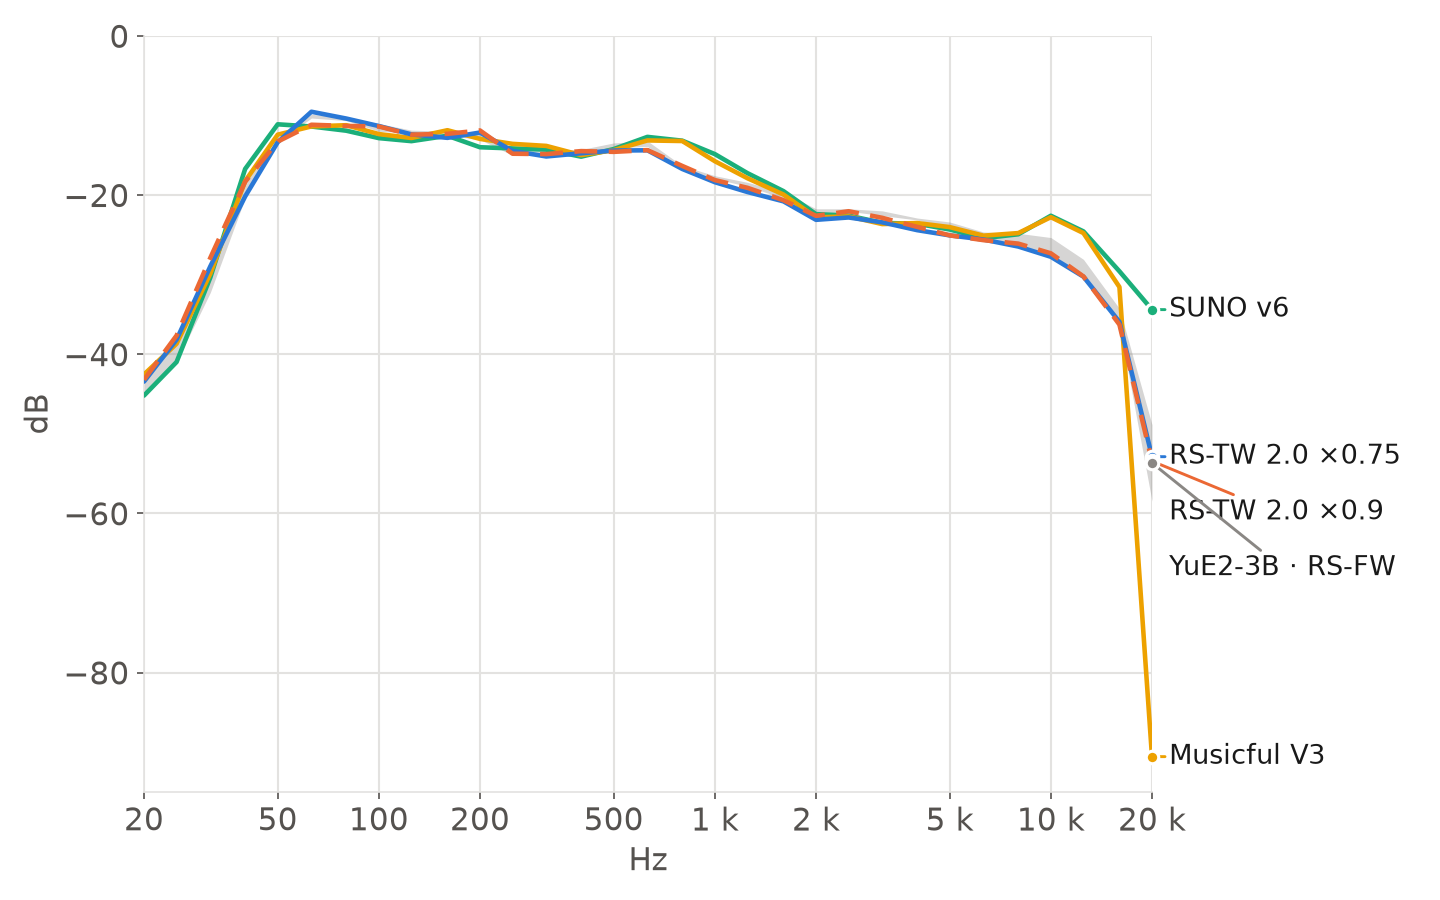
Da 100 Hz a 10 kHz le curve medie di tutte e otto le parti restano entro 5,2 dB l'una dall'altra. Sopra i 16 kHz si separano. Musicful V3 non tiene nulla sopra i 16 kHz in 38 dei suoi 40 brani: a 20 kHz la sua media sta a −90,6 dB, un muro dove gli altri hanno un pendio. SUNO v6 è quello che lassù conserva di più, −31,0 dB in 16–20 kHz; i nostri stanno tra −39,3 e −42,3 dB, e anche loro ogni tanto si fermano a 16 kHz, in 1–6 brani su 40, più spesso RS-TW 2.0 ×0.9.
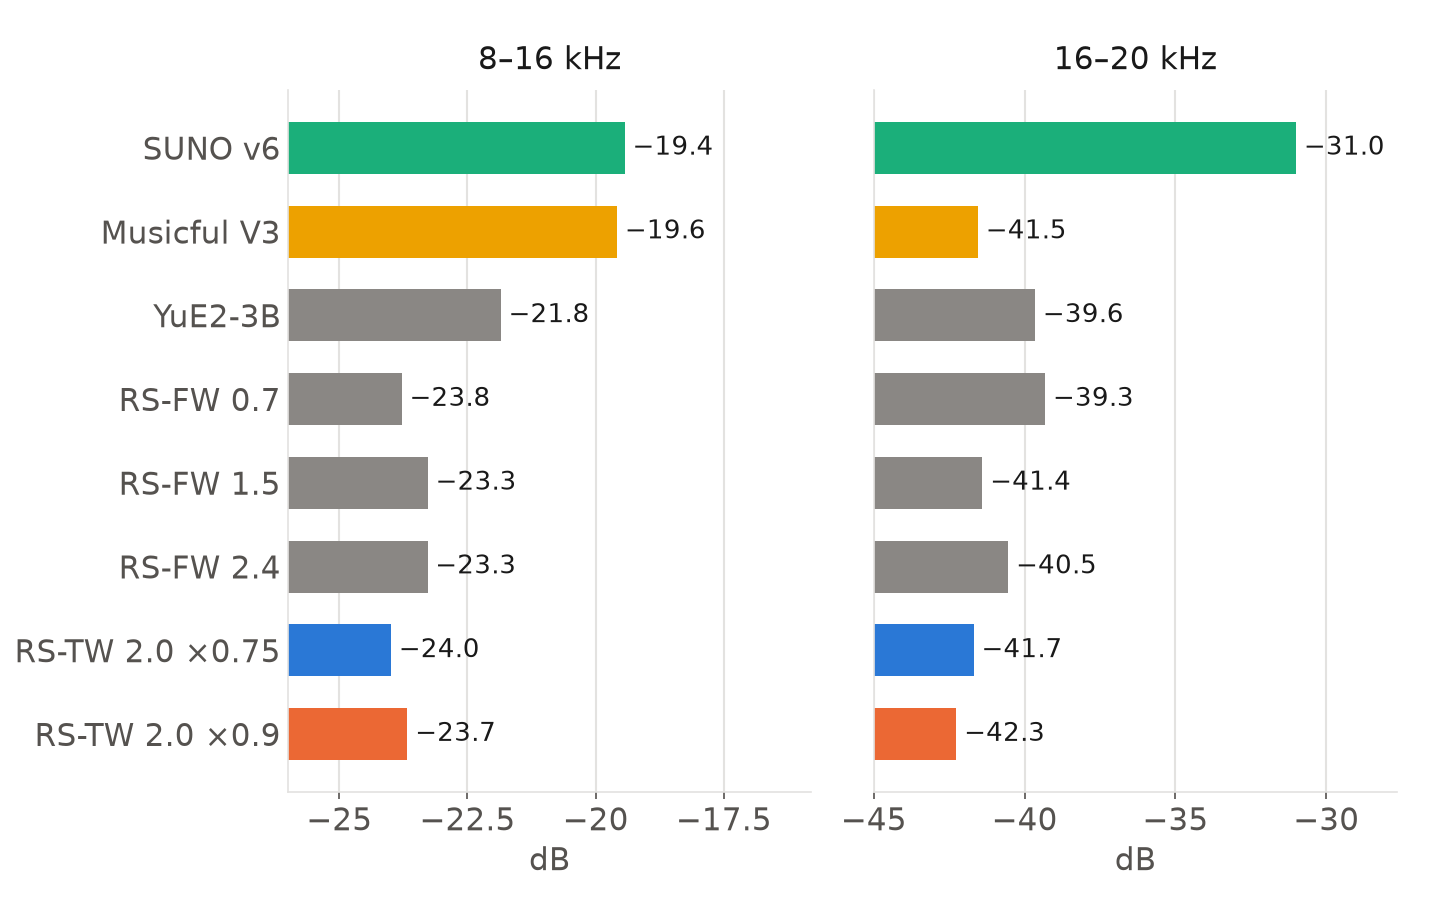
Nella banda dell'aria, 8–16 kHz, SUNO v6 e Musicful V3 stanno a −19,4 e −19,6 dB della potenza dei loro brani, le nostre sei parti tra −21,8 e −24,0 dB. Un master di solito alza l'aria, e i nostri non ne hanno avuto alcuno: nello Studio è compito del Rifinitore, una volta cantata la canzone.
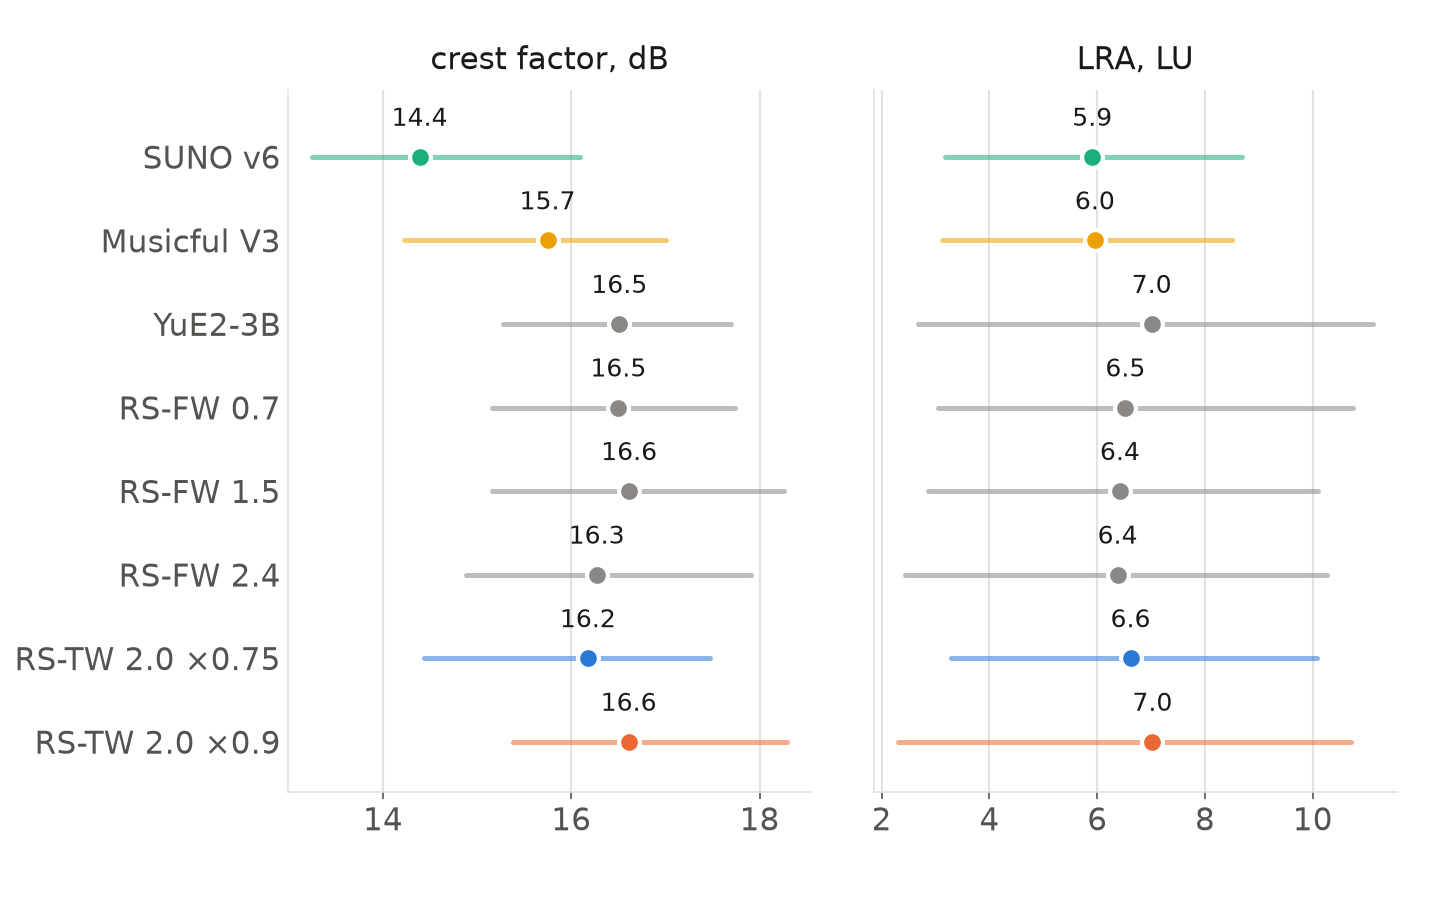
Fattore di cresta, il picco sopra la media: SUNO v6 14,4 dB, Musicful V3 15,7 dB, i nostri da 16,2 a 16,6 dB. Gamma di loudness: i loro 5,9 e 6,0 LU, i nostri da 6,4 a 7,0 LU. RS-TW 2.0 ×0.9 è il più ampio dei nostri fine-tune, 16,6 dB e 7,0 LU, ampio quanto lo YuE2-3B di serie (16,5 dB, 7,0 LU): la sua tettonica, in numeri. ×0.75 è il più raccolto, 16,2 dB e 6,6 LU.
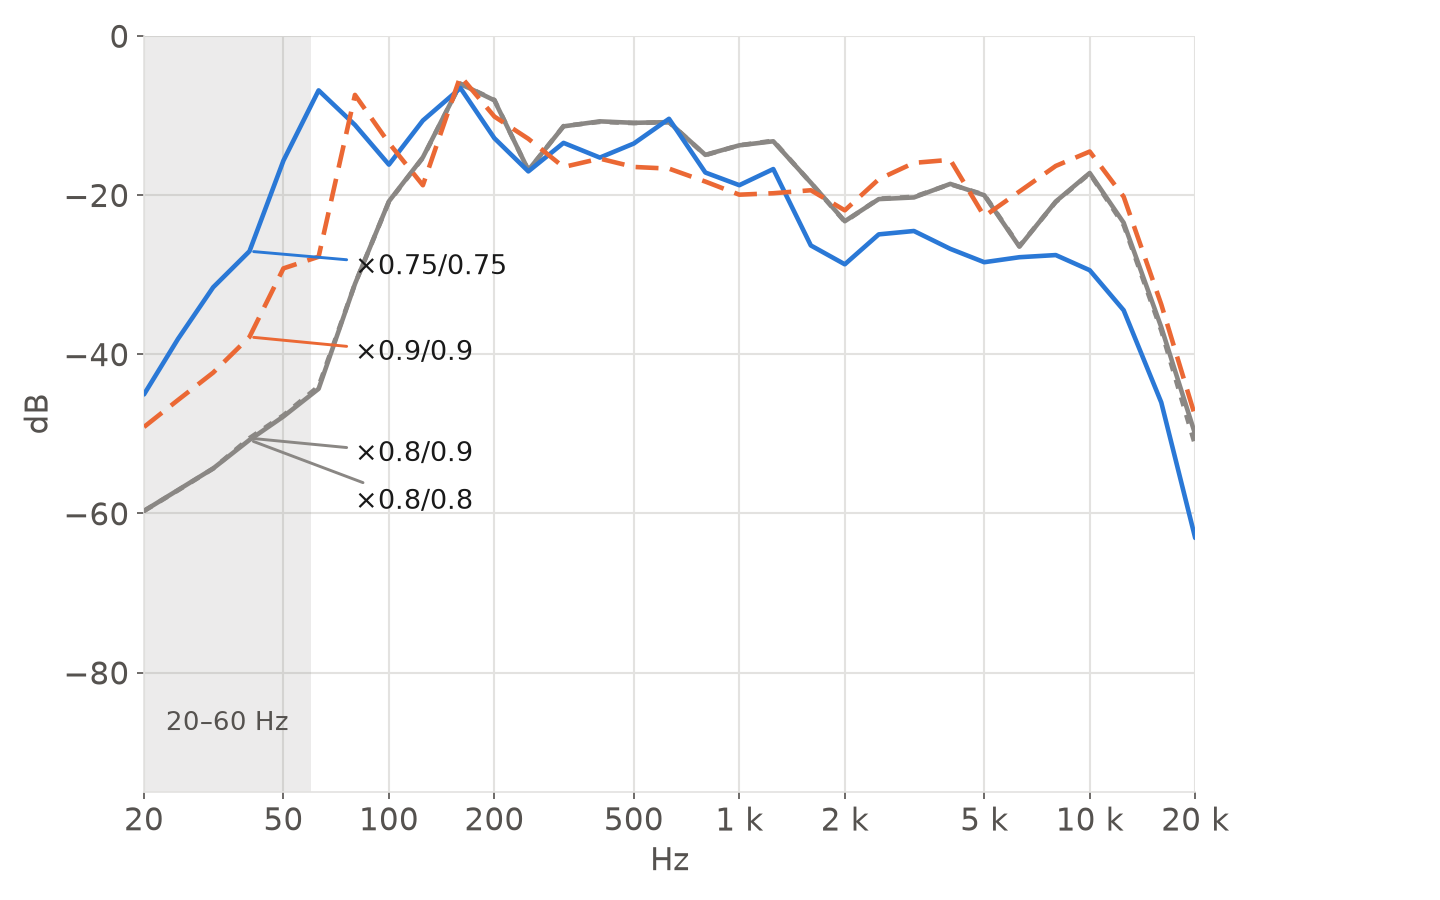
Il set alla cieca: dodici schede cantate a quattro intensità di Tsunami Wave sopra RS-FW 2.4, con lo stesso seed a ogni intensità. Sul Salmo 22 in greco, il passo da ×0.75/0.75 a ×0.8/0.8 ha tolto 36 dB al sub-basso, 20–60 Hz, da −7,9 a −44,3 dB: il pavimento è sparito da sotto la canzone. Sulle dodici schede l'oscillazione è più dolce, il sub-basso a −8,5 dB con ×0.75/0.75 e tra −10,4 e −11,0 dB con le altre tre, e ×0.75/0.75 è il più vicino alla curva mediana del ring stesso su 6 schede su 12, a una distanza media di 4,1 dB contro 4,8–5,2 dB. Per questo ×0.75 diventa il modello predefinito dello Studio nella 2.0.6, e ×0.9 quello che non promette stabilità.
Misurato con il nostro codice sulla CPU: bande di terzo d'ottava da uno spettro di Welch, loudness e la sua gamma secondo ITU-R BS.1770-4 ed EBU Tech 3342. Ogni immagine si apre più grande con un clic.
I 280 brani del ring, misurati nella loro larghezza. In ciascuna di quattro bande il segnale laterale, metà della differenza dei due canali, è messo a confronto con il centrale, metà della loro somma: più il laterale sta alto sul centrale in dB, più larga suona la banda, e un brano in mono non avrebbe alcun laterale. Il panorama è quanto oscilla la differenza di livello tra il canale sinistro e il destro lungo un brano, dal suo 5° al suo 95° percentile, in dB. Ogni numero è la mediana dei brani di una parte, 20 per SUNO v6 e per Musicful V3, 40 per ciascuna delle nostre. Più largo qui non è meglio, solo più largo: questa tabella non ha posizioni.
Il laterale sul centrale in quattro bande, dB, le mediane dei brani di ogni parte: più in alto, più largo.
| misurato grezzo, le mediane | laterale sul centrale, dB | panorama, dB | |||
|---|---|---|---|---|---|
| bassi 20–200 Hz | medi 0,2–2 kHz | acuti 2–8 kHz | aria 8–20 kHz | ||
| SUNO v6 | −12.5 | −7.0 | −6.8 | −9.6 | 6.4 |
| Musicful V3 | −13.0 | −7.2 | −5.9 | −7.9 | 6.6 |
| YuE2-3B | −17.4 | −8.2 | −7.9 | −10.6 | 6.4 |
| RS-FW 0.7 | −17.2 | −8.5 | −7.3 | −10.9 | 5.9 |
| RS-FW 1.5 | −17.4 | −7.5 | −6.6 | −10.2 | 6.3 |
| RS-FW 2.4 | −16.5 | −8.0 | −7.9 | −11.2 | 6.4 |
| RS-TW 2.0 ×0.75 | −19.0 | −8.1 | −7.9 | −11.6 | 6.0 |
| RS-TW 2.0 ×0.9 | −20.1 | −8.9 | −8.2 | −12.0 | 5.9 |
Le nostre fusioni tengono i medi e gli acuti dove li ha lo YuE2-3B di serie, mai più lontano di 1,3 dB. RS-TW 2.0 è un po' più stretto agli estremi: ×0.75 di 1,6 dB nei bassi, 1,0 dB nell'aria e 0,4 dB nel panorama, ×0.9 di 2,7, 1,4 e 0,5 dB. SUNO v6 e Musicful V3 aprono i bassi 4,9 e 4,4 dB più dello YuE2-3B di serie.
All'orecchio di Viktor gli estremi più stretti di RS-TW 2.0 suonano più saldi, non come stereo perduto: lo YuE2-3B di serie spesso parcheggia una chitarra in un solo canale per 15–20 secondi.
Misurato con il nostro codice sulla CPU: uno spettro a breve termine di 4096 punti ogni 50 ms sui primi 240 secondi di ogni brano, il centrale e il laterale come (L+R)/2 e (L−R)/2, il panorama dalla differenza di livello dei canali in 200 Hz – 8 kHz, nei momenti entro 40 dB dal più forte del brano.
fetch-models.sh); i modelli dell'Artista altri 39–43 GB, i set 💎 5,6 GB, ognuno solo quando lo chiediNon su GPU gratuite nel cloud. Ruach Studio non gira su Google Colab, Kaggle o qualsiasi GPU gratuita da notebook, quindi non perderci una serata: è uno Studio intero, non un notebook. Compila il suo motore C++/CUDA sulla macchina dove vive, tiene accanto un server e un laboratorio di servizi Python, e occupa circa 34–41 GB di disco (74–84 GB con l'Artista). La scheda, la memoria, il disco che si cancella e il limite di ore di una sessione gratuita non lo reggono. Vuole il tuo computer con Linux, o un server che affitti e tieni, con una scheda NVIDIA: 24 GB per tutto, 16 GB con le copie più piccole del modello.
Misurato file per file sulle liste fissate dei repository dello Studio e sul disco di un'installazione nuova (1 GB = 10⁹ byte). L'installazione porta il Creatore, il Bibliotecario e la catena del Rifinitore; ogni altra stanza arriva solo quando la chiedi, da Motore → Modelli e LoRA → Per stanza, che prima misura lo spazio libero e non scarica ciò che non ci starebbe.
| scheda da 24 GB | scheda da 12–16 GB | scheda da 8 GB | |
|---|---|---|---|
| il programma e il suo motore, compilato qui (si scaricano 0,2 GB) | 0,9 GB | 0,9 GB | 0,9 GB |
| i suoi due Python, con PyTorch per CUDA 12.8 in ciascuno (si scaricano 8,7 GB) | 16,5 GB | 16,5 GB | 16,5 GB |
| YuE2 e il fine-tune di Ruach Studio, alla quantizzazione della scheda | 14,9 GB | 8,2 GB | 8,2 GB |
| il resto: altri due decodificatori, il trascrittore, Whisper, i modelli degli stem, UniverSR e Apollo-vocal, i LoRA | 8,8 GB | 8,8 GB | 8,8 GB |
| l'installazione | 41,1 GB | 34,4 GB | 34,4 GB |
| + Scrittore: il suo modello linguistico con llama.cpp | 7,4 GB | 7,4 GB | 6,2 GB |
| + Rifinitore: MuScriptor e FlashSR | 6,1 GB | 6,1 GB | 6,1 GB |
| + Artista: i suoi aiutanti e Qwen-Image 2512 (Q6 con 24 GB, Q4 sotto) | 42,9 GB | 39,3 GB | 39,3 GB |
| + Videografo: MiniMax H3 e SeedVR2 | 86,3 GB | servono 24 GB | servono 24 GB |
| + Addestratore LoRA: la sua base e l'ascoltatore di stile | 20,2 GB | 16,3 GB | 12,9 GB |
| tutte le stanze | 204,0 GB | 103,5 GB | 98,9 GB |
Solo quando lo chiedi per nome: gli altri motori del suono (le fusioni IRA, IRAE e RS-FW, da 35 a 86 GB secondo la quantizzazione), gli adattatori dell'Artista (7,5 GB) e i fine-tune (20,4 GB ciascuno), tutti i livelli di MiniMax H3 (201 GB) o BF16 (478 GB), i set 💎 (5,6 GB). Non contati: il driver NVIDIA e il CUDA toolkit, Pianoteq (lo compri tu), le tue take.
La 2.0.5 è lo Studio in cui facciamo ogni giorno le nostre canzoni. Questi sono i pezzi più grandi in arrivo, per la 2.1.0 e oltre.
Viktor Zhuromskyy, the author of Ruach Studio, does not publish it for the hype. He made it for himself. After more than half a year of struggling with Suno on paid plans, and of searching for a model worth working with (ACE-Step, MiniMax and others), he set out to build an audio studio of his own, on his own machine. He settled on YuE2: of all the open models, it is the best value and the most refined.
He did not knock the Studio together just to have something that runs. He built it his own way, because his creative work is his own too, refined and one of a kind: his translations, his interlinear texts and much more. He fit into it as much as he could, polished the interface as far as he could, and made creating in it not poking and clicking among crutches and potholes, but as productive as it can be.
That is the whole story. Now the Studio is yours as well.
Виктор Журомский, автор Ruach Studio, публикует её не ради хайпа. Он делал её для себя. После более чем полугода мучений с Suno на платных тарифах и поисков достойной модели (ACE-Step, MiniMax и другие) он взялся построить собственную аудиостудию, на своей машине. Выбор пал на YuE2: из всех открытых моделей она самая рентабельная и самая изысканная.
Студию он делал не тяп-ляп, лишь бы работало, а в своём стиле, потому что и творчество у него своё, изысканное и неповторимое: собственные переводы, подстрочники и многое другое. Он постарался вместить в неё максимум, отполировать интерфейс до блеска и сделать творчество в Студии не тыканьем и кликаньем среди костылей и ям, а по-настоящему продуктивным.
Вот и вся история. Теперь эта Студия и ваша.
Віктор Журомський, автор Ruach Studio, публікує її не заради хайпу. Він творив її для себе. Після понад пів року мук із Suno на платних тарифах і пошуків гідної моделі (ACE-Step, MiniMax та інші) він узявся збудувати власну аудіостудію, на своїй машині. Вибір упав на YuE2: з усіх відкритих моделей вона найвигідніша й найвишуканіша.
Студію він творив не абияк, аби лиш працювало, а у своєму стилі, бо й творчість у нього своя, вишукана й неповторна: власні переклади, підрядники та багато іншого. Він намагався вмістити в неї максимум, відшліфувати інтерфейс до блиску, щоб творчість у Студії була не тицянням і клацанням серед милиць і ям, а справді продуктивною.
Ось і вся історія. Тепер ця Студія і ваша.
Віктар Журомскі, аўтар Ruach Studio, публікуе яе не дзеля хайпу. Ён тварыў яе для сябе. Пасля больш як паўгода пакут з Suno на платных тарыфах і пошукаў годнай мадэлі (ACE-Step, MiniMax і іншыя) ён узяўся пабудаваць уласную аўдыястудыю, на сваёй машыне. Выбар упаў на YuE2: з усіх адкрытых мадэляў яна самая выгадная і самая вытанчаная.
Студыю ён тварыў не абы-як, абы працавала, а ў сваім стылі, бо і творчасць у яго свая, вытанчаная і непаўторная: уласныя пераклады, падрадкоўнікі і шмат іншага. Ён стараўся змясціць у яе максімум, адшліфаваць інтэрфейс да бляску, каб творчасць у Студыі была не тыцканнем і клікамі сярод мыліц і ям, а сапраўды прадуктыўнай.
Вось і ўся гісторыя. Цяпер гэтая Студыя і ваша.
Ο Viktor Zhuromskyy, ο δημιουργός του Ruach Studio, δεν το δημοσιεύει για εντυπωσιασμό. Το έφτιαξε για τον εαυτό του. Ύστερα από περισσότερους από έξι μήνες ταλαιπωρίας με το Suno σε πληρωμένα πακέτα, και αναζήτησης ενός μοντέλου που να αξίζει (ACE-Step, MiniMax και άλλα), αποφάσισε να φτιάξει ένα δικό του στούντιο ήχου, στο δικό του μηχάνημα. Κατέληξε στο YuE2: από όλα τα ανοιχτά μοντέλα είναι το πιο συμφέρον και το πιο εκλεπτυσμένο.
Δεν έστησε το Στούντιο πρόχειρα, απλώς για να λειτουργεί. Το έφτιαξε με το δικό του ύφος, γιατί και η δημιουργία του είναι δική του, εκλεπτυσμένη και μοναδική: οι μεταφράσεις του, τα διάστιχα κείμενά του και πολλά άλλα. Προσπάθησε να χωρέσει σε αυτό όσο περισσότερα γινόταν, να γυαλίσει το περιβάλλον ως την τελευταία λεπτομέρεια και να κάνει τη δημιουργία στο Στούντιο όχι άσκοπα κλικ ανάμεσα σε δεκανίκια και λακκούβες, αλλά κάτι πραγματικά παραγωγικό.
Αυτή είναι όλη η ιστορία. Τώρα το Στούντιο είναι και δικό σας.
Viktor Zhuromskyy, el autor de Ruach Studio, no lo publica para llamar la atención. Lo hizo para sí mismo. Tras más de medio año de sufrir con Suno en planes de pago y de buscar un modelo que mereciera la pena (ACE-Step, MiniMax y otros), se propuso construir su propio estudio de audio, en su propia máquina. Se quedó con YuE2: de todos los modelos abiertos, es el más rentable y el más refinado.
No montó el Estudio de cualquier manera, solo para que funcionara. Lo hizo a su estilo, porque su creación también es suya, refinada e irrepetible: sus traducciones, sus textos interlineales y mucho más. Procuró meter en él todo lo posible, pulir la interfaz hasta el último detalle y hacer que crear en el Estudio no sea dar clics a ciegas entre muletas y baches, sino algo de verdad productivo.
Esa es toda la historia. Ahora el Estudio también es tuyo.
Viktor Zhuromskyy, l'autore di Ruach Studio, non lo pubblica per fare clamore. Lo ha costruito per sé. Dopo più di sei mesi di tormenti con Suno sui piani a pagamento, e di ricerche di un modello all'altezza (ACE-Step, MiniMax e altri), ha deciso di crearsi uno studio audio tutto suo, sulla sua macchina. La scelta è caduta su YuE2: fra tutti i modelli aperti è il più conveniente e il più raffinato.
Non ha messo insieme lo Studio alla buona, giusto perché funzionasse. Lo ha fatto a modo suo, perché anche la sua opera creativa è sua, raffinata e irripetibile: le sue traduzioni, i suoi testi interlineari e molto altro. Ha cercato di farci stare il massimo, di rifinire l'interfaccia fino all'ultimo dettaglio e di rendere il creare nello Studio non un cliccare a vuoto tra stampelle e buche, ma qualcosa di davvero produttivo.
Questa è tutta la storia. Ora lo Studio è anche tuo.
Viktor Zhuromskyy, l'auteur de Ruach Studio, ne le publie pas pour faire parler de lui. Il l'a fait pour lui-même. Après plus de six mois à se débattre avec Suno sur des formules payantes, et à chercher un modèle qui en vaille la peine (ACE-Step, MiniMax et d'autres), il s'est mis à construire son propre studio audio, sur sa propre machine. Son choix s'est arrêté sur YuE2 : de tous les modèles ouverts, c'est le plus rentable et le plus raffiné.
Il n'a pas bricolé le Studio à la va-vite, juste pour avoir quelque chose qui tourne. Il l'a fait à sa manière, parce que sa création est la sienne, raffinée et inimitable : ses traductions, ses textes interlinéaires et bien plus encore. Il y a fait entrer tout ce qu'il a pu, a poli l'interface aussi loin qu'il a pu, et a fait de la création dans le Studio non pas un tâtonnement de clics entre béquilles et nids-de-poule, mais quelque chose de vraiment productif.
Voilà toute l'histoire. Maintenant, le Studio est aussi à toi.
Viktor Zhuromskyy, o autor do Ruach Studio, não o publica pelo hype. Ele o fez para si mesmo. Depois de mais de meio ano sofrendo com o Suno em planos pagos, e procurando um modelo que valesse a pena (ACE-Step, MiniMax e outros), ele decidiu construir o seu próprio estúdio de áudio, na sua própria máquina. A escolha caiu no YuE2: de todos os modelos abertos, é o de melhor custo-benefício e o mais refinado.
Ele não montou o Estúdio de qualquer jeito, só para ter algo que rodasse. Fez do seu jeito, porque a criação dele é dele, refinada e inimitável: as suas traduções, os seus textos interlineares e muito mais. Colocou nele o máximo que pôde, poliu a interface até onde pôde e fez da criação no Estúdio não um cutucar e clicar entre muletas e buracos, mas algo de fato produtivo.
Essa é a história toda. Agora o Estúdio também é seu.
Viktor Zhuromskyy, der Autor von Ruach Studio, veröffentlicht es nicht für den Hype. Er hat es für sich selbst gemacht. Nach mehr als einem halben Jahr Mühe mit Suno in bezahlten Tarifen und der Suche nach einem Modell, mit dem sich arbeiten lässt (ACE-Step, MiniMax und andere), machte er sich daran, ein eigenes Audiostudio zu bauen, auf seiner eigenen Maschine. Die Wahl fiel auf YuE2: von allen offenen Modellen das lohnendste und das ausgefeilteste.
Er hat das Studio nicht zusammengeschustert, nur damit irgendetwas läuft. Er hat es auf seine Art gebaut, denn auch sein Schaffen ist sein eigenes, erlesen und unverwechselbar: seine Übersetzungen, seine Interlinearübersetzungen und vieles mehr. Er hat so viel hineingepackt, wie er konnte, die Oberfläche poliert, so weit er konnte, und das Schaffen darin nicht zu einem Stochern und Klicken zwischen Krücken und Schlaglöchern gemacht, sondern zu etwas wirklich Produktivem.
Das ist die ganze Geschichte. Jetzt ist das Studio auch deins.
Ruach Studio の作者 Viktor Zhuromskyy は、話題づくりのためにこれを公開しているのではありません。自分のために作ったのです。有料プランで Suno と半年以上格闘し、取り組むに値するモデルを探し回った末に(ACE-Step、MiniMax ほか)、彼は自分のマシンの上に自分だけのオーディオスタジオを作ろうと決めました。選んだのは YuE2 でした。オープンなモデルの中で、最も割に合い、最も洗練されているからです。
彼は、とりあえず動けばいいという作り方はしませんでした。自分の流儀で作りました。彼の創作は彼自身のもの、洗練された唯一無二のものだからです:自身の翻訳、行間対訳のテキスト、そのほか多くのもの。詰め込めるだけ詰め込み、磨けるだけインターフェースを磨き、スタジオでの創作を、松葉杖と穴ぼこの間を手探りでクリックすることではなく、本当に生産的なものにしました。
話はこれで全部です。これからは、このスタジオはあなたのものでもあります。
Ruach Studio 的作者 Viktor Zhuromskyy 发布它并不是为了炒作。他是为自己做的。在付费套餐上和 Suno 折腾了半年多,又四处寻找值得投入的模型(ACE-Step、MiniMax 等)之后,他决定在自己的机器上搭建一个属于自己的音频工作室。他选定了 YuE2:在所有开放模型中,它最划算,也最精致。
他没有随便拼凑一个能跑就行的工作室,而是按自己的方式来做,因为他的创作也是他自己的,精致而独一无二:他的译本、他的逐行对照文本,还有许多别的。他尽可能多地装进其中,把界面打磨到力所能及的极致,让在这个工作室里的创作不再是在拐杖和坑洼之间胡乱点击,而是真正高效的事。
故事就是这样。现在,这个工作室也是你的了。