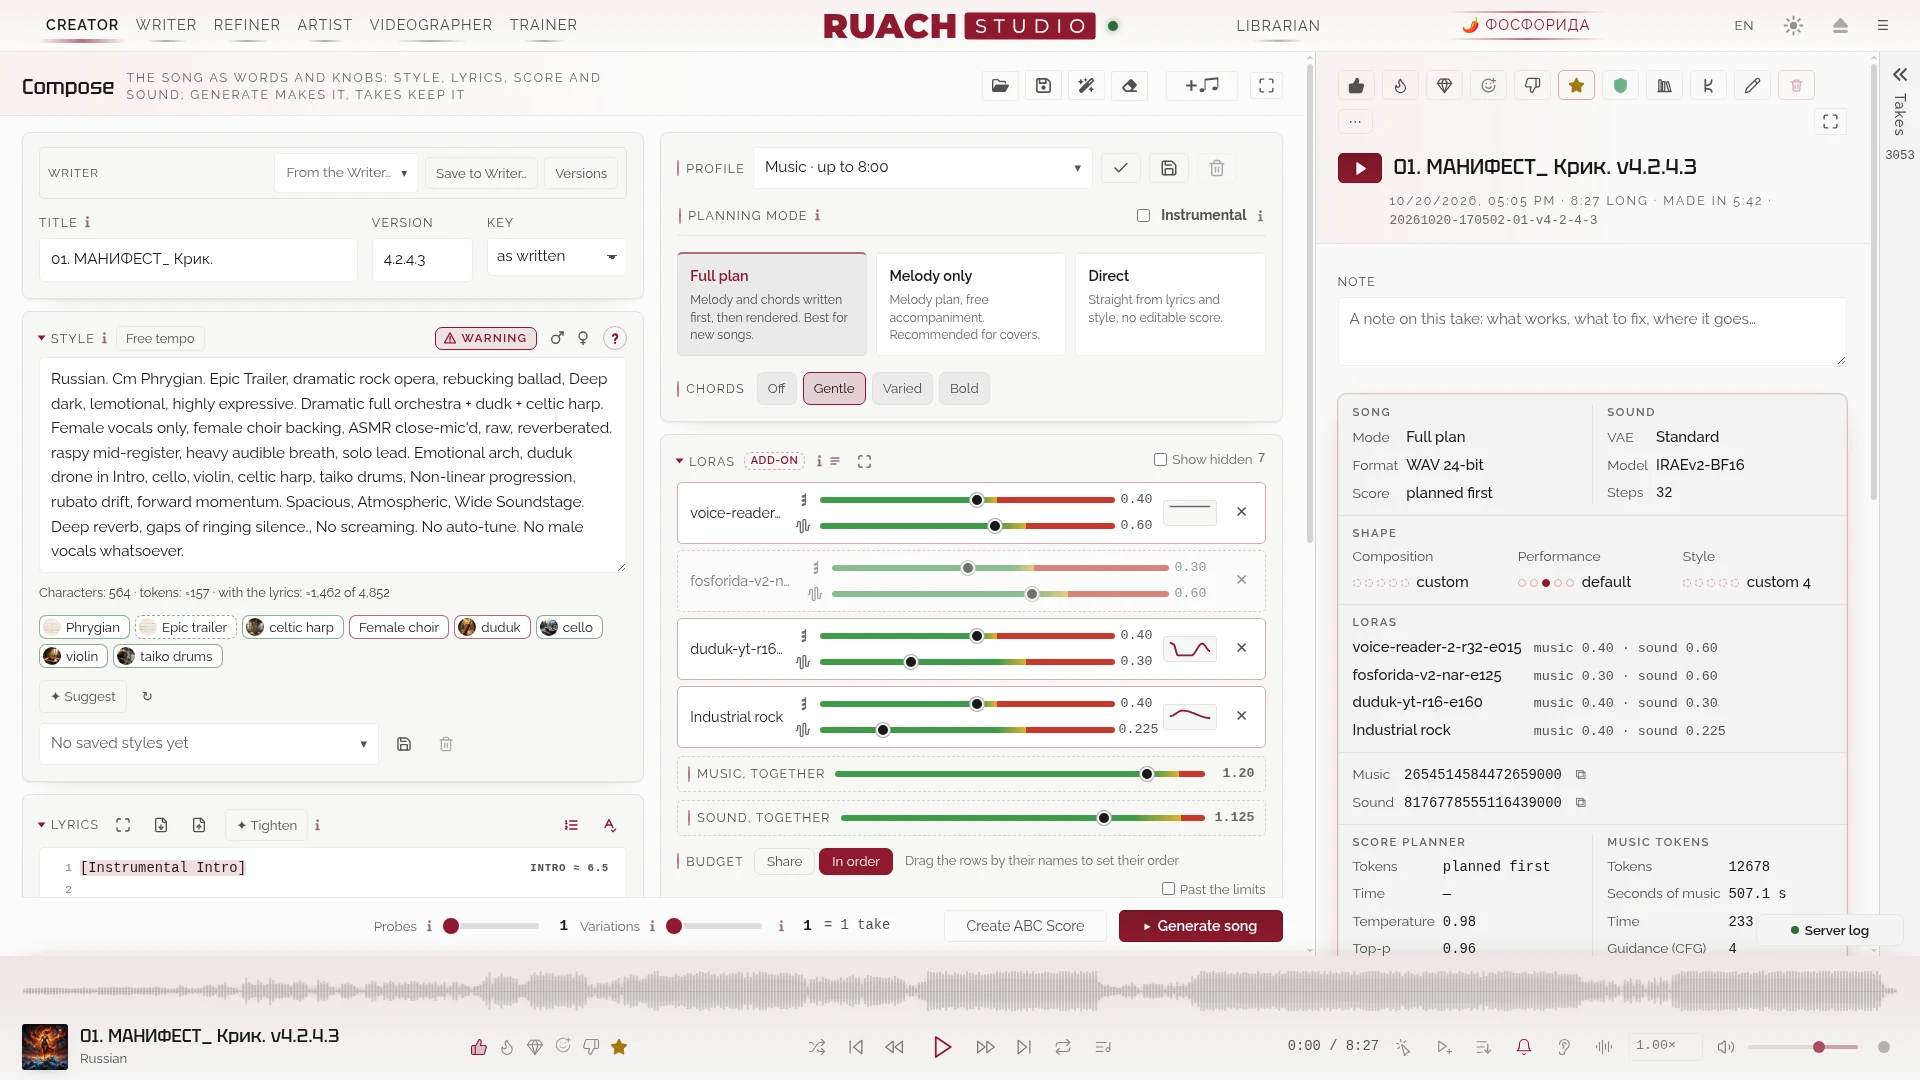
クリエイター
スタイル、歌詞、計画モード、デコーダー、緑から赤への道の上の LoRA。テイクには楽譜、シード、作り直すためのすべてが付きます。
オープンな歌モデル YuE2 を中心にした本格的なスタジオ。スタイルと歌詞を書けば、スタジオがあなた自身の GPU で作曲し、歌い、曲をレンダリングします。あなたの歌、言葉、設定がそこから出ることはありません。
2.0.5 · ピークはすべてそのまま、系譜ツリーと https のスタジオ · 2026 年 11 月
Ruach Studio は、あなた自身のハードウェアで動くオープンな音楽生成です。モデルも、スコアも、アダプターも、すべてのテイクもあなたのもので、トークン単位で借りるものは何もありません。オープンなモデルはもう自分の足で立てるほど良くなり、欠けていたのはその周りのスタジオでした。私たちはそれを、オープンに作っています。
音楽は、自由に作り、自由に分かち合えるものであるべきです。声も、楽器も、スタジオも持たない人にも、自分の思いと気持ちを音に託す権利があります。
クリエイターが曲を作り、ライターがチャットモデルと書き、仕上げ師が仕上げ、絵師が絵を描き、映像師がミュージックビデオを組み立て、司書がすべてのテイクを保管し、LoRA トレーナーがあなた自身の歌を YuE2 に教えます。各部屋のガイドはスタジオの中にあります。
スタイル、歌詞、計画モード、デコーダー、緑から赤への道の上の LoRA。テイクには楽譜、シード、作り直すためのすべてが付きます。
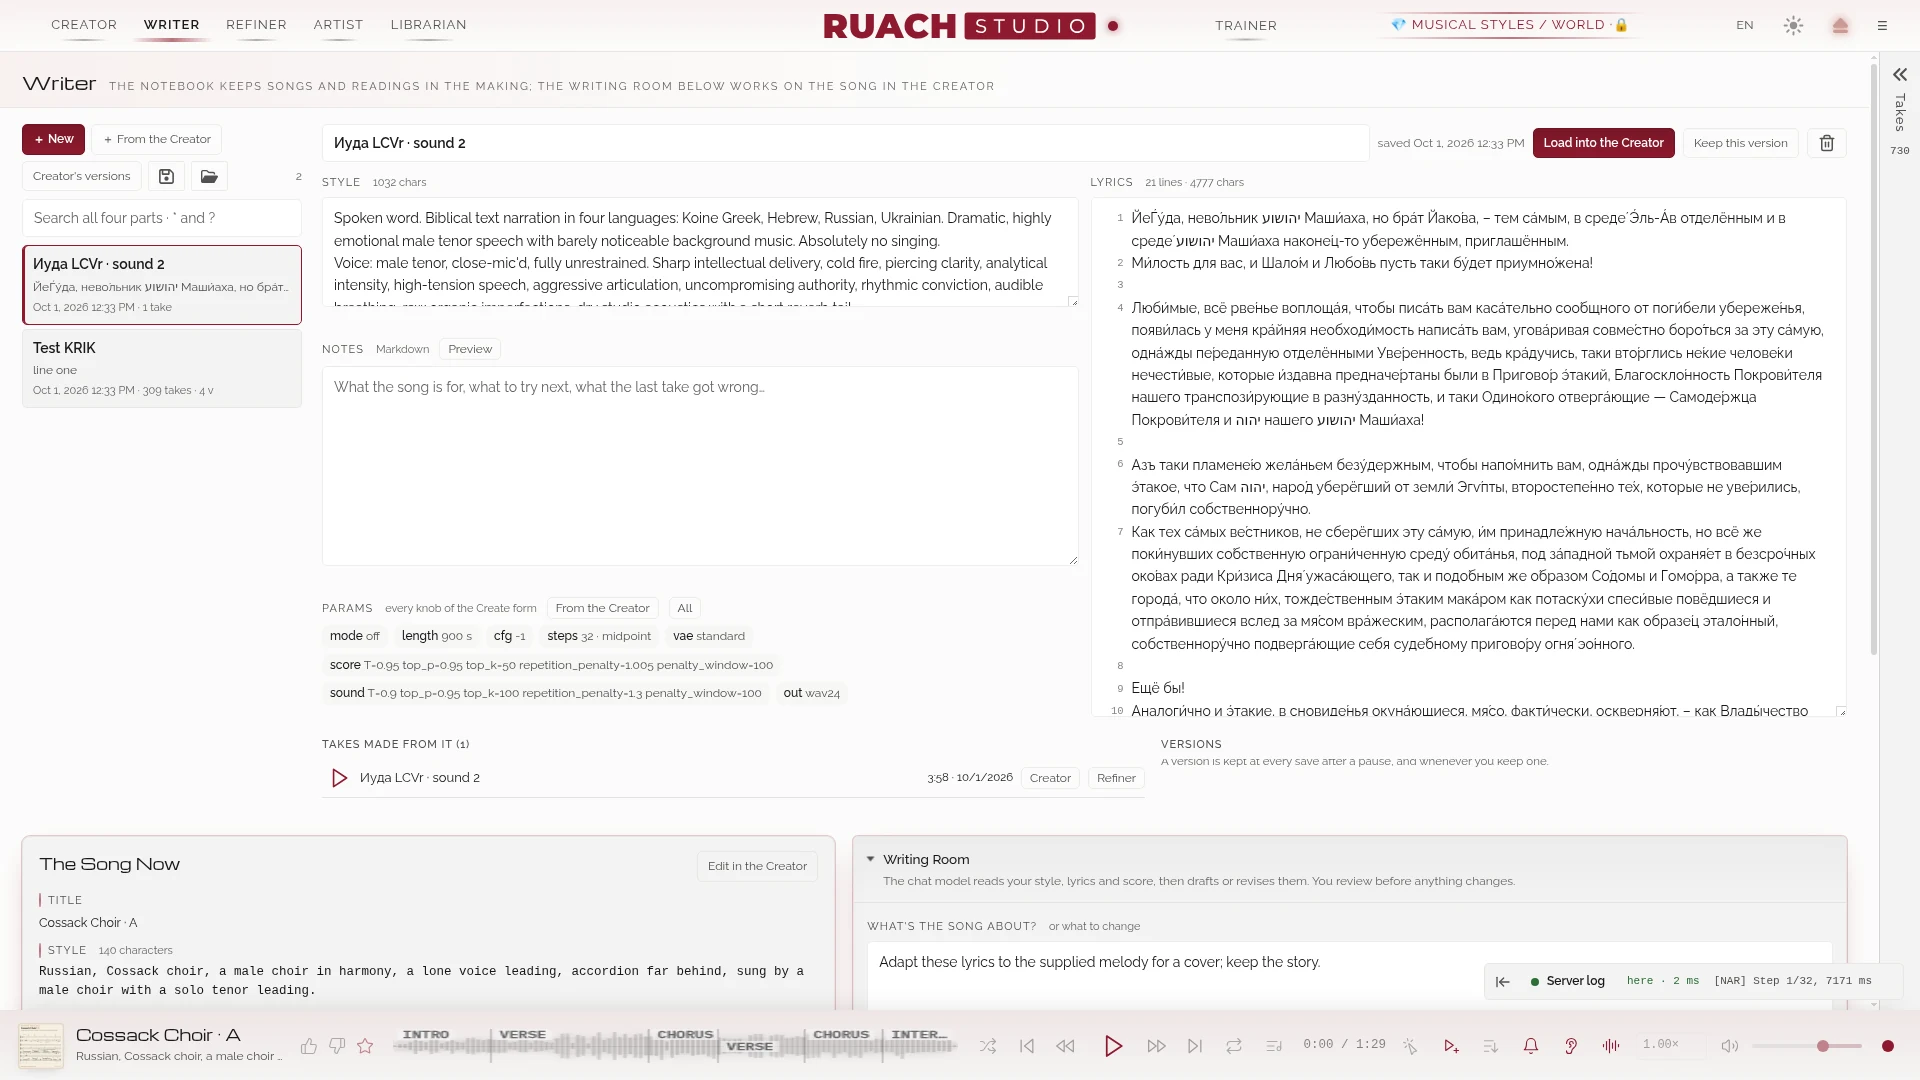
バージョン付きの文書としての歌、テキストプロファイル、そしてあなた専用のチャットモデル(または OpenRouter)が一緒に下書きし、推敲します。
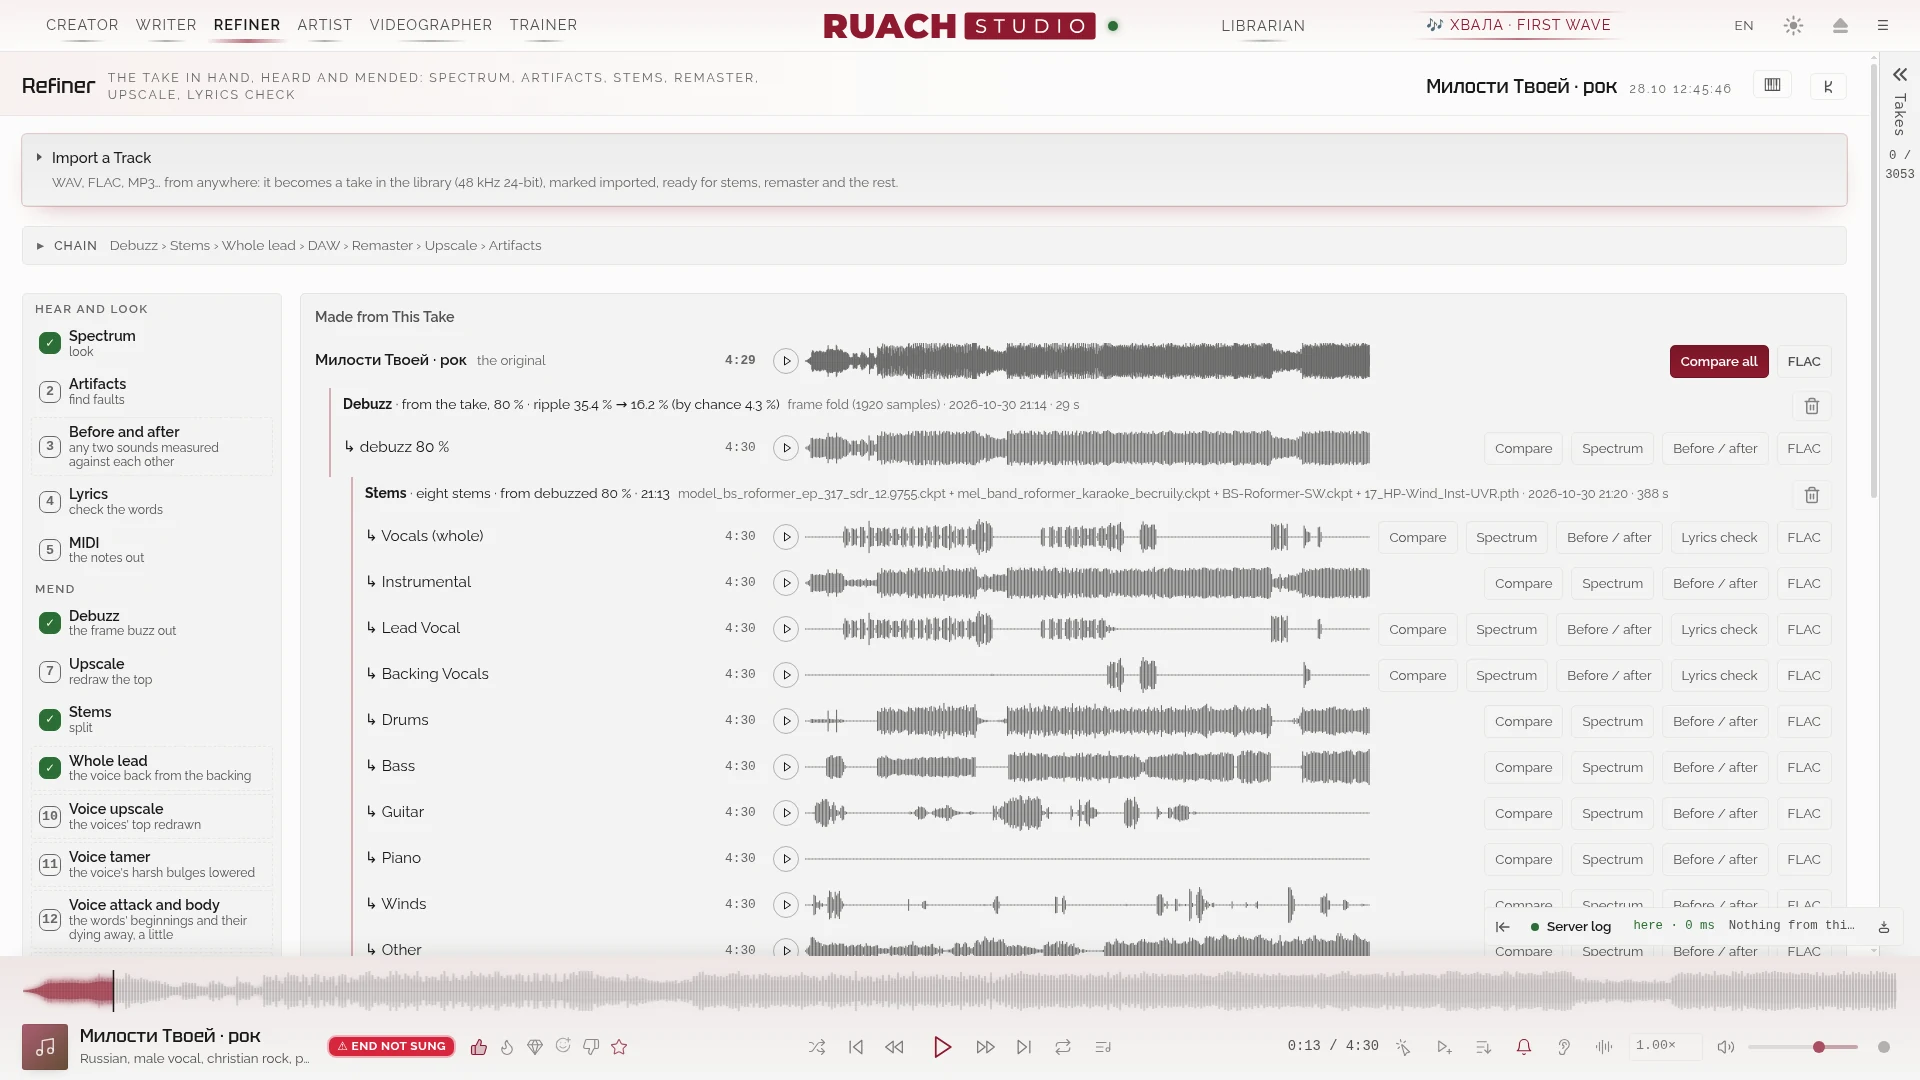
スペクトル、アーティファクト、バズ除去、Whisper による歌詞チェック、ステム、リマスター、アップスケール。1 本のチェーンですべてを実行します。
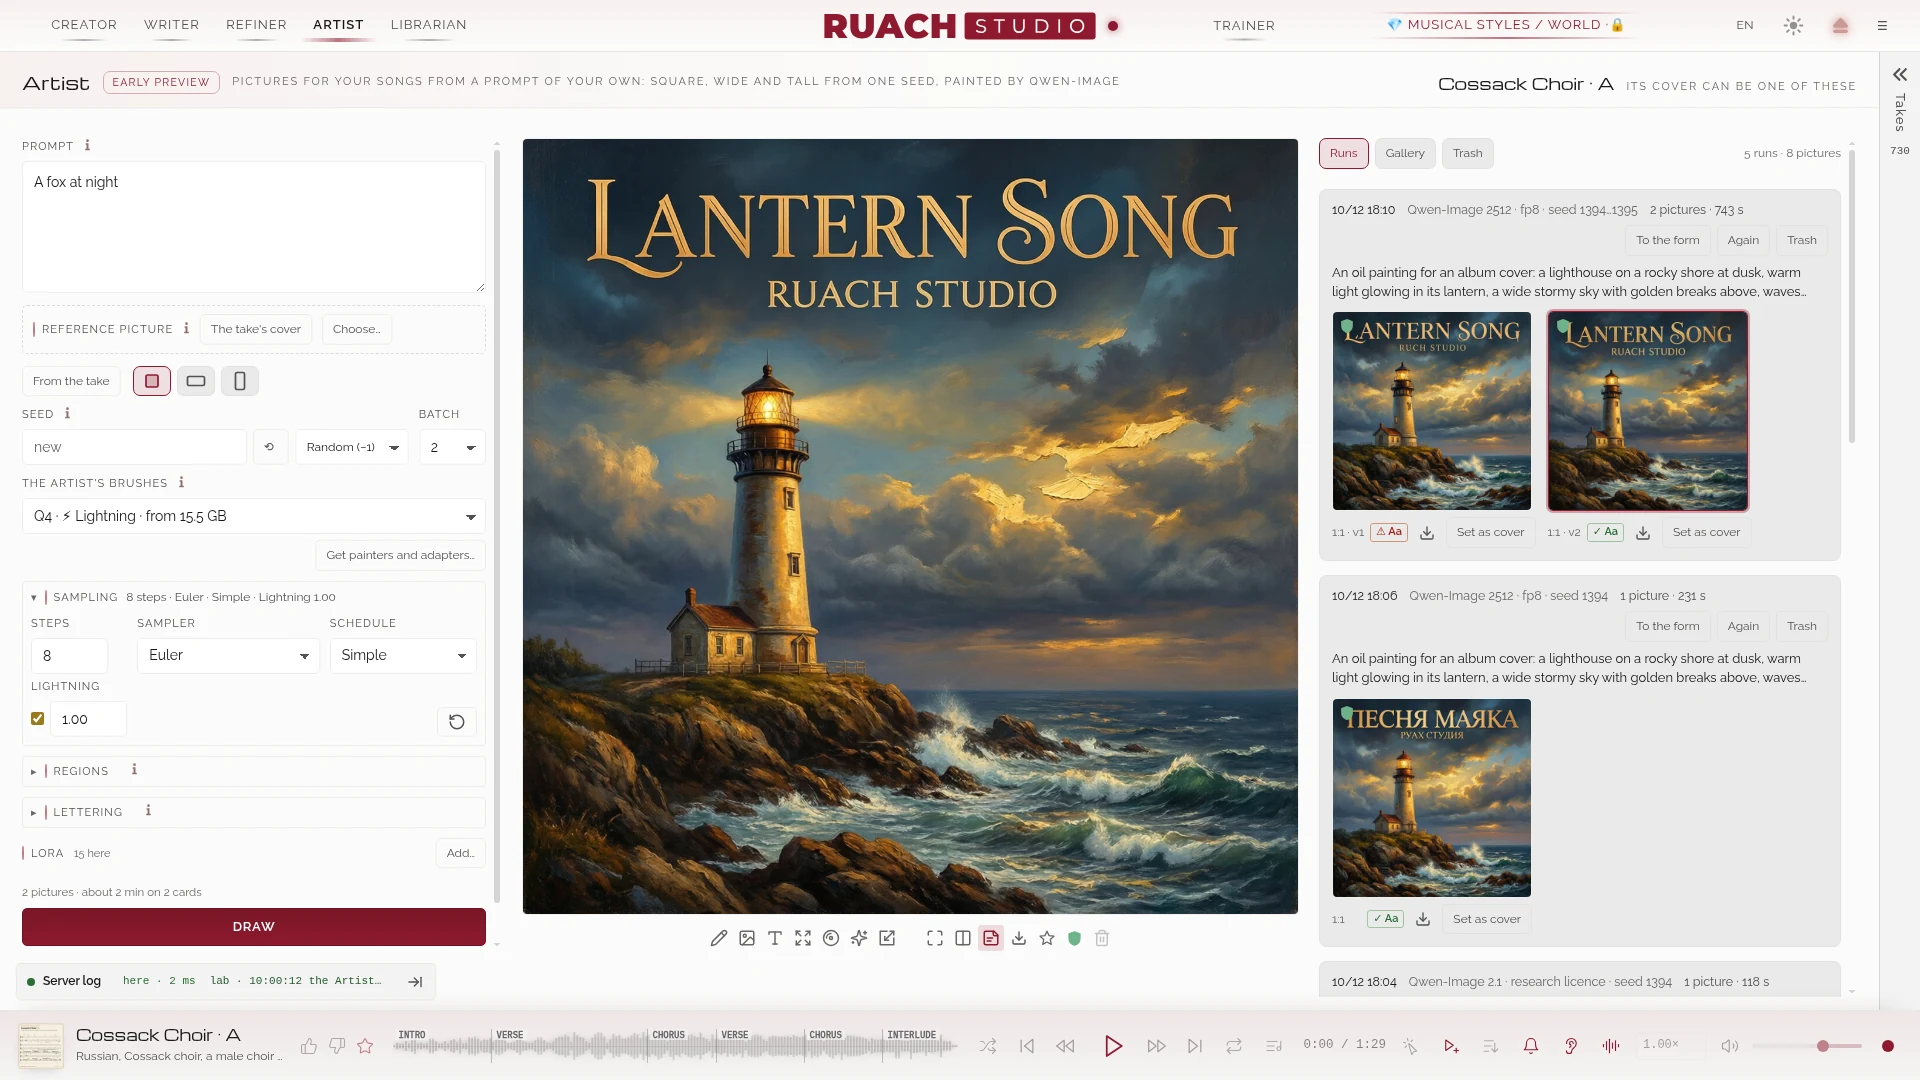
自分のプロンプトから歌のための絵を:正方形、横長、縦長を 1 つのシードから、Qwen-Image 2512 が描きます。絵は目の前で現れ、正方形のものはテイクのカバーになります。早期プレビュー。
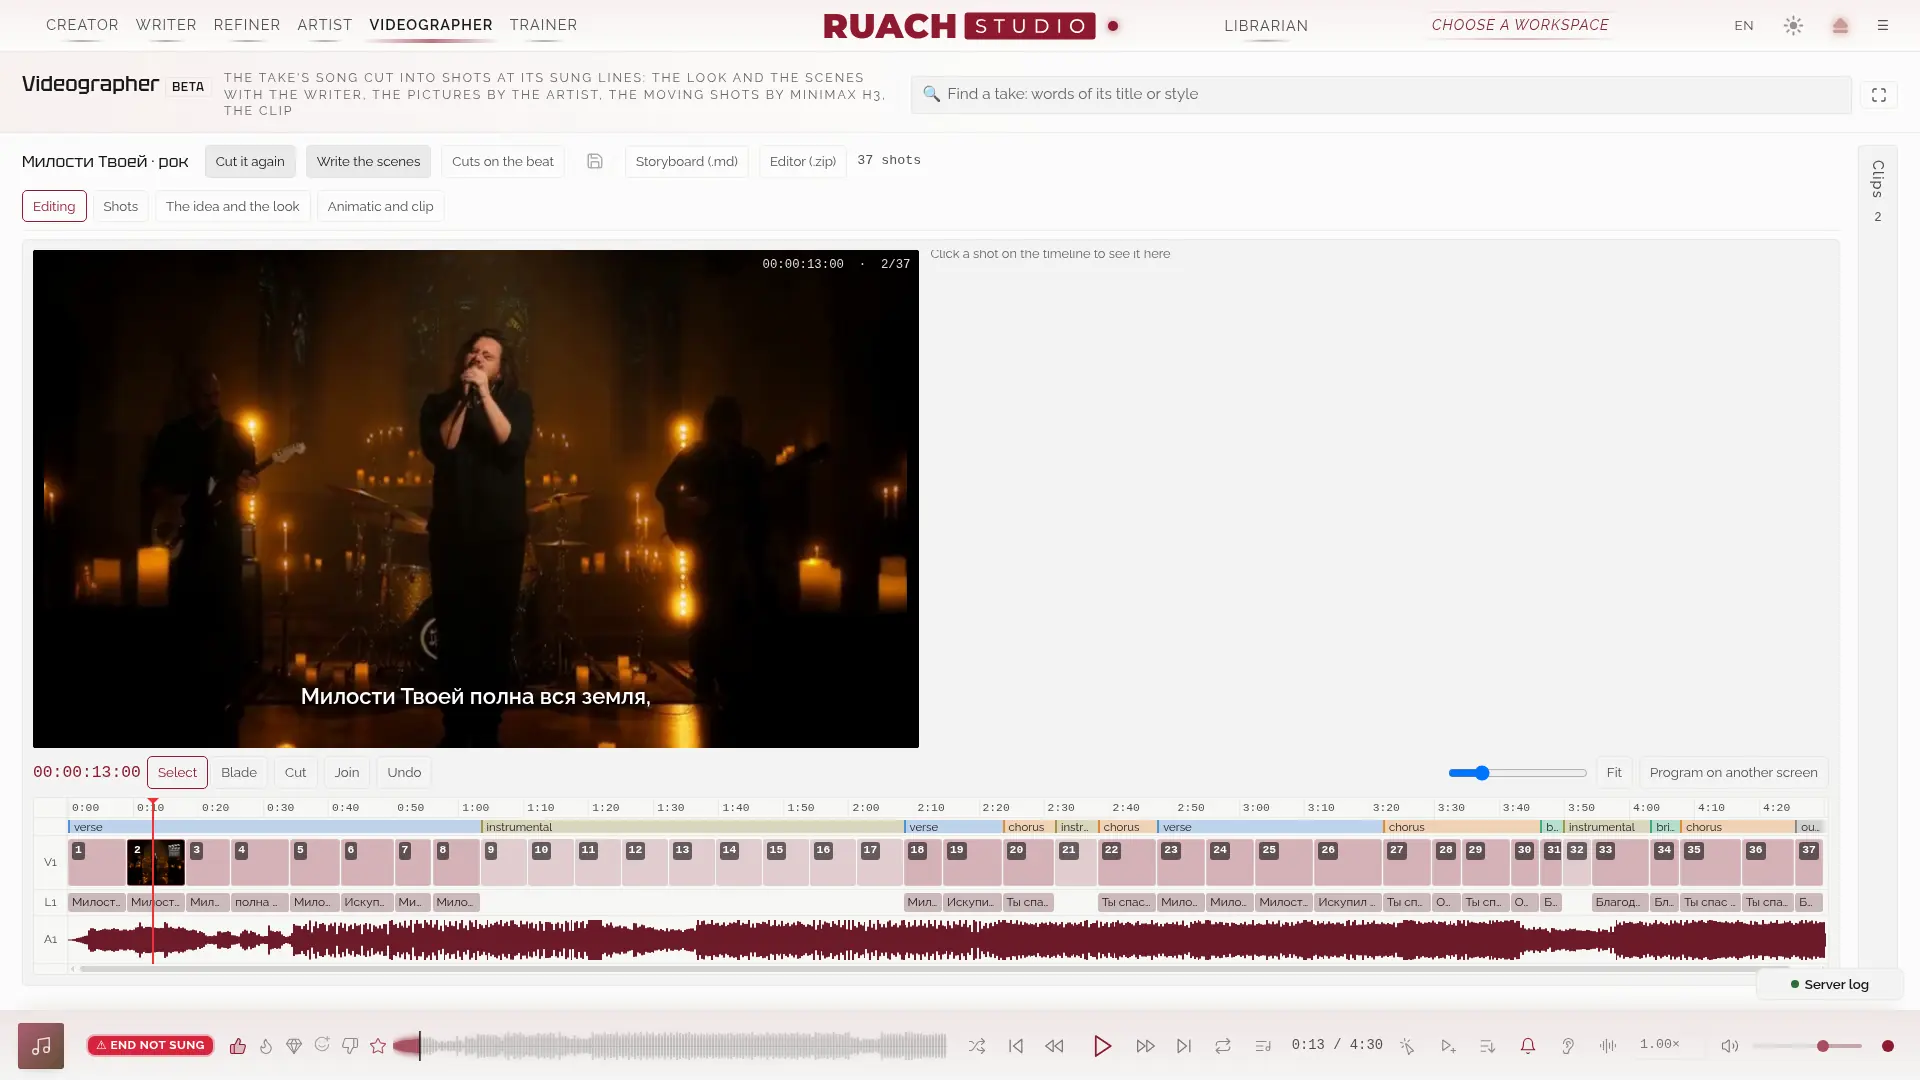
テイクのミュージックビデオ:曲を歌われる行ごとにショットに分け、シーンはライターと書き、キーフレームはアーティストが描き、動くショットは MiniMax H3 が作ります。編集用のタイムライン、ルック(3D LUT、グレイン)、アニマティック、そしてクリップ。ベータ。
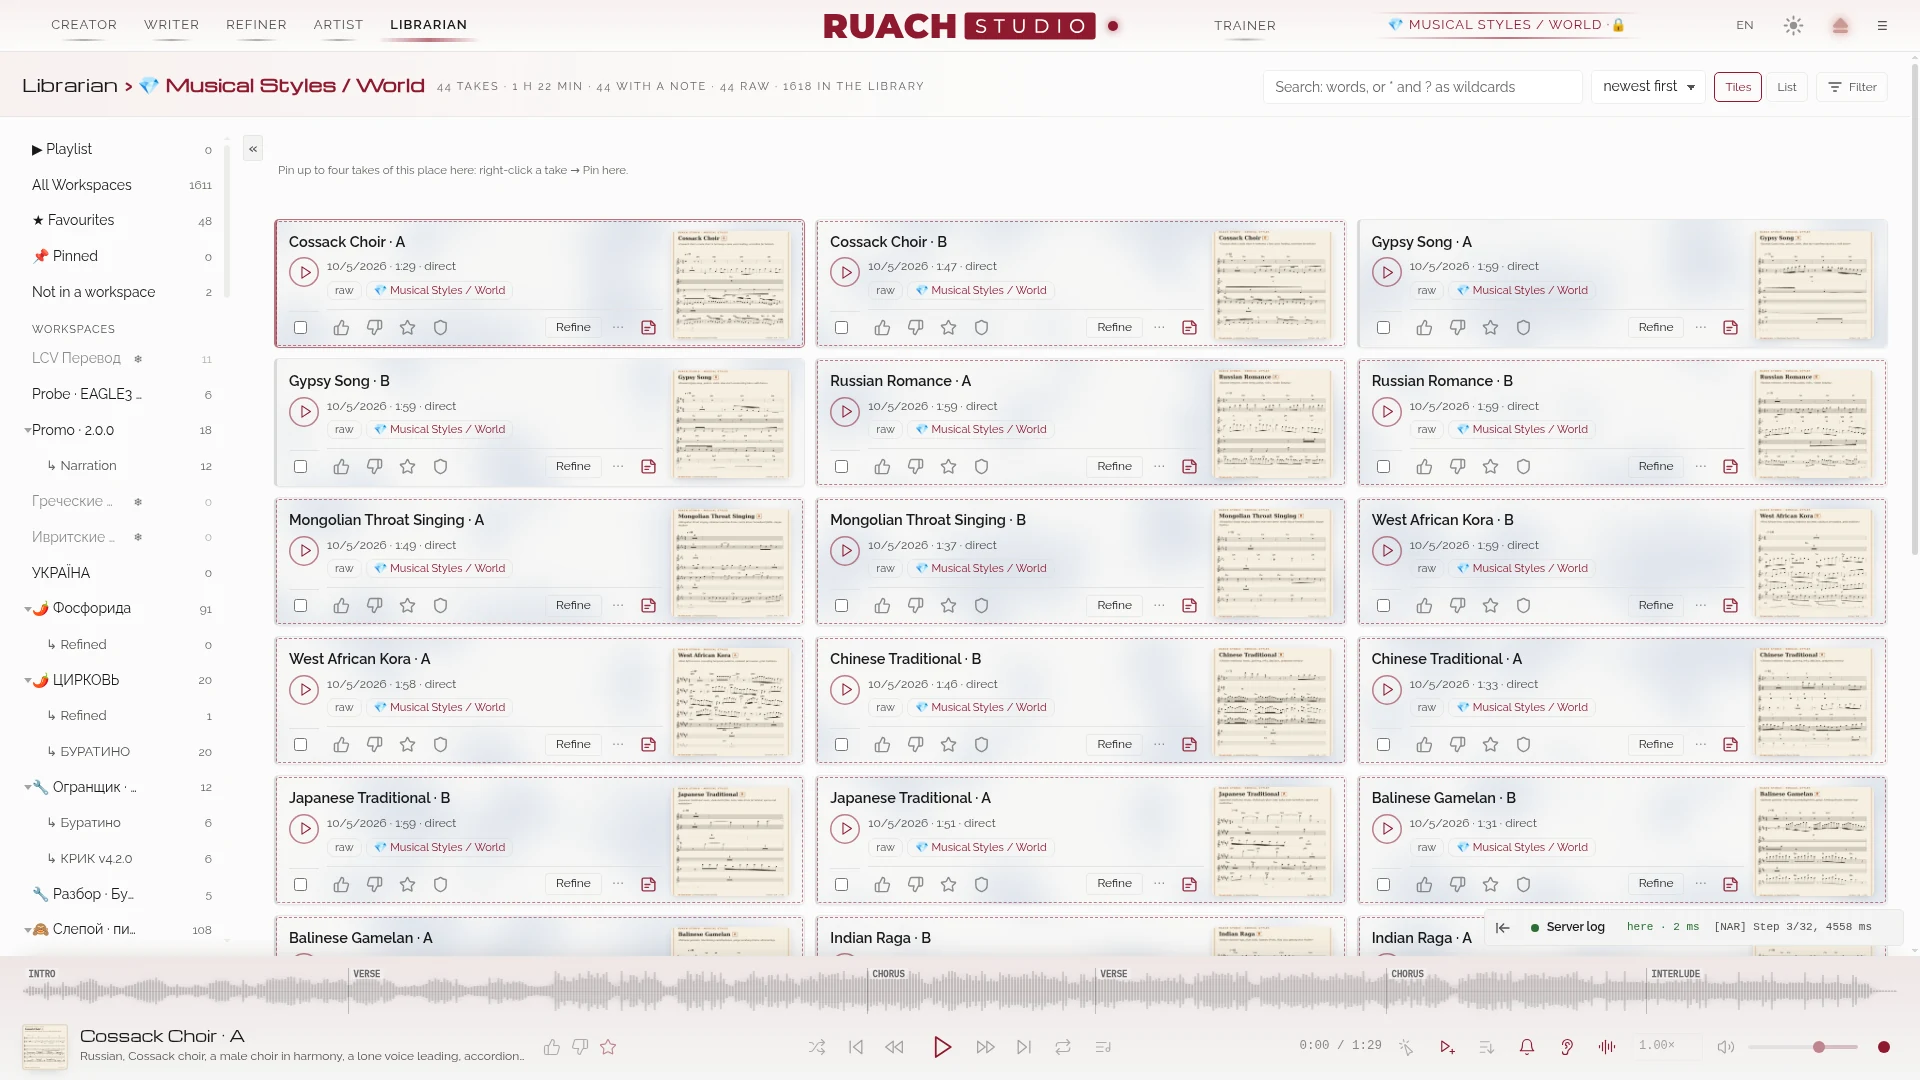
すべてのテイクをワークスペースに:検索、いいね、メモ、ロック、アートワーク付け、DAW へ送る。元に戻せるゴミ箱。
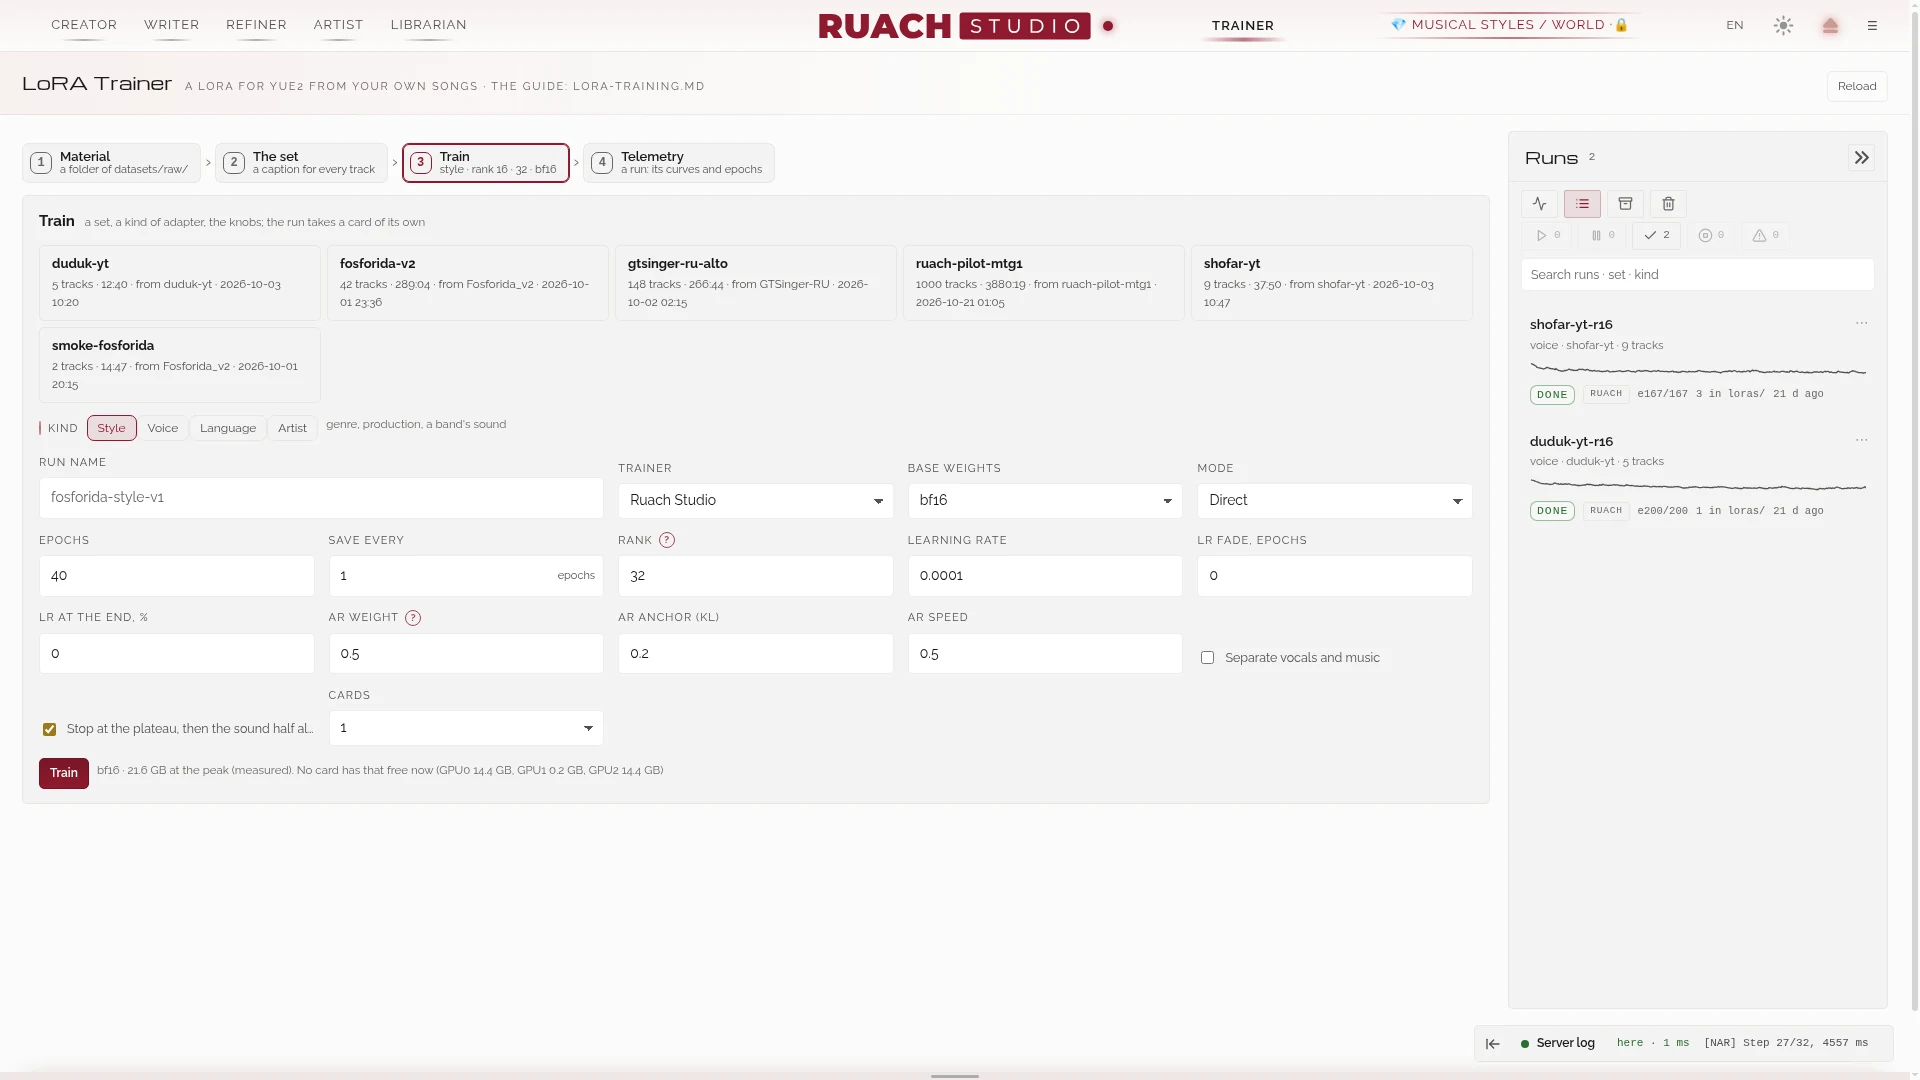
自分の歌からアダプターを:セット、実行、両半分の曲線の解説、まず聴くべきエポック。
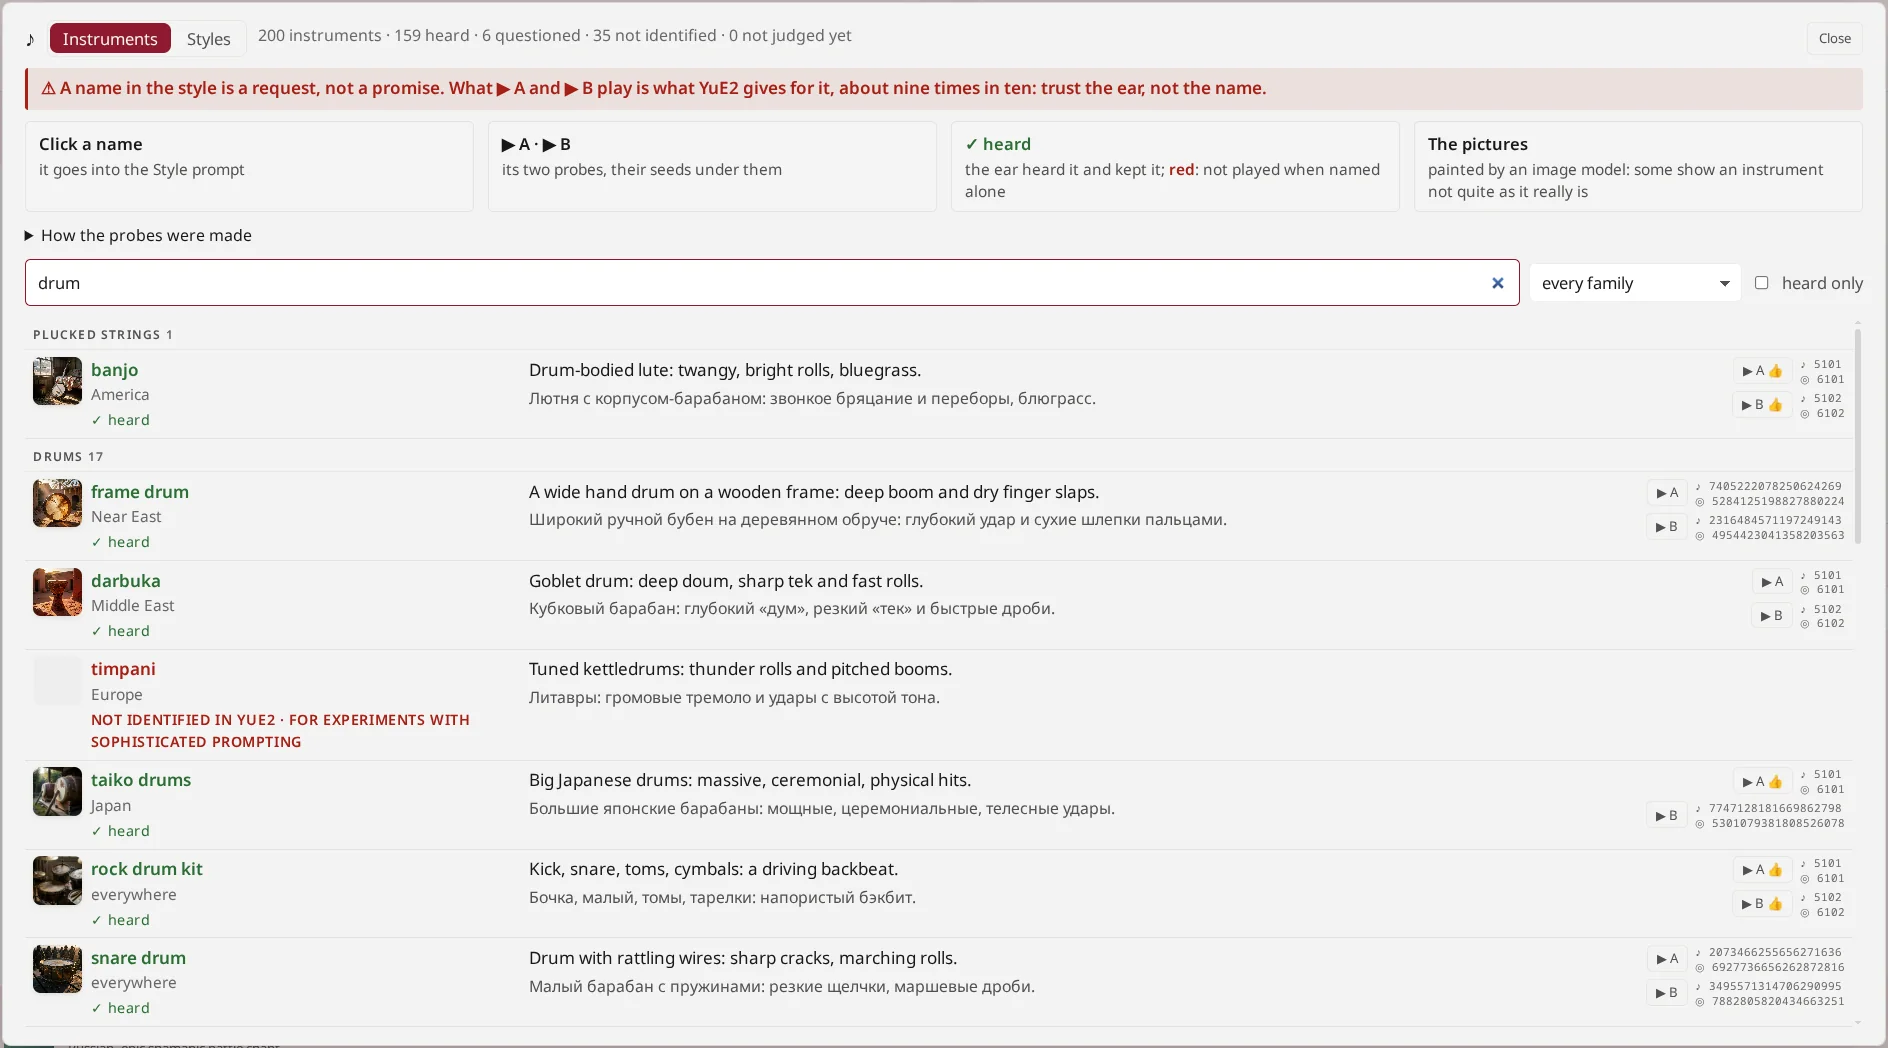
耳で確かめ判定した 200 の楽器:YuE2 が本当に弾けるもの、薄くしか弾けないもの、知らないもの。
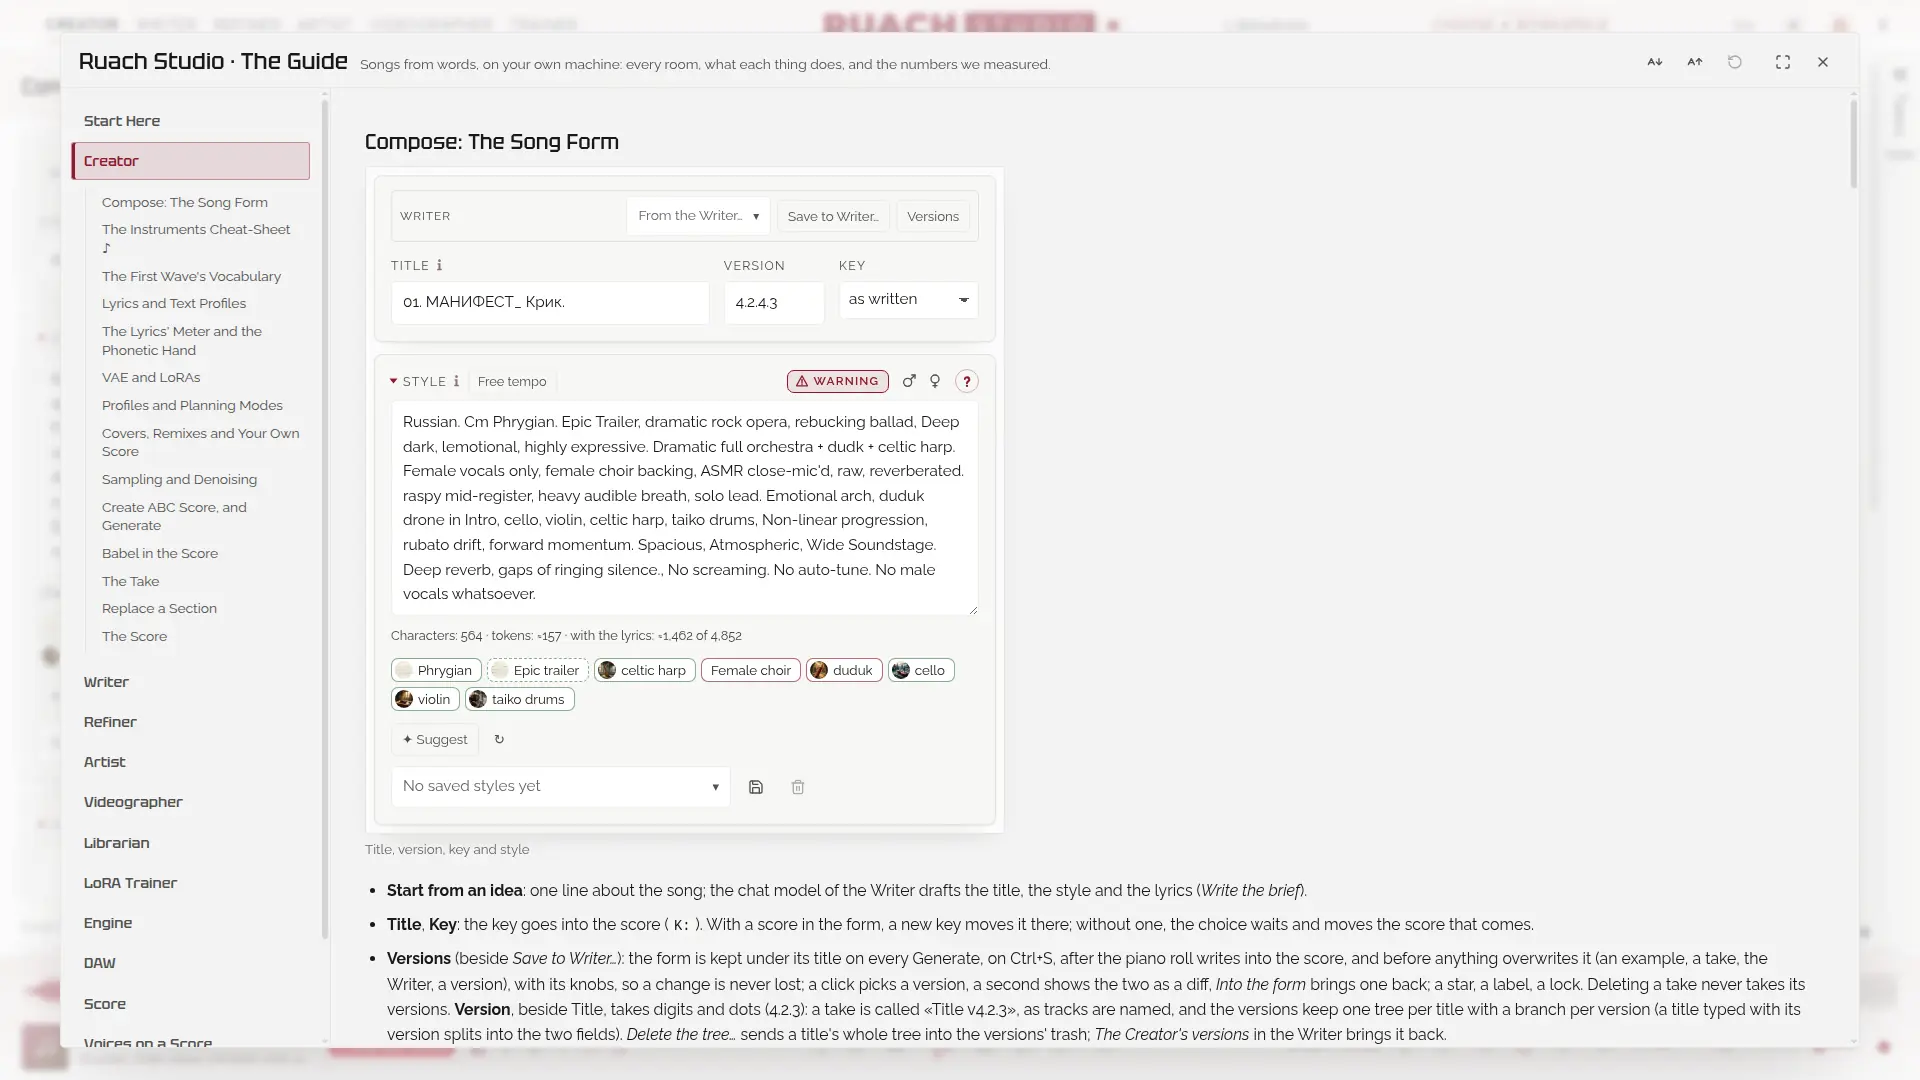
Studio のすべてを Studio の中で、キー 1 つで説明:すべての部屋とすべてのつまみ、何をするか、私たちが測った数値を 12 言語で。何時間もネットを探し回るためではなく、作る喜びのために。
モデルのラッパーがまた 1 つ、ではありません:モデルを囲むワークステーションで、骨の髄までオープン、すべての変更に番号と記録があります。
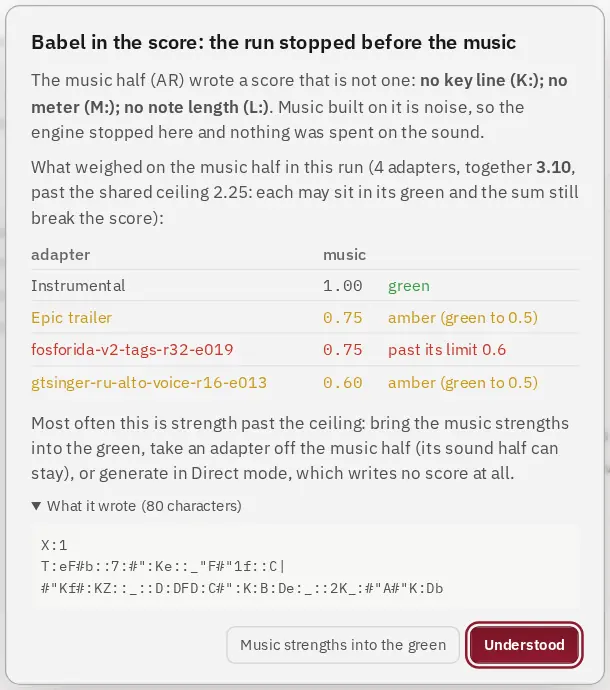
音楽側が壊れた楽譜を書くと(押しすぎたアダプターがそうします)、エンジンはその上に音楽が作られる前に数秒で実行を止め、理由を示します:どのアダプターが、限度をどれだけ超えたか、何が書かれたか。
強さは計測済みの道の上に。重ねたアダプターは計測済みの上限を分け合います。
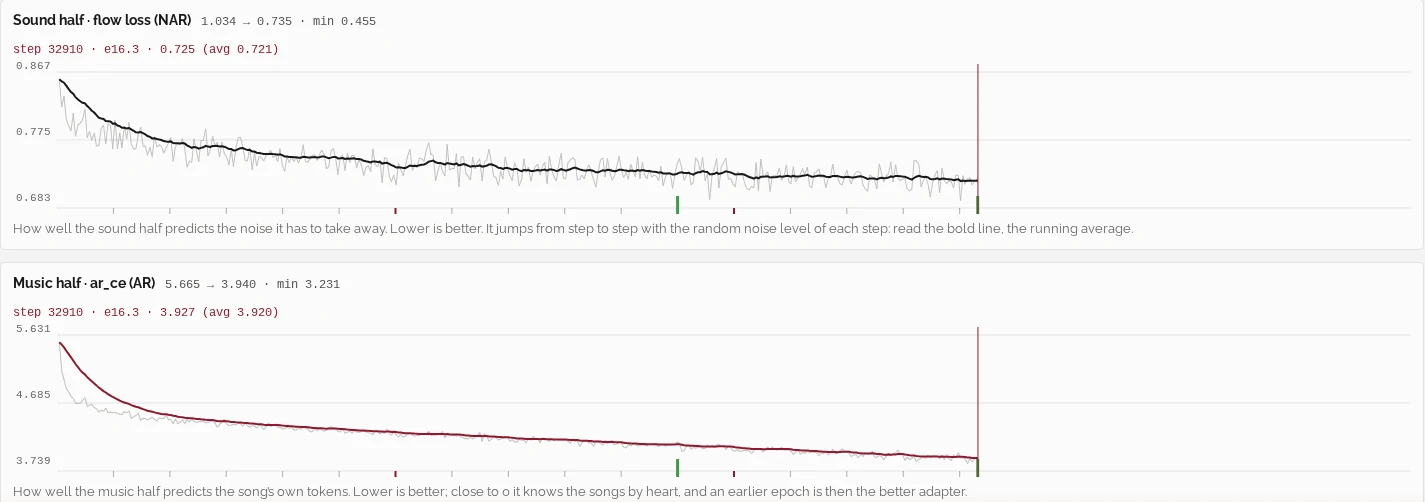
スタジオは量子化していない bf16 の重みで自らアダプターをトレーニングします。同じセットで Ostris の AI-Toolkit と比べると、音楽側の損失はエポックごとに 0.015 以内で一致します。
148 曲でランク 16:1 ステップ 2.1 秒、12 GB。42 曲のフルソングでランク 32:1 ステップ 6.7 秒、18 GB。
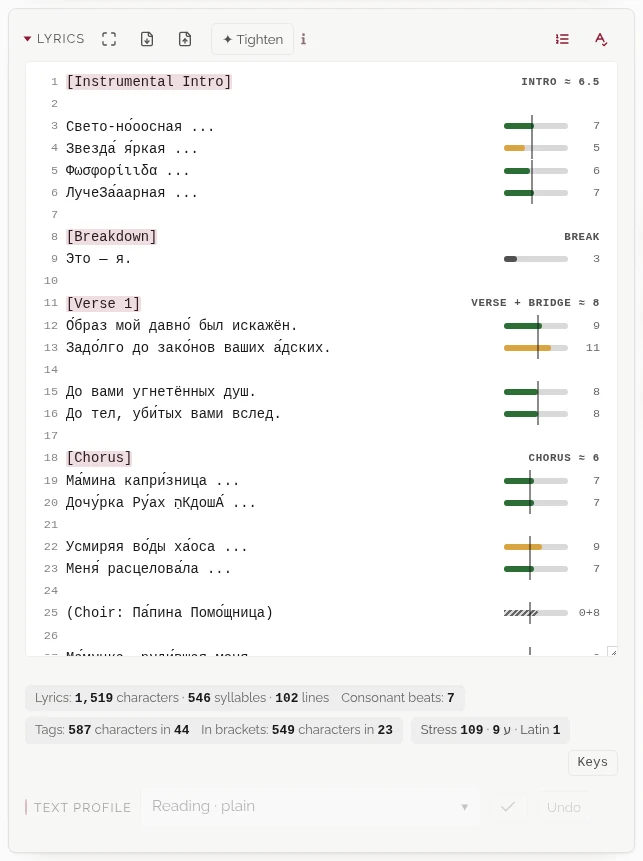
各行の横にその拍を、セクションの定規と比べて表示:ヴァースとブリッジで 1 グループ、プリコーラスとコーラスはそれぞれ独自に。音節は各言語の規則で数え、独自の拍を取る子音も数えます。セクション内の休符や間奏は新しいグループを作りません。
行頭で «[» と打つと、コードエディターが言葉を提案するようにセクションタグが提案されます。迷子の強勢記号は見つかり、Ctrl+F はその欄の中だけを検索します。
毎週どこかの動画が、新しいモデルが SUNO を倒すと言います。これはモデルではなく、モデルを囲む Studio 一式で、独自のファインチューンもあります。どこで勝ち、どこでまだ SUNO が勝つのか、はっきりと。
| ルアハ・スタジオ (YuE2) | SUNO | |
|---|---|---|
| どこで動くか | あなたの GPU。曲も歌詞も設定も外に出ることはなく、インストール後はインターネット不要 | 彼らのクラウド |
| 費用 | 電気代だけ。クレジットもプランも 1 日の上限もなし | サブスクリプションとクレジット |
| モデル | YuE2 と私たち自身のファインチューン RS-FW。初の大規模な公開ファインチューンで、両方の半分を 32,633 曲・約 1,800 時間で学習し直し、与えた言葉をすべて公開 | 非公開。何から学んだかは公表されていない |
| 楽譜 | 最初に書かれ、見えて、編集でき、あなたのもの(ABC、MIDI)。ウィンドウ全体のピアノロール | 非公開 |
| 歌詞 | 各行の横に拍子計:その拍をセクションの定規と比べ、音節は各言語の規則で。«[» と打てばセクションタグを提案 | テキスト欄。頼めば歌詞を書いてくれる |
| テイクを繰り返す | 正確に:保てる 2 つのシード | なし |
| ガイダンス(CFG) | 2 つを別々に:スタイルの引きと歌詞の保持、それぞれ独自の CFG | Style Influence のつまみ 1 つ |
| セクションの差し替え | 耳が見つける休符の間で歌詞を歌い直し、テイクの残りはサンプル単位でそのまま:継ぎ目は聞こえない。複数のセクションを一度に | Replace Section:私たちの試用ではほぼ使い物にならない。継ぎ目が聞こえ、声が変わる |
| テイクの系譜 | 系譜:テイクの元になったすべてのクロップ、バージョン、再生成と、そこから生まれたもの。それぞれに波形付き | — |
| ライブラリー | セクション付きのワークスペース、16 種のリアクション、メモ、保護と元に戻せるゴミ箱、ワイルドカードと「除外」付きの検索、公正に聴くためのブラインドセット、テイクごとのリーフレットとパスポート | ワークスペース、いいね、プレイリスト |
| テイクの比較 | 最大 12 バージョンを 1 つのプレーヤーで同じ秒から。名前付きでもブラインドでも、同じ音量で、それぞれの音で位置合わせ | — |
| あなた自身の音 | 自分の歌で LoRA をトレーニング、スタジオの中で | 学習なし。Personas で 1 曲の声とスタイルを再利用 |
| YuE2 が弾けないもの | テイク自身の譜面で鳴る MIDI オーケストラ(SFZ セット、持っていれば Pianoteq)と、曲の下に敷く自然音:火、雨、川、鳥 | — |
| 自分の楽器 | バンクビルダーはひとつの楽器(ドゥドゥク、ショファル)の録音を SFZ バンクにします。声、叫び、ほかの楽器を聴き分けて除き、音を鍵盤ごとに見つけ、チューニングしてループに。DAW では曲の下で下地として、曲の調の持続音として、または MIDI のラインとして鳴ります | — |
| すべてのピークがそのまま | 出力でのクリップなし。長いリバーブの余韻も静けさもそのまま。系譜は旧カットが噛んでいた場所を示す | マスタリング済みで納品(私たちのリングで:−15.5 LUFS、−3.4 dBTP) |
| レンダリングの後 | ステム、デバズ、リマスター、アップスケール、歌詞チェック、目標ラウドネスへのマスター(Spotify −14、Apple Music −16、CD −9)、すべてローカル | ステムとリマスター、クラウドで |
| ミキサー | 仕上げ師の中の DAW:EQ、ゲート、コンプ、幅、センド付きのレーン、オートメーション、マーカー、レーンの音をプリセットに | Suno Studio、ブラウザで、最上位プランで |
| 音を見る | プレーヤーの上にテイク全体のスペクトログラム、波形と時間を合わせて:セクション、明るさと音量、ポインター位置のスペクトルと音名 | 波形 |
| 画像と動画 | アーティストがあなたの言葉からカバー、16:9、9:16 を描き、映像師がミュージックビデオを計画し、キーフレームを描いて、ルックを与える(3D LUT、グレイン、ビネット) | カバー画像 |
| DAW へ | 楽譜、セクション、歌詞を含む REAPER プロジェクト(実験的) | オーディオステム |
| スクリプトとエージェント | API(OpenAPI 3.1)と MCP サーバー、あなたのマシンとネットワーク上で | 公開 API なし |
| 来歴 | すべてのダウンロードに Content Credentials(C2PA)を署名、望めばあなたの名前で | — |
| コード | オープン(AGPL)、すべての変更に番号と記録 | クローズド |
| インターフェース | 1 ページに 7 つの部屋、12 言語。すべての操作にヒント、すべての部屋にガイド。どの部屋にもプレーヤーとテイク。よく使う操作にはキー。アプリとしてインストール可能 | Web アプリとモバイルアプリ |
| 箱から出してすぐの仕上がり | 劣る:ミックスがバズることがある(バズ除去が助けます)、歌詞がずれることがある(歌詞チェックが場所を見つけます)、YuE2 が薄くしか、または全く弾けない楽器がある(LoRA が教えます) | 勝る |
| 必要なもの | NVIDIA の GPU(フル精度ですべてに 24 GB、12–16 GB と 8 GB は小さいコピーで)、Linux、ディスク 34–41 GB | ブラウザー |
「—」:SUNO の有料プランを半年以上使っても見つからなかったもの。SUNO は変化が速いので、この表は 2026 年 11 月時点です。
20 枚のカード。それぞれにスタイルの 1 行と歌詞があり、どの側にも変えずに送りました。SUNO v6 と Musicful V3 はそれぞれのサービスが出すままに、私たちのものはエンジンからの未加工のまま、11 月にピークを一つも削らずに歌い直したもの:標準の YuE2-3B、私たち自身のファインチューン RS-FW の 3 つの保存点、そして RS-TW 2.0 です。ここではどのファイルも同じラウドネスで鳴るので、音が大きいことで勝つものはありません。名前を押すと再生します。同じカードの別の名前は、同じ秒から続きます。
RS-TW 2.0 は私たちの 2 つ目のファインチューンで、2.0 エポックまで学習したものを RS-FW 2.4 の上に 2 つの強さでマージしています。×0.75 は安定したバランス、×0.9 はより地殻変動的で、安定性の保証はありません。私たちのものはカードごとに 2 つのシードで、どちらもここにあり、どちらかを選んではいません。プレーヤーの切り替えでシード 1 かシード 2 を聴けて、その選択はカードを移っても保たれます。表の平均は両方を数えています。
| 未加工で計測、平均値 | SUNO v6 | Musicful V3 | YuE2‑3B | Ruach Studio (RS-…):YuE2 3B のファインチューン | ||||
|---|---|---|---|---|---|---|---|---|
| FW 0.7 | FW 1.5 | FW 2.4 | TW 2.0 ×0.75 | TW 2.0 ×0.9 | ||||
| 歌詞に対する Whisper の誤り率、ミックスで、% ↧ | 23.1 | 19.5 | 20.0 | 19.9 | 24.8 | 21.8 | 23.0 | 26.1 |
| 歌詞に対する Whisper の誤り率、分離した声で、% ↧ | 27.4 | 18.9 | 21.6 | 24.8 | 31.1 | 28.8 | 29.5 | 33.7 |
| 静かな箇所の砂ノイズ、6–16 kHz、dB ↧ | -15.7 | -14.8 | -17.6 | -18.1 | -17.3 | -17.3 | -17.9 | -17.5 |
| 迷い込んだ持続音 ↧ | 2.2 | 1.9 | 4.33 | 2.0 | 2.27 | 2.23 | 2.15 | 1.6 |
| デコーダーの高域の 25 Hz のバズ、dB ↧ | 8.3 | 8.0 | 11.4 | 11.6 | 11.6 | 11.5 | 11.6 | 11.1 |
| クリック ↧ | 33.4 | 33.8 | 27.7 | 31.9 | 35.3 | 34.7 | 34.5 | 32.8 |
| クリッピングの区間 ↧ | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| ノイズフロア、最も静かな 1/10、dBFS ↧ | -26.6 | -25.2 | -27.7 | -27.6 | -27.0 | -26.6 | -27.1 | -28.2 |
| スペクトルの上限、kHz ↥ | 17.9 | 15.3 | 15.8 | 14.8 | 14.9 | 15.1 | 15.2 | 14.7 |
| 95% ロールオフ、kHz ↥ | 2.5 | 2.6 | 2.2 | 2.1 | 2.2 | 2.0 | 1.7 | 1.7 |
| サブ帯域 20–60 Hz の比率、dB ↥ | -8.6 | -10.2 | -10.0 | -9.6 | -9.9 | -10.4 | -10.0 | -9.8 |
| 納品時のラウドネス、LUFS → −14 | -15.5 | -14.3 | -14.5 | -14.7 | -14.7 | -14.4 | -14.6 | -14.8 |
| 納品時のトゥルーピーク、dBTP → −1.0 | -3.4 | -0.5 | -0.2 | -0.2 | -0.1 | -0.2 | -0.3 | -0.1 |
| 低音 60–150 Hz の比率、dB ↥ | -6.0 | -5.6 | -4.3 | -4.8 | -4.5 | -4.5 | -4.4 | -4.8 |
| プレゼンス 2–5 kHz の比率、dB ↥ | -17.1 | -16.6 | -16.0 | -16.3 | -16.2 | -16.2 | -17.3 | -16.9 |
| クレストファクター、dB ↥ | 14.4 | 15.7 | 16.5 | 16.5 | 16.6 | 16.3 | 16.2 | 16.6 |
| ラウドネスレンジ、LU ↥ | 5.9 | 6.2 | 7.1 | 6.6 | 6.5 | 6.4 | 6.6 | 7.1 |
| ラウドネスのばらつき p95−p10、dB ↥ | 9.4 | 9.0 | 11.5 | 10.8 | 10.4 | 10.3 | 10.8 | 11.7 |
| 低域のばらつき p95−p10、dB ↥ | 23.3 | 20.0 | 21.9 | 21.1 | 20.6 | 19.7 | 22.0 | 22.6 |
| 中域のステレオ相関 ↥ | 0.67 | 0.69 | 0.75 | 0.77 | 0.73 | 0.74 | 0.77 | 0.76 |
| 長さ、秒 ↥ | 156.8 | 154.5 | 148.6 | 148.1 | 154.8 | 151.9 | 152.8 | 149.7 |
1 位 · 2 位 · 3 位:各行の 8 つのうち上位 3 つ、1 位は太字も。↥ は高いほど良い、↧ は低いほど良い、→ は示した値に近いほど良い(トゥルーピークは下から)。同じ数字のセルは同じ色です。
8 つの側すべてを、ミックスも声も同じように、RTX 3090 上の Whisper large-v3 で聴いています。Whisper の 1 行目はミックス、2 行目は分離した声です。声は BS-Roformer が各テイクの声をすべて音楽から分離したもの(リード、バッキング、合唱をまとめて。リードだけにはしません)です。音楽がないと Whisper はときに行を丸ごと聞き落とし、誰も歌っていない言葉を間に書き込みます。どの側でも起きるので、2 つの行は並べて読んでください。
FW と TW は、私たちが YuE2 3B をファインチューンした 2 つのモデルのコードネームで、First Wave と Tsunami Wave です。Tsunami Wave は 109,250 曲・約 6,650 時間で学習しました。時間の 66.7% がインストゥルメンタル、31.6% が歌、1.8% が語りです。声の言語は英語(時間の 7.0%)、ロシア語(5.8%)、ヘブライ語(1.7%)、ギリシャ語とウクライナ語(各 0.6%)、フランス語とスペイン語(各 0.5%)、ポルトガル語(0.3%)、イタリア語(0.2%)、さらに各 0.1% 未満の 14 言語です。時間の 15.9% は声が聞こえるものの、その言語は特定できていません。
相手の曲はマスタリング済み、私たちのものはデコーダーそのままのレベルの未加工で、ピークは一つも削っていません。ラウドネスはマスタリングに任せ、それはスタジオの仕上げ師の仕事です。別のシードや別のプロンプトでは、どの側も違って聞こえます。リングが示すのは品質とばらつきであり、最終的な順位ではありません。表の全体と計測方法:モデルカード。
私たちの 2 つのファインチューンが受け取ったすべての語を、数えて検索できるようにしました。Tsunami Wave の学習データ 109,250 曲と、その前のファーストウェーブの 32,633 曲です。ジャンル、楽器、声、音そのものに付けられた感情語、調と BPM、そして楽譜のフィールド。モデルに何を伝えたかを公開するファインチューンはほとんどありません。
聴く代わりに測ったリング:280 テイク。私たちの 6 つの側にそれぞれ 40、SUNO v6 が 20、Musicful V3 が 20 です。どのテイクもまず −14 LUFS にそろえ、音の大きさで勝つものがないようにしました。どの曲線も、そのテイク全体のパワーに対する帯域ごとのレベルなので、比べているのは形だけです。私たちのものはエンジンからの未加工の出力、相手のものはマスタリング済みなので、下に見える差の一部はマスタリングによるものです。
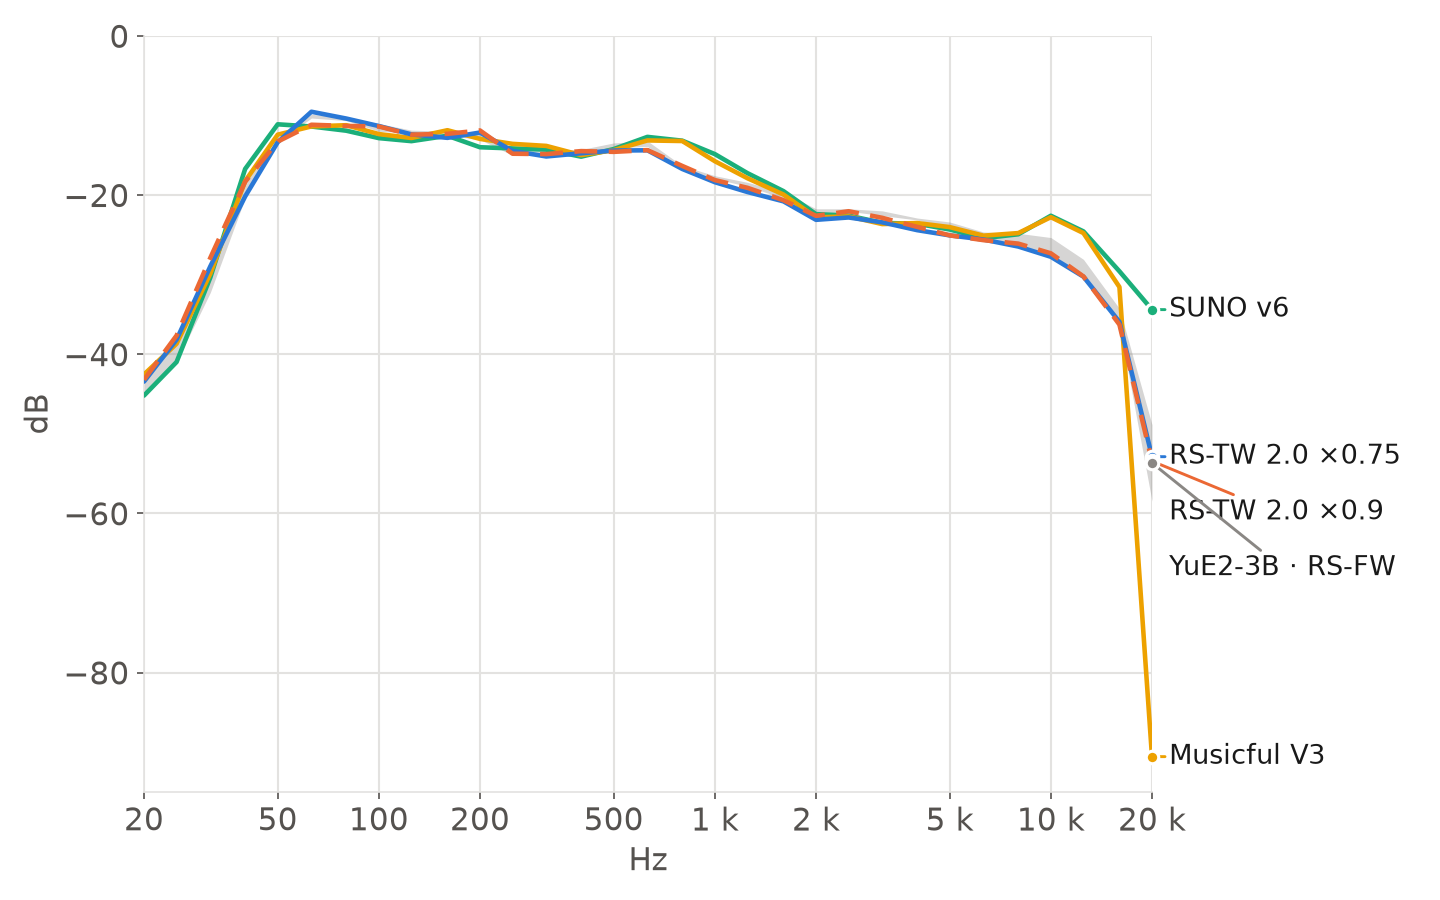
100 Hz から 10 kHz まで、8 つの側すべての平均曲線は互いに 5.2 dB 以内に収まります。16 kHz より上で分かれます。Musicful V3 は 40 テイク中 38 テイクで 16 kHz より上に何も残していません。20 kHz での平均は −90.6 dB、ほかが坂を描くところで壁になっています。そこで最も多く残しているのは SUNO v6 で、16–20 kHz で −31.0 dB。私たちのものは −39.3 から −42.3 dB で、ときには 16 kHz で止まることもあります。40 テイク中 1〜6 テイクで、最も多いのは RS-TW 2.0 ×0.9 です。
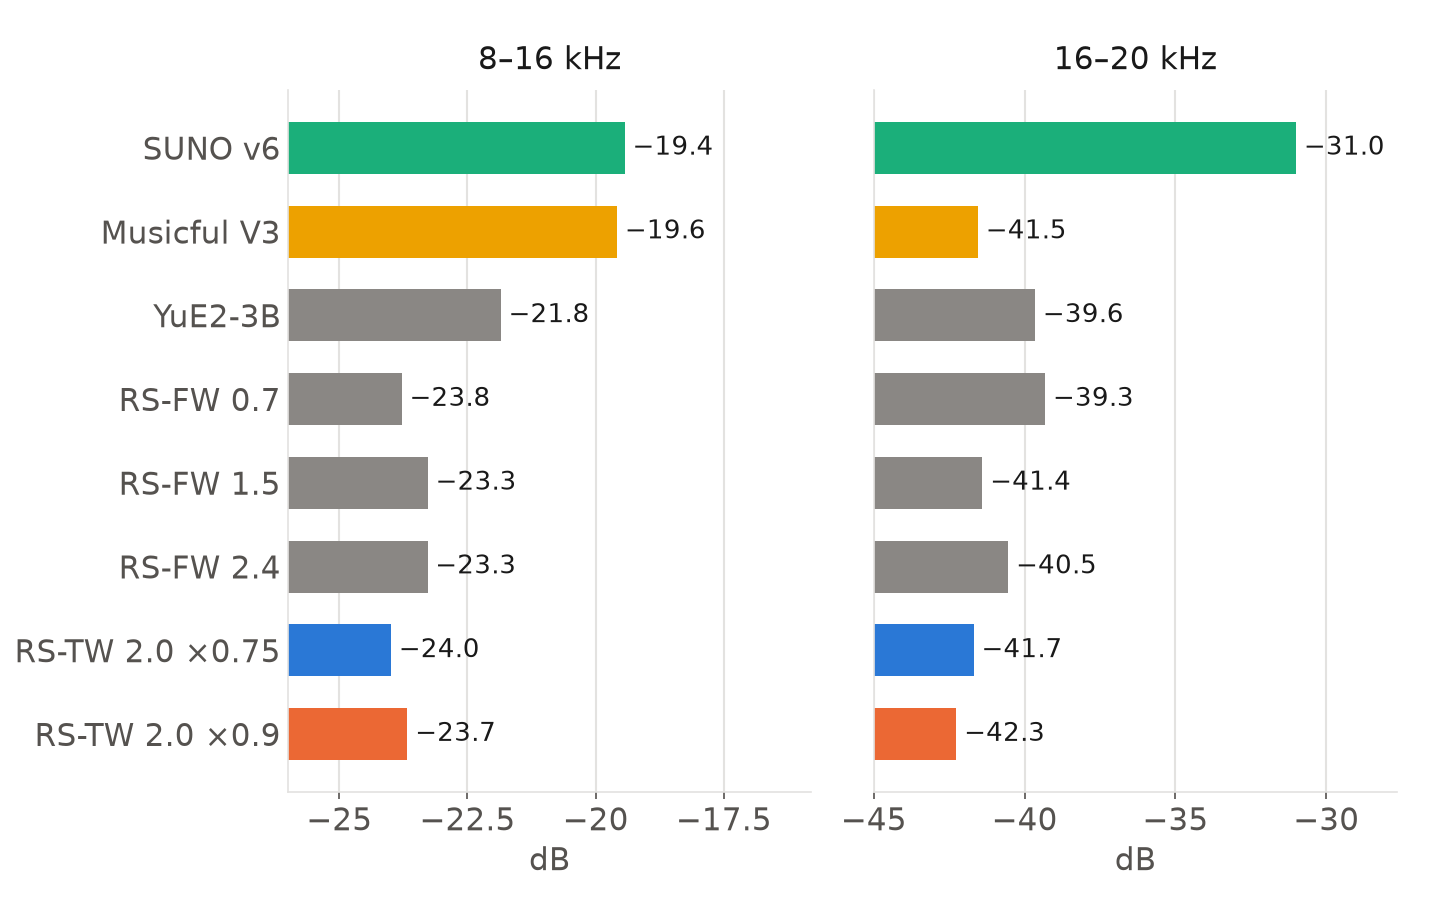
空気感の帯域 8–16 kHz では、SUNO v6 と Musicful V3 がテイクのパワーに対して −19.4 dB と −19.6 dB、私たちの 6 つの側は −21.8 から −24.0 dB です。マスタリングはふつう空気感を持ち上げますが、私たちのものにはまだ何も施されていません。スタジオでは、歌い終えたあとの仕上げ師の仕事です。
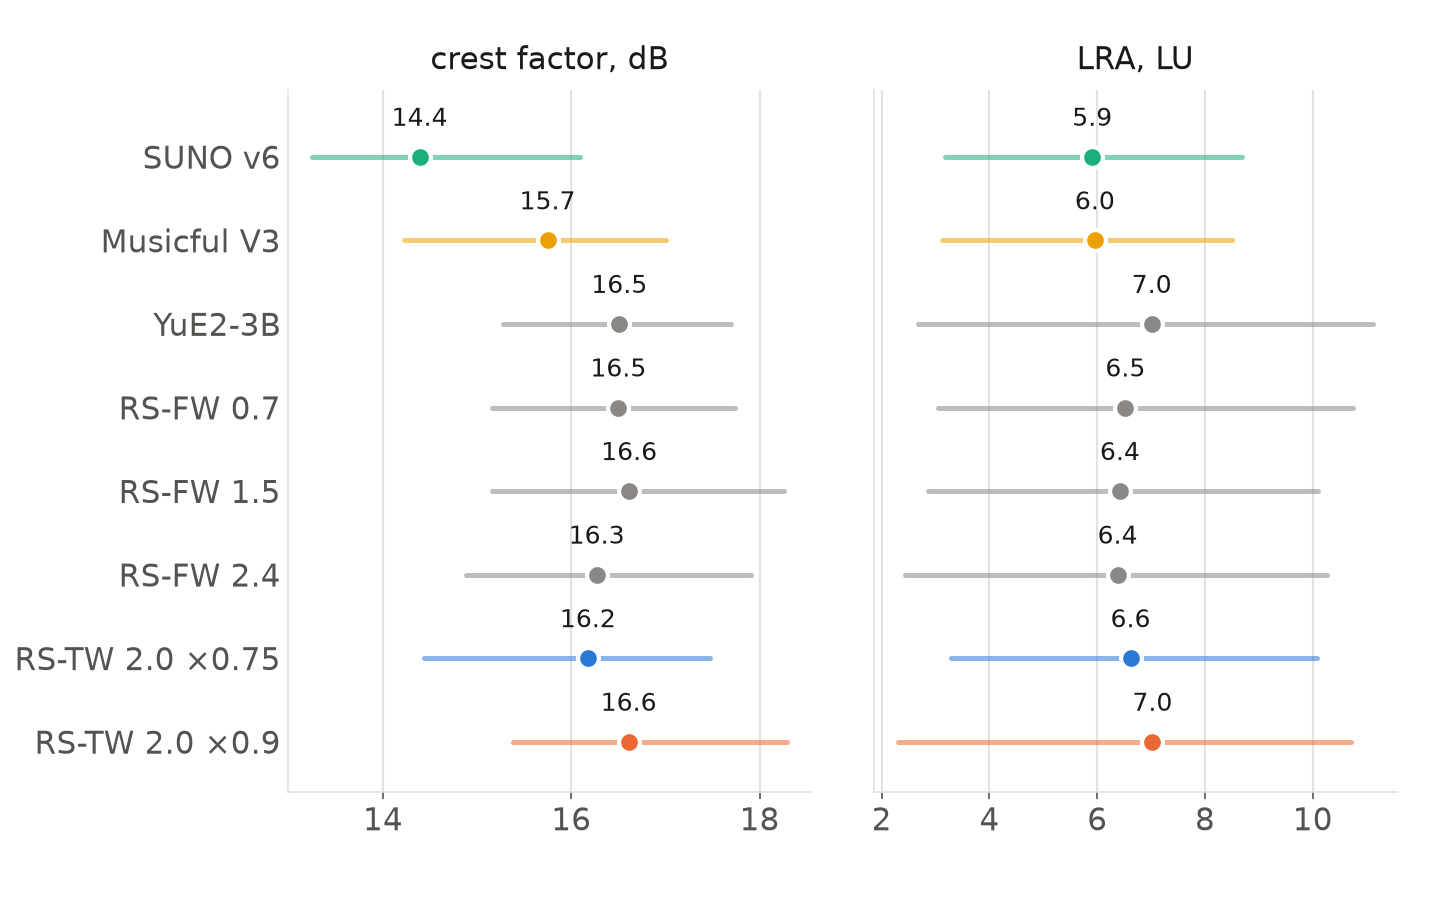
クレストファクター(平均に対するピーク):SUNO v6 は 14.4 dB、Musicful V3 は 15.7 dB、私たちのものは 16.2 から 16.6 dB。ラウドネスレンジ:相手は 5.9 と 6.0 LU、私たちは 6.4 から 7.0 LU。RS-TW 2.0 ×0.9 は私たちのファインチューンで最も幅が広く、16.6 dB と 7.0 LU、標準の YuE2-3B(16.5 dB、7.0 LU)と同じ広さです。数字で見るその地殻変動です。×0.75 はより引き締まっていて、16.2 dB と 6.6 LU です。
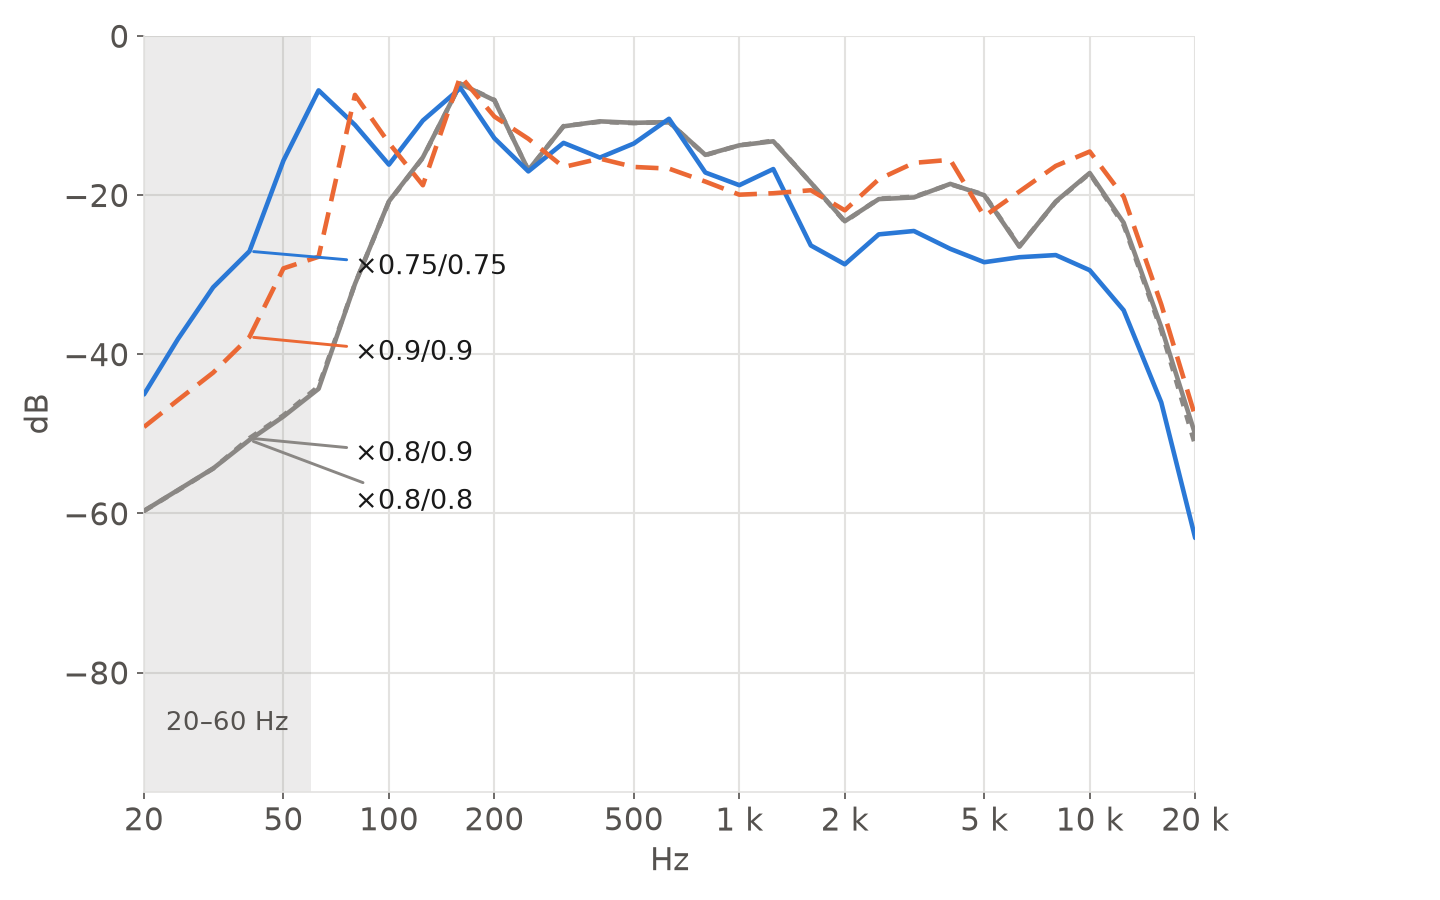
ブラインドセット:12 枚のカードを、RS-FW 2.4 の上で Tsunami Wave の 4 つの強さで歌わせ、どの強さでも同じシードを使いました。ギリシャ語の詩編 22 では、×0.75/0.75 から ×0.8/0.8 への一歩でサブベース 20–60 Hz から 36 dB が消え、−7.9 dB から −44.3 dB になりました。歌の足もとから床が抜けたのです。12 枚全体では揺れはもっと穏やかで、サブベースは ×0.75/0.75 で −8.5 dB、ほかの 3 つで −10.4 から −11.0 dB。×0.75/0.75 は 12 枚中 6 枚でリング自身の中央値曲線に最も近く、平均距離は 4.1 dB、ほかは 4.8〜5.2 dB でした。だから 2.0.6 ではスタジオの既定が ×0.75 になり、×0.9 は安定を約束しないほうになります。
CPU 上で私たち自身のコードで測定:Welch スペクトルからの 1/3 オクターブ帯域、ラウドネスとそのレンジは ITU-R BS.1770-4 と EBU Tech 3342 に従っています。どの図もクリックで大きく開きます。
リングの 280 テイクを、その広がりで測りました。4 つの帯域それぞれで、2 つのチャンネルの差の半分であるサイドを、和の半分であるミッドと比べます。ミッドに対するサイドが dB で高いほど、その帯域は広く聞こえます。モノラルのテイクにはサイドがまったくありません。パノラマは、左右のチャンネルのレベル差がテイクの中でどこまで振れるかを、5 パーセンタイルから 95 パーセンタイルまでの幅として dB で示したものです。数字はどれも各側のテイクの中央値で、SUNO v6 と Musicful V3 は 20 テイク、私たちのものはそれぞれ 40 テイクです。ここでは広いほど良いのではなく、ただ広いだけです。この表には順位がありません。
4 つの帯域でのミッドに対するサイド(dB、各側のテイクの中央値)。高いほど広がります。
| 未加工で計測、中央値 | ミッドに対するサイド、dB | パノラマ、dB | |||
|---|---|---|---|---|---|
| 低域 20–200 Hz | 中域 0.2–2 kHz | 高域 2–8 kHz | 空気感 8–20 kHz | ||
| SUNO v6 | −12.5 | −7.0 | −6.8 | −9.6 | 6.4 |
| Musicful V3 | −13.0 | −7.2 | −5.9 | −7.9 | 6.6 |
| YuE2-3B | −17.4 | −8.2 | −7.9 | −10.6 | 6.4 |
| RS-FW 0.7 | −17.2 | −8.5 | −7.3 | −10.9 | 5.9 |
| RS-FW 1.5 | −17.4 | −7.5 | −6.6 | −10.2 | 6.3 |
| RS-FW 2.4 | −16.5 | −8.0 | −7.9 | −11.2 | 6.4 |
| RS-TW 2.0 ×0.75 | −19.0 | −8.1 | −7.9 | −11.6 | 6.0 |
| RS-TW 2.0 ×0.9 | −20.1 | −8.9 | −8.2 | −12.0 | 5.9 |
私たちのマージは、中域と高域を標準の YuE2-3B と同じところに保ち、差はどれも 1.3 dB 以内です。RS-TW 2.0 は両端が少し狭く、×0.75 は低域で 1.6 dB、空気感で 1.0 dB、パノラマで 0.4 dB、×0.9 は 2.7、1.4、0.5 dB 狭くなります。SUNO v6 と Musicful V3 は低域を標準の YuE2-3B より 4.9 dB と 4.4 dB 広げています。
Viktor の耳には、RS-TW 2.0 の狭まった両端は失われたステレオではなく、より落ち着いた響きに聞こえます。標準の YuE2-3B はギターを片方のチャンネルに 15〜20 秒とどめることがよくあります。
CPU 上の自前のコードで測りました。各テイクの最初の 240 秒について 50 ms ごとに 4096 点の短時間スペクトルを取り、ミッドとサイドは (L+R)/2 と (L−R)/2、パノラマは 200 Hz – 8 kHz でのチャンネル間のレベル差から、テイクの最大音量から 40 dB 以内の瞬間で求めています。
fetch-models.sh が取得し、固定し、検証)。絵師のモデルはさらに 39–43 GB、💎 セットは 5.6 GB、どちらも求めたときだけ無料のクラウド GPU では動きません。Ruach Studio は Google Colab や Kaggle、無料のノートブック用 GPU では動かないので、そこで一晩を費やさないでください。ノートブックではなく、まるごとのスタジオです。住むマシンの上で C++/CUDA のエンジンをビルドし、その横でサーバーと Python のラボを動かし続け、ディスクを約 34–41 GB(絵師込みで 74–84 GB)使います。無料セッションのカード、メモリ、消えるディスク、数時間の制限では支えきれません。自分の Linux マシンか、借りて持ち続けるサーバーに NVIDIA のカードを。すべてに 24 GB、小さいモデルのコピーなら 16 GB です。
スタジオのリポジトリの固定リストと新規インストールのディスクで、ファイルごとに計測(1 GB = 10⁹ バイト)。インストールで入るのはクリエイター、司書、仕上げ師のチェーン。ほかの部屋は求めたときだけ、エンジン → モデルと LoRA → 部屋ごと から。先に空き容量を測り、収まらないものは取得しません。
| 24 GB のカード | 12–16 GB のカード | 8 GB のカード | |
|---|---|---|---|
| プログラムと、ここでビルドするエンジン(ダウンロード 0.2 GB) | 0.9 GB | 0.9 GB | 0.9 GB |
| 二つの Python、それぞれに CUDA 12.8 用の PyTorch(ダウンロード 8.7 GB) | 16.5 GB | 16.5 GB | 16.5 GB |
| YuE2 と Ruach Studio 独自のファインチューン、カードに合う量子化で | 14.9 GB | 8.2 GB | 8.2 GB |
| 残り:追加のデコーダー二つ、トランスクライバー、Whisper、ステムのモデル、UniverSR と Apollo-vocal、LoRA | 8.8 GB | 8.8 GB | 8.8 GB |
| インストール | 41.1 GB | 34.4 GB | 34.4 GB |
| + ライター:llama.cpp で動く言語モデル | 7.4 GB | 7.4 GB | 6.2 GB |
| + 仕上げ師:MuScriptor と FlashSR | 6.1 GB | 6.1 GB | 6.1 GB |
| + 絵師:助手と Qwen-Image 2512(24 GB で Q6、それ未満は Q4) | 42.9 GB | 39.3 GB | 39.3 GB |
| + 映像師:MiniMax H3 と SeedVR2 | 86.3 GB | 24 GB が必要 | 24 GB が必要 |
| + LoRA トレーナー:ベースとスタイルの聞き手 | 20.2 GB | 16.3 GB | 12.9 GB |
| すべての部屋 | 204.0 GB | 103.5 GB | 98.9 GB |
名前で求めたときだけ:ほかのサウンドエンジン(IRA、IRAE、RS-FW のマージ、量子化により 35〜86 GB)、絵師のアダプター(7.5 GB)とファインチューン(各 20.4 GB)、MiniMax H3 の全ティア(201 GB)または BF16(478 GB)、💎 セット(5.6 GB)。含まないもの:NVIDIA のドライバーと CUDA toolkit、Pianoteq(各自で購入)、あなたのテイク。
2.0.5 は、私たちが毎日自分の曲を作っている Studio です。2.1.0 以降に向けて進んでいる大きな部分はこちら。
Viktor Zhuromskyy, the author of Ruach Studio, does not publish it for the hype. He made it for himself. After more than half a year of struggling with Suno on paid plans, and of searching for a model worth working with (ACE-Step, MiniMax and others), he set out to build an audio studio of his own, on his own machine. He settled on YuE2: of all the open models, it is the best value and the most refined.
He did not knock the Studio together just to have something that runs. He built it his own way, because his creative work is his own too, refined and one of a kind: his translations, his interlinear texts and much more. He fit into it as much as he could, polished the interface as far as he could, and made creating in it not poking and clicking among crutches and potholes, but as productive as it can be.
That is the whole story. Now the Studio is yours as well.
Виктор Журомский, автор Ruach Studio, публикует её не ради хайпа. Он делал её для себя. После более чем полугода мучений с Suno на платных тарифах и поисков достойной модели (ACE-Step, MiniMax и другие) он взялся построить собственную аудиостудию, на своей машине. Выбор пал на YuE2: из всех открытых моделей она самая рентабельная и самая изысканная.
Студию он делал не тяп-ляп, лишь бы работало, а в своём стиле, потому что и творчество у него своё, изысканное и неповторимое: собственные переводы, подстрочники и многое другое. Он постарался вместить в неё максимум, отполировать интерфейс до блеска и сделать творчество в Студии не тыканьем и кликаньем среди костылей и ям, а по-настоящему продуктивным.
Вот и вся история. Теперь эта Студия и ваша.
Віктор Журомський, автор Ruach Studio, публікує її не заради хайпу. Він творив її для себе. Після понад пів року мук із Suno на платних тарифах і пошуків гідної моделі (ACE-Step, MiniMax та інші) він узявся збудувати власну аудіостудію, на своїй машині. Вибір упав на YuE2: з усіх відкритих моделей вона найвигідніша й найвишуканіша.
Студію він творив не абияк, аби лиш працювало, а у своєму стилі, бо й творчість у нього своя, вишукана й неповторна: власні переклади, підрядники та багато іншого. Він намагався вмістити в неї максимум, відшліфувати інтерфейс до блиску, щоб творчість у Студії була не тицянням і клацанням серед милиць і ям, а справді продуктивною.
Ось і вся історія. Тепер ця Студія і ваша.
Віктар Журомскі, аўтар Ruach Studio, публікуе яе не дзеля хайпу. Ён тварыў яе для сябе. Пасля больш як паўгода пакут з Suno на платных тарыфах і пошукаў годнай мадэлі (ACE-Step, MiniMax і іншыя) ён узяўся пабудаваць уласную аўдыястудыю, на сваёй машыне. Выбар упаў на YuE2: з усіх адкрытых мадэляў яна самая выгадная і самая вытанчаная.
Студыю ён тварыў не абы-як, абы працавала, а ў сваім стылі, бо і творчасць у яго свая, вытанчаная і непаўторная: уласныя пераклады, падрадкоўнікі і шмат іншага. Ён стараўся змясціць у яе максімум, адшліфаваць інтэрфейс да бляску, каб творчасць у Студыі была не тыцканнем і клікамі сярод мыліц і ям, а сапраўды прадуктыўнай.
Вось і ўся гісторыя. Цяпер гэтая Студыя і ваша.
Ο Viktor Zhuromskyy, ο δημιουργός του Ruach Studio, δεν το δημοσιεύει για εντυπωσιασμό. Το έφτιαξε για τον εαυτό του. Ύστερα από περισσότερους από έξι μήνες ταλαιπωρίας με το Suno σε πληρωμένα πακέτα, και αναζήτησης ενός μοντέλου που να αξίζει (ACE-Step, MiniMax και άλλα), αποφάσισε να φτιάξει ένα δικό του στούντιο ήχου, στο δικό του μηχάνημα. Κατέληξε στο YuE2: από όλα τα ανοιχτά μοντέλα είναι το πιο συμφέρον και το πιο εκλεπτυσμένο.
Δεν έστησε το Στούντιο πρόχειρα, απλώς για να λειτουργεί. Το έφτιαξε με το δικό του ύφος, γιατί και η δημιουργία του είναι δική του, εκλεπτυσμένη και μοναδική: οι μεταφράσεις του, τα διάστιχα κείμενά του και πολλά άλλα. Προσπάθησε να χωρέσει σε αυτό όσο περισσότερα γινόταν, να γυαλίσει το περιβάλλον ως την τελευταία λεπτομέρεια και να κάνει τη δημιουργία στο Στούντιο όχι άσκοπα κλικ ανάμεσα σε δεκανίκια και λακκούβες, αλλά κάτι πραγματικά παραγωγικό.
Αυτή είναι όλη η ιστορία. Τώρα το Στούντιο είναι και δικό σας.
Viktor Zhuromskyy, el autor de Ruach Studio, no lo publica para llamar la atención. Lo hizo para sí mismo. Tras más de medio año de sufrir con Suno en planes de pago y de buscar un modelo que mereciera la pena (ACE-Step, MiniMax y otros), se propuso construir su propio estudio de audio, en su propia máquina. Se quedó con YuE2: de todos los modelos abiertos, es el más rentable y el más refinado.
No montó el Estudio de cualquier manera, solo para que funcionara. Lo hizo a su estilo, porque su creación también es suya, refinada e irrepetible: sus traducciones, sus textos interlineales y mucho más. Procuró meter en él todo lo posible, pulir la interfaz hasta el último detalle y hacer que crear en el Estudio no sea dar clics a ciegas entre muletas y baches, sino algo de verdad productivo.
Esa es toda la historia. Ahora el Estudio también es tuyo.
Viktor Zhuromskyy, l'autore di Ruach Studio, non lo pubblica per fare clamore. Lo ha costruito per sé. Dopo più di sei mesi di tormenti con Suno sui piani a pagamento, e di ricerche di un modello all'altezza (ACE-Step, MiniMax e altri), ha deciso di crearsi uno studio audio tutto suo, sulla sua macchina. La scelta è caduta su YuE2: fra tutti i modelli aperti è il più conveniente e il più raffinato.
Non ha messo insieme lo Studio alla buona, giusto perché funzionasse. Lo ha fatto a modo suo, perché anche la sua opera creativa è sua, raffinata e irripetibile: le sue traduzioni, i suoi testi interlineari e molto altro. Ha cercato di farci stare il massimo, di rifinire l'interfaccia fino all'ultimo dettaglio e di rendere il creare nello Studio non un cliccare a vuoto tra stampelle e buche, ma qualcosa di davvero produttivo.
Questa è tutta la storia. Ora lo Studio è anche tuo.
Viktor Zhuromskyy, l'auteur de Ruach Studio, ne le publie pas pour faire parler de lui. Il l'a fait pour lui-même. Après plus de six mois à se débattre avec Suno sur des formules payantes, et à chercher un modèle qui en vaille la peine (ACE-Step, MiniMax et d'autres), il s'est mis à construire son propre studio audio, sur sa propre machine. Son choix s'est arrêté sur YuE2 : de tous les modèles ouverts, c'est le plus rentable et le plus raffiné.
Il n'a pas bricolé le Studio à la va-vite, juste pour avoir quelque chose qui tourne. Il l'a fait à sa manière, parce que sa création est la sienne, raffinée et inimitable : ses traductions, ses textes interlinéaires et bien plus encore. Il y a fait entrer tout ce qu'il a pu, a poli l'interface aussi loin qu'il a pu, et a fait de la création dans le Studio non pas un tâtonnement de clics entre béquilles et nids-de-poule, mais quelque chose de vraiment productif.
Voilà toute l'histoire. Maintenant, le Studio est aussi à toi.
Viktor Zhuromskyy, o autor do Ruach Studio, não o publica pelo hype. Ele o fez para si mesmo. Depois de mais de meio ano sofrendo com o Suno em planos pagos, e procurando um modelo que valesse a pena (ACE-Step, MiniMax e outros), ele decidiu construir o seu próprio estúdio de áudio, na sua própria máquina. A escolha caiu no YuE2: de todos os modelos abertos, é o de melhor custo-benefício e o mais refinado.
Ele não montou o Estúdio de qualquer jeito, só para ter algo que rodasse. Fez do seu jeito, porque a criação dele é dele, refinada e inimitável: as suas traduções, os seus textos interlineares e muito mais. Colocou nele o máximo que pôde, poliu a interface até onde pôde e fez da criação no Estúdio não um cutucar e clicar entre muletas e buracos, mas algo de fato produtivo.
Essa é a história toda. Agora o Estúdio também é seu.
Viktor Zhuromskyy, der Autor von Ruach Studio, veröffentlicht es nicht für den Hype. Er hat es für sich selbst gemacht. Nach mehr als einem halben Jahr Mühe mit Suno in bezahlten Tarifen und der Suche nach einem Modell, mit dem sich arbeiten lässt (ACE-Step, MiniMax und andere), machte er sich daran, ein eigenes Audiostudio zu bauen, auf seiner eigenen Maschine. Die Wahl fiel auf YuE2: von allen offenen Modellen das lohnendste und das ausgefeilteste.
Er hat das Studio nicht zusammengeschustert, nur damit irgendetwas läuft. Er hat es auf seine Art gebaut, denn auch sein Schaffen ist sein eigenes, erlesen und unverwechselbar: seine Übersetzungen, seine Interlinearübersetzungen und vieles mehr. Er hat so viel hineingepackt, wie er konnte, die Oberfläche poliert, so weit er konnte, und das Schaffen darin nicht zu einem Stochern und Klicken zwischen Krücken und Schlaglöchern gemacht, sondern zu etwas wirklich Produktivem.
Das ist die ganze Geschichte. Jetzt ist das Studio auch deins.
Ruach Studio の作者 Viktor Zhuromskyy は、話題づくりのためにこれを公開しているのではありません。自分のために作ったのです。有料プランで Suno と半年以上格闘し、取り組むに値するモデルを探し回った末に(ACE-Step、MiniMax ほか)、彼は自分のマシンの上に自分だけのオーディオスタジオを作ろうと決めました。選んだのは YuE2 でした。オープンなモデルの中で、最も割に合い、最も洗練されているからです。
彼は、とりあえず動けばいいという作り方はしませんでした。自分の流儀で作りました。彼の創作は彼自身のもの、洗練された唯一無二のものだからです:自身の翻訳、行間対訳のテキスト、そのほか多くのもの。詰め込めるだけ詰め込み、磨けるだけインターフェースを磨き、スタジオでの創作を、松葉杖と穴ぼこの間を手探りでクリックすることではなく、本当に生産的なものにしました。
話はこれで全部です。これからは、このスタジオはあなたのものでもあります。
Ruach Studio 的作者 Viktor Zhuromskyy 发布它并不是为了炒作。他是为自己做的。在付费套餐上和 Suno 折腾了半年多,又四处寻找值得投入的模型(ACE-Step、MiniMax 等)之后,他决定在自己的机器上搭建一个属于自己的音频工作室。他选定了 YuE2:在所有开放模型中,它最划算,也最精致。
他没有随便拼凑一个能跑就行的工作室,而是按自己的方式来做,因为他的创作也是他自己的,精致而独一无二:他的译本、他的逐行对照文本,还有许多别的。他尽可能多地装进其中,把界面打磨到力所能及的极致,让在这个工作室里的创作不再是在拐杖和坑洼之间胡乱点击,而是真正高效的事。
故事就是这样。现在,这个工作室也是你的了。