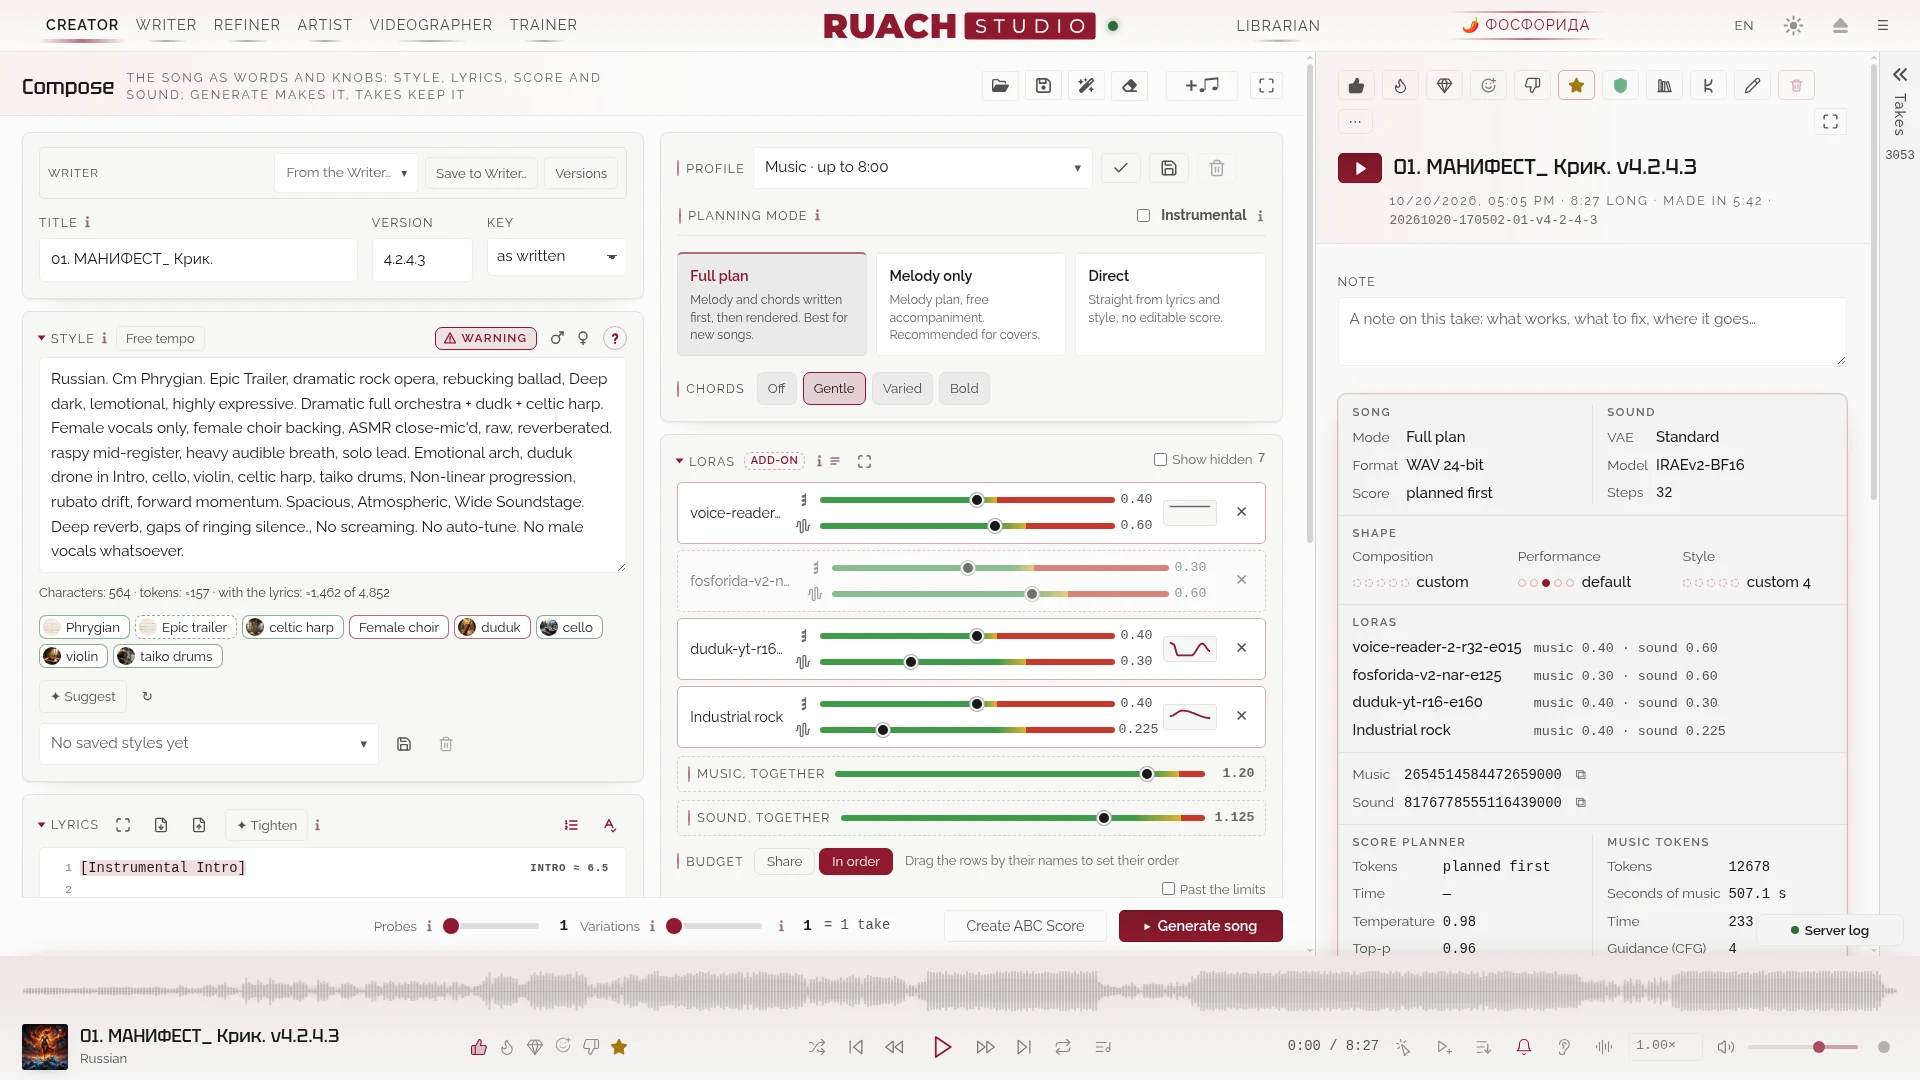
创作室
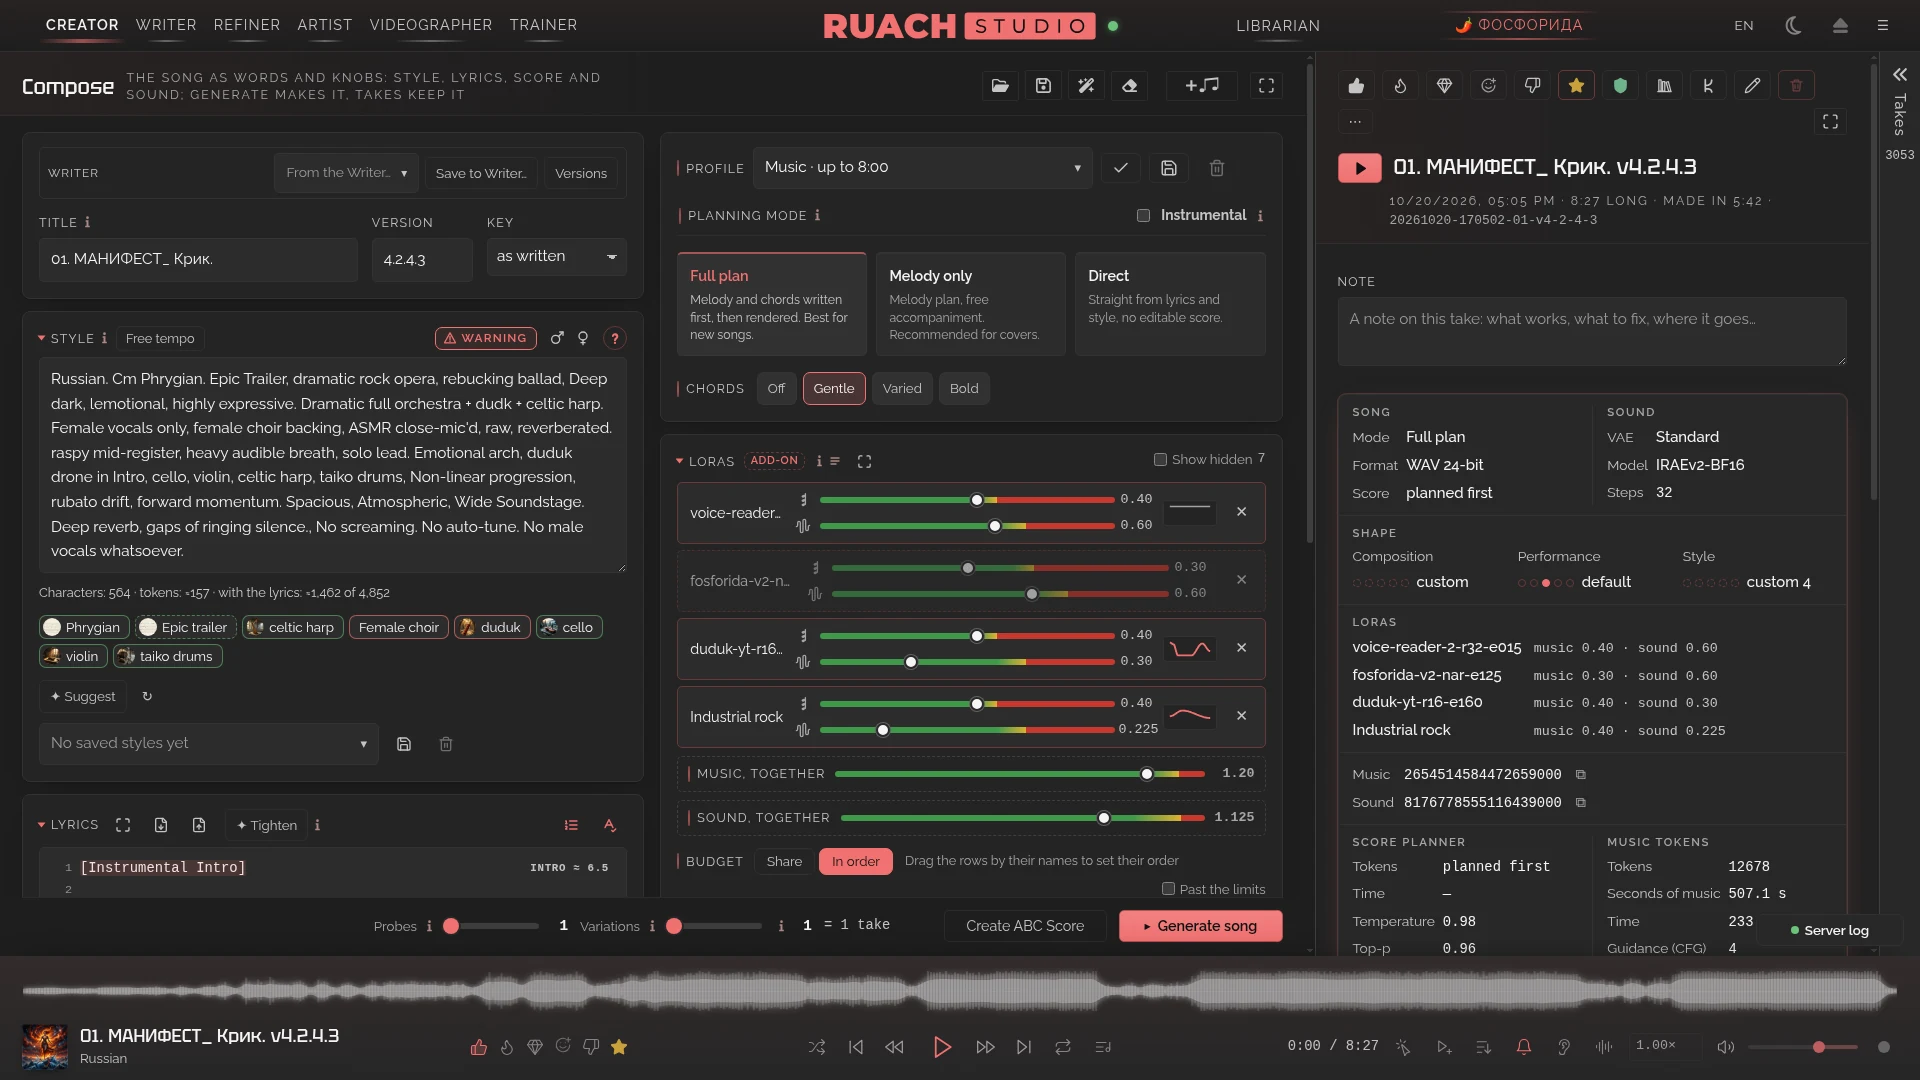
风格、歌词、规划模式、解码器、在由绿到红的道路上的 LoRA;录音附带它的乐谱、种子以及重做它所需的一切。
围绕开放歌曲模型 YuE2 的完整工作室。写下风格和歌词,工作室就在你自己的 GPU 上作曲、演唱并渲染歌曲。你的歌曲、文字和设置永远不会离开它。
2.0.5 · 每个峰值完整、家族树与 https 上的工作室 · 2026 年 11 月
Ruach Studio 是在你自己的硬件上运行的开放音乐生成:模型、乐谱、适配器和每一条录音都属于你,没有任何东西按 token 出租。开放模型如今已经足够好,可以独立站稳;缺少的是围绕它们的工作室:这正是我们公开建造的东西。
音乐应当可以自由地创作、自由地分享:没有嗓音、没有乐器、也没有录音室的人,同样有权把自己的思想和感受托付给声音。
创作室做出歌曲,写作室与聊天模型一起写它,精修室完成它,画室为它画图,影像室为它策划音乐视频,资料馆收藏每一段录音,LoRA 训练室把你自己的歌教给 YuE2。每个房间的指南都在工作室里。
风格、歌词、规划模式、解码器、在由绿到红的道路上的 LoRA;录音附带它的乐谱、种子以及重做它所需的一切。
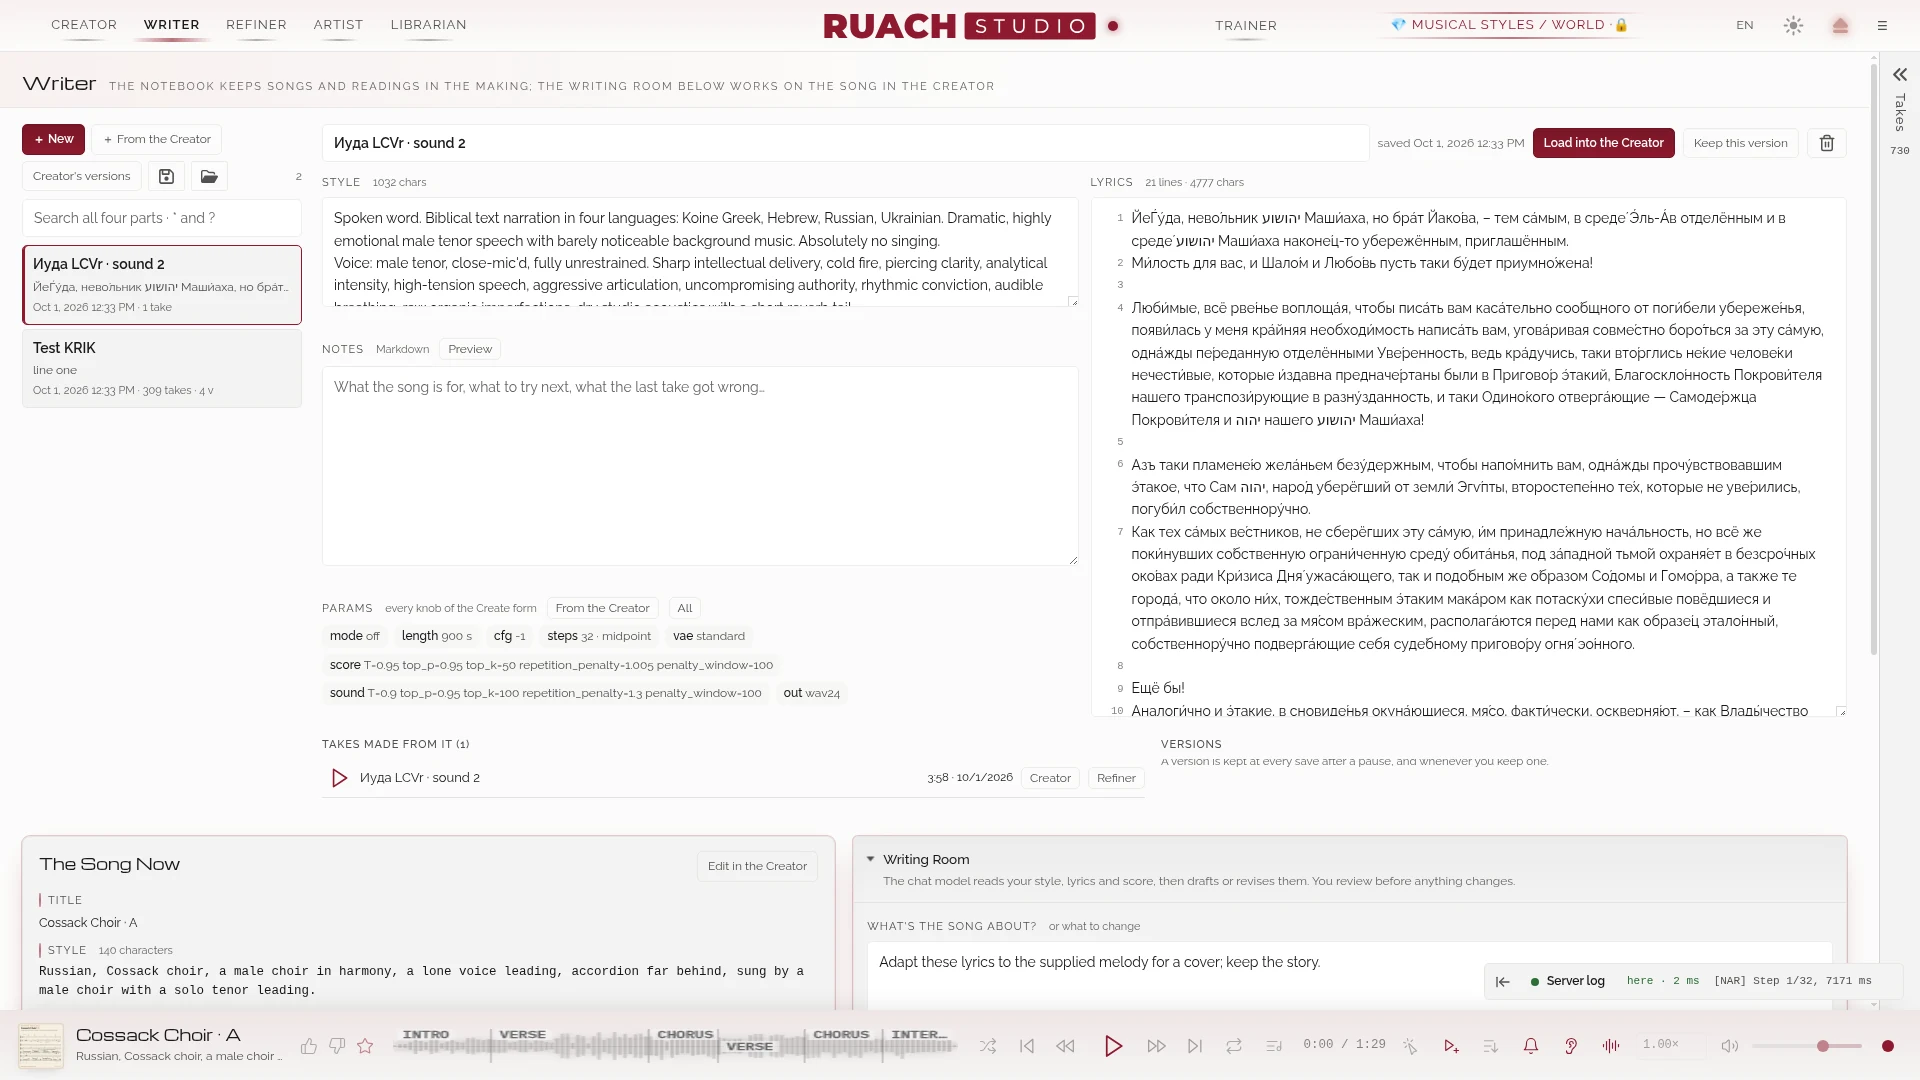
把歌曲当作带版本的文档,文本配置,以及你自己的聊天模型(或 OpenRouter)与你一起起草和修改。
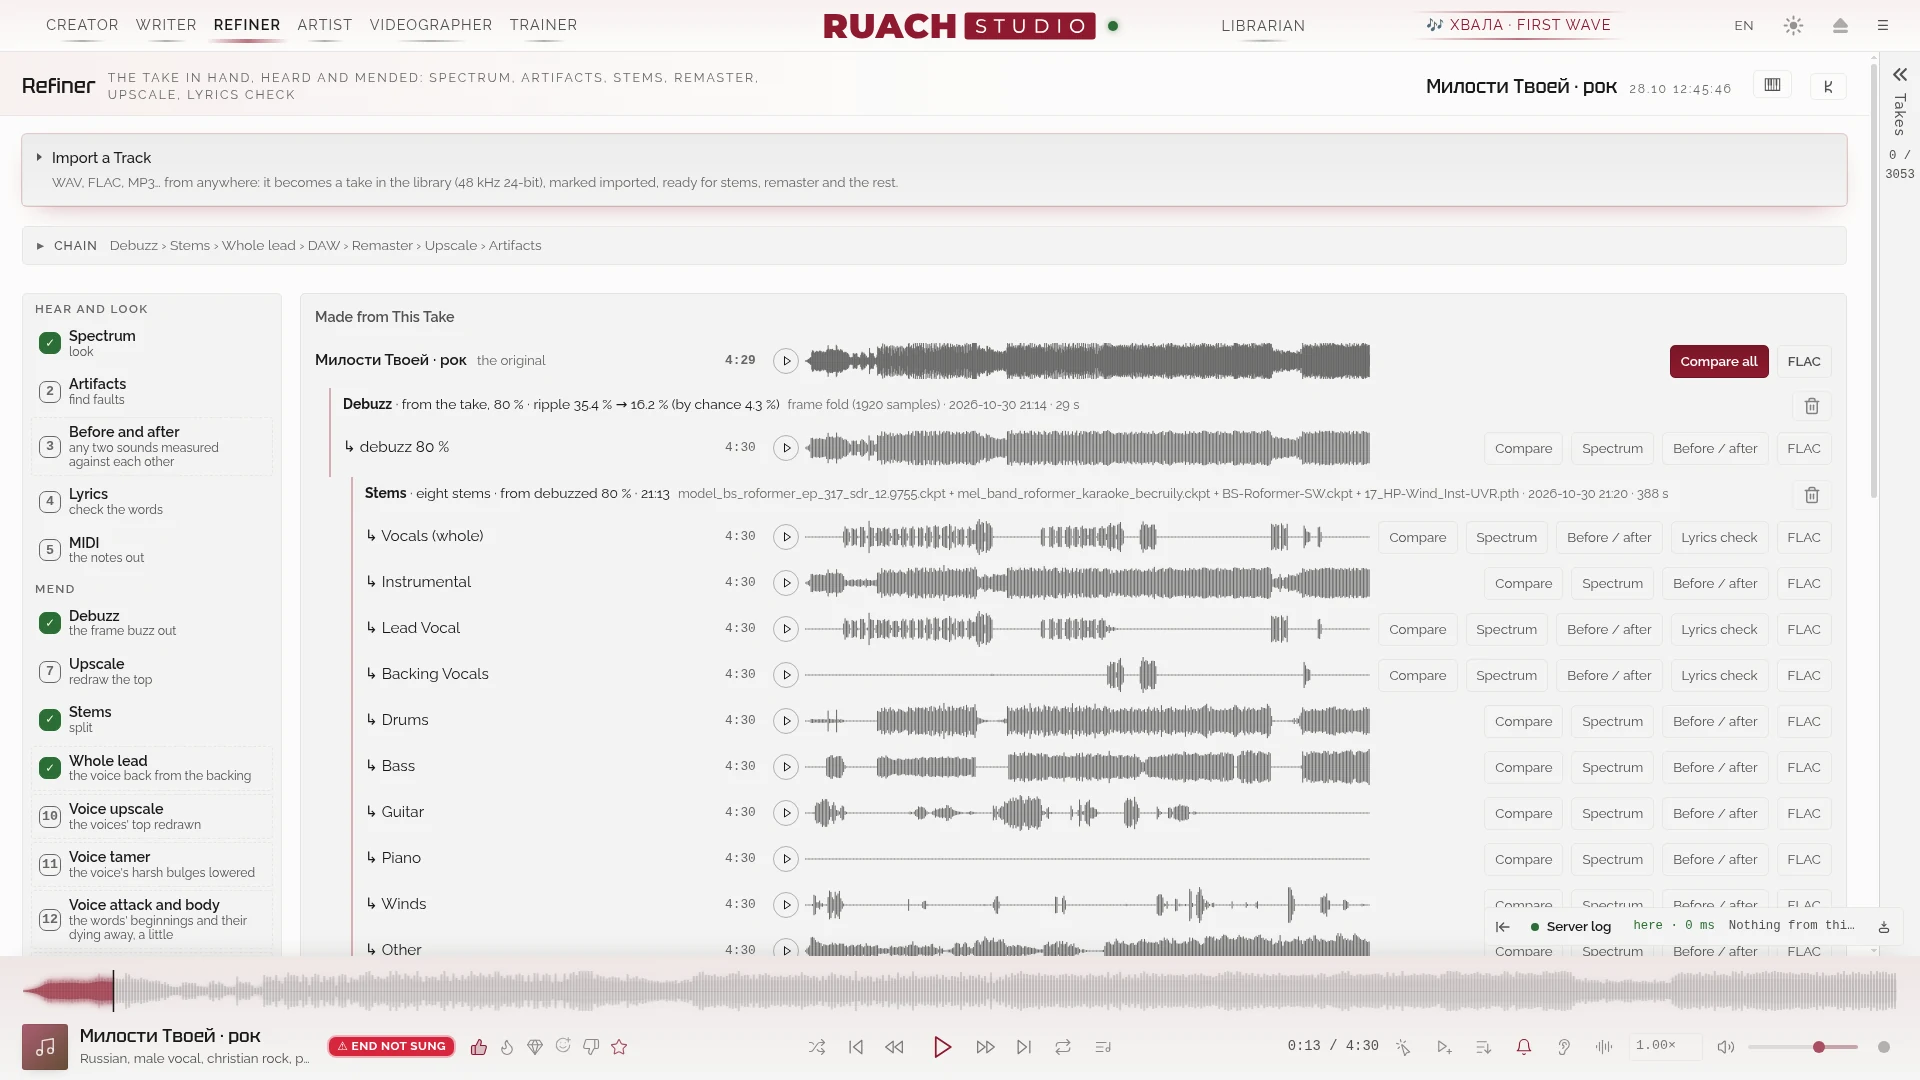
频谱、伪影、去嗡声、Whisper 歌词检查、分轨、母带处理、超分;一条链运行全部。
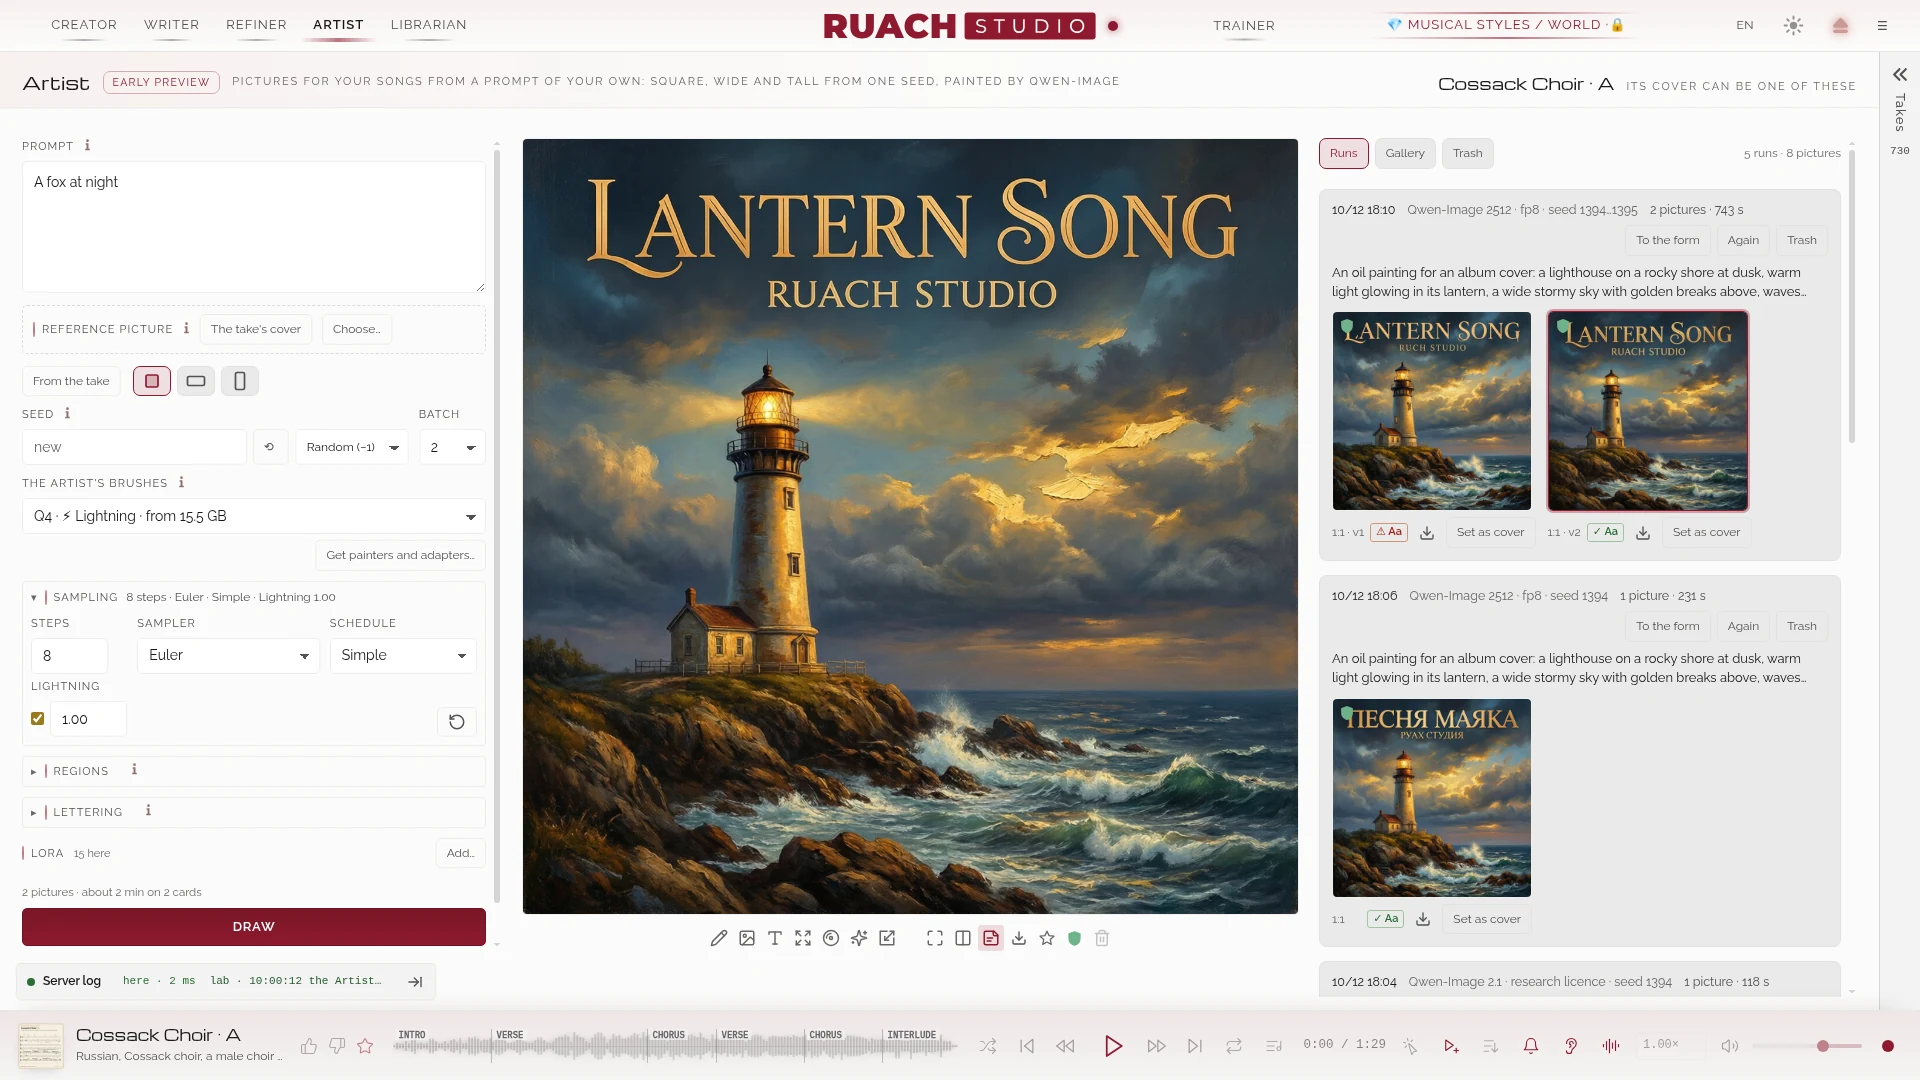
用你自己的提示词为歌曲作画:正方、横幅和竖幅出自同一个种子,由 Qwen-Image 2512 绘制;画面在你眼前显现,正方的那张成为录音的封面。早期预览。
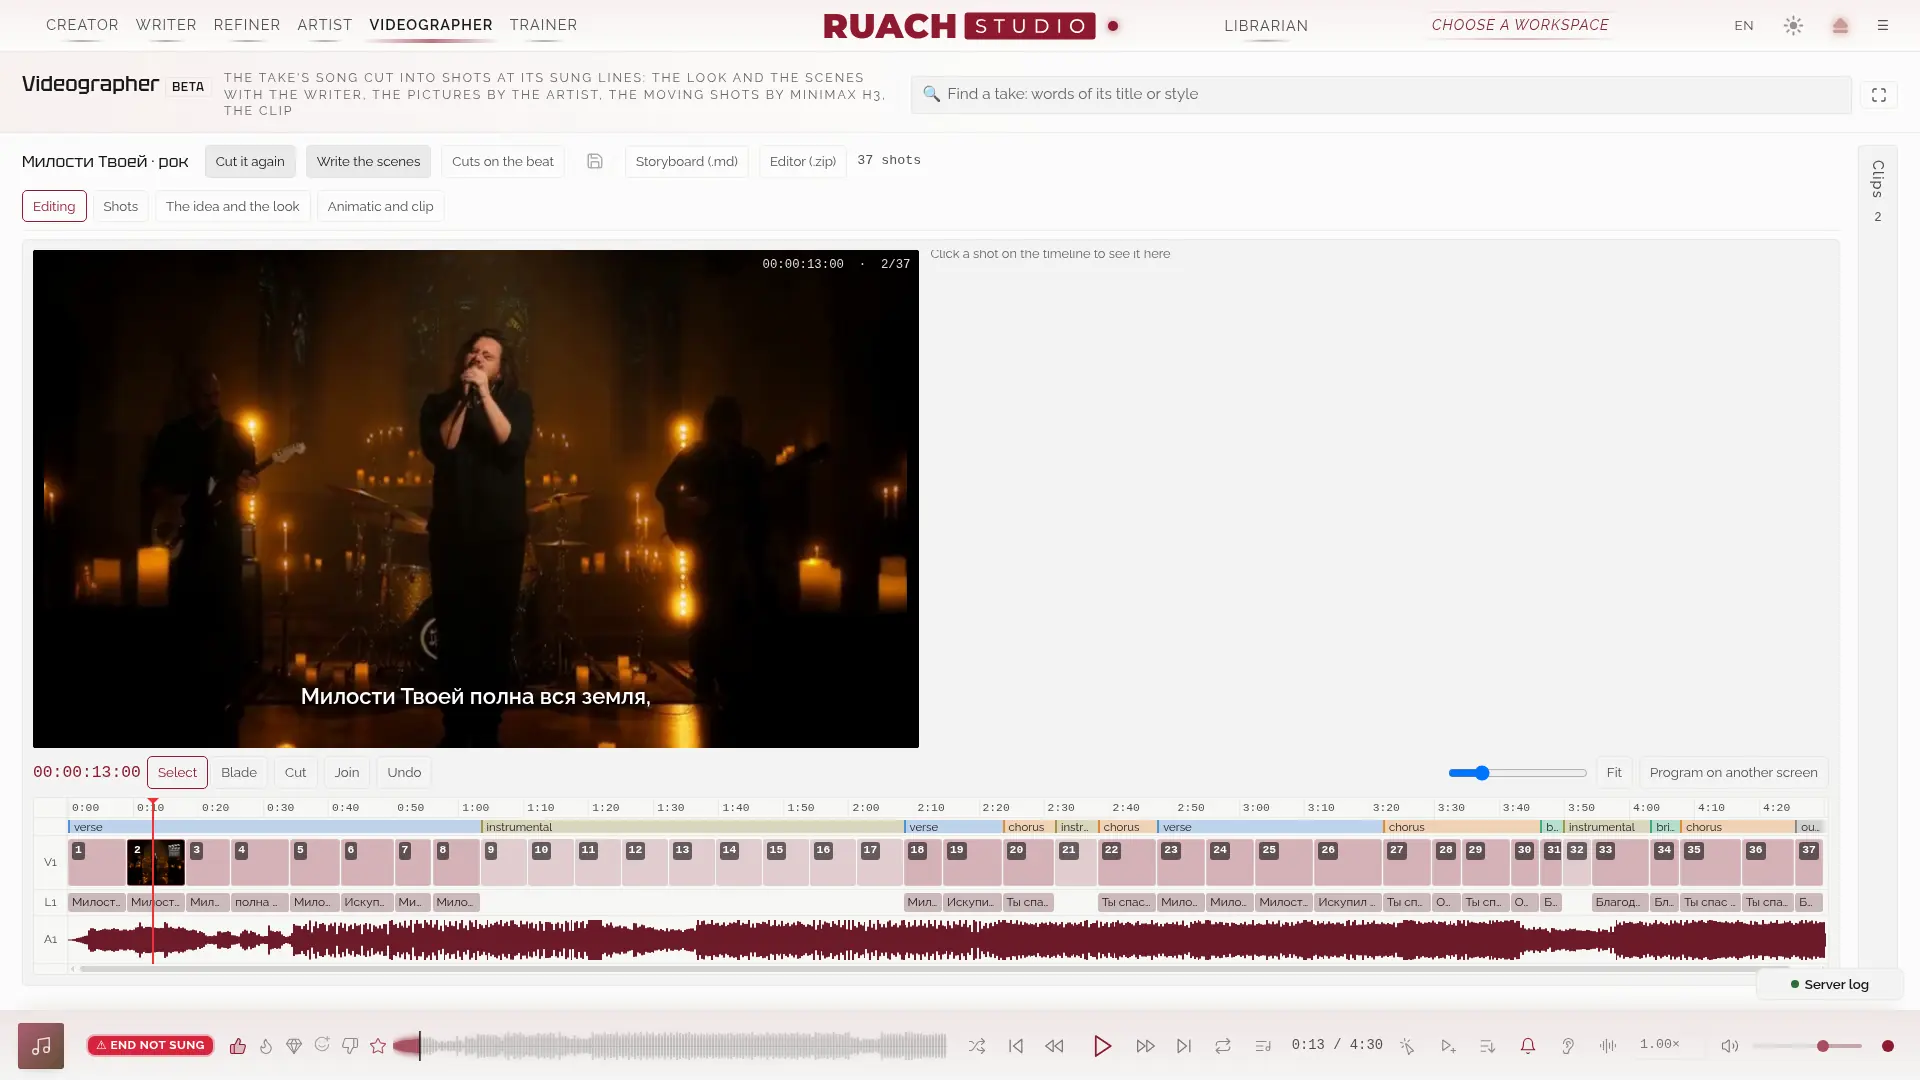
为录音制作音乐视频:按演唱的歌词行把歌曲切成镜头,场景与写作室一起写,关键帧由画师绘制,动态镜头由 MiniMax H3 生成;可剪辑的时间线、风格(3D LUT、颗粒)、动画样片和成片。测试版。
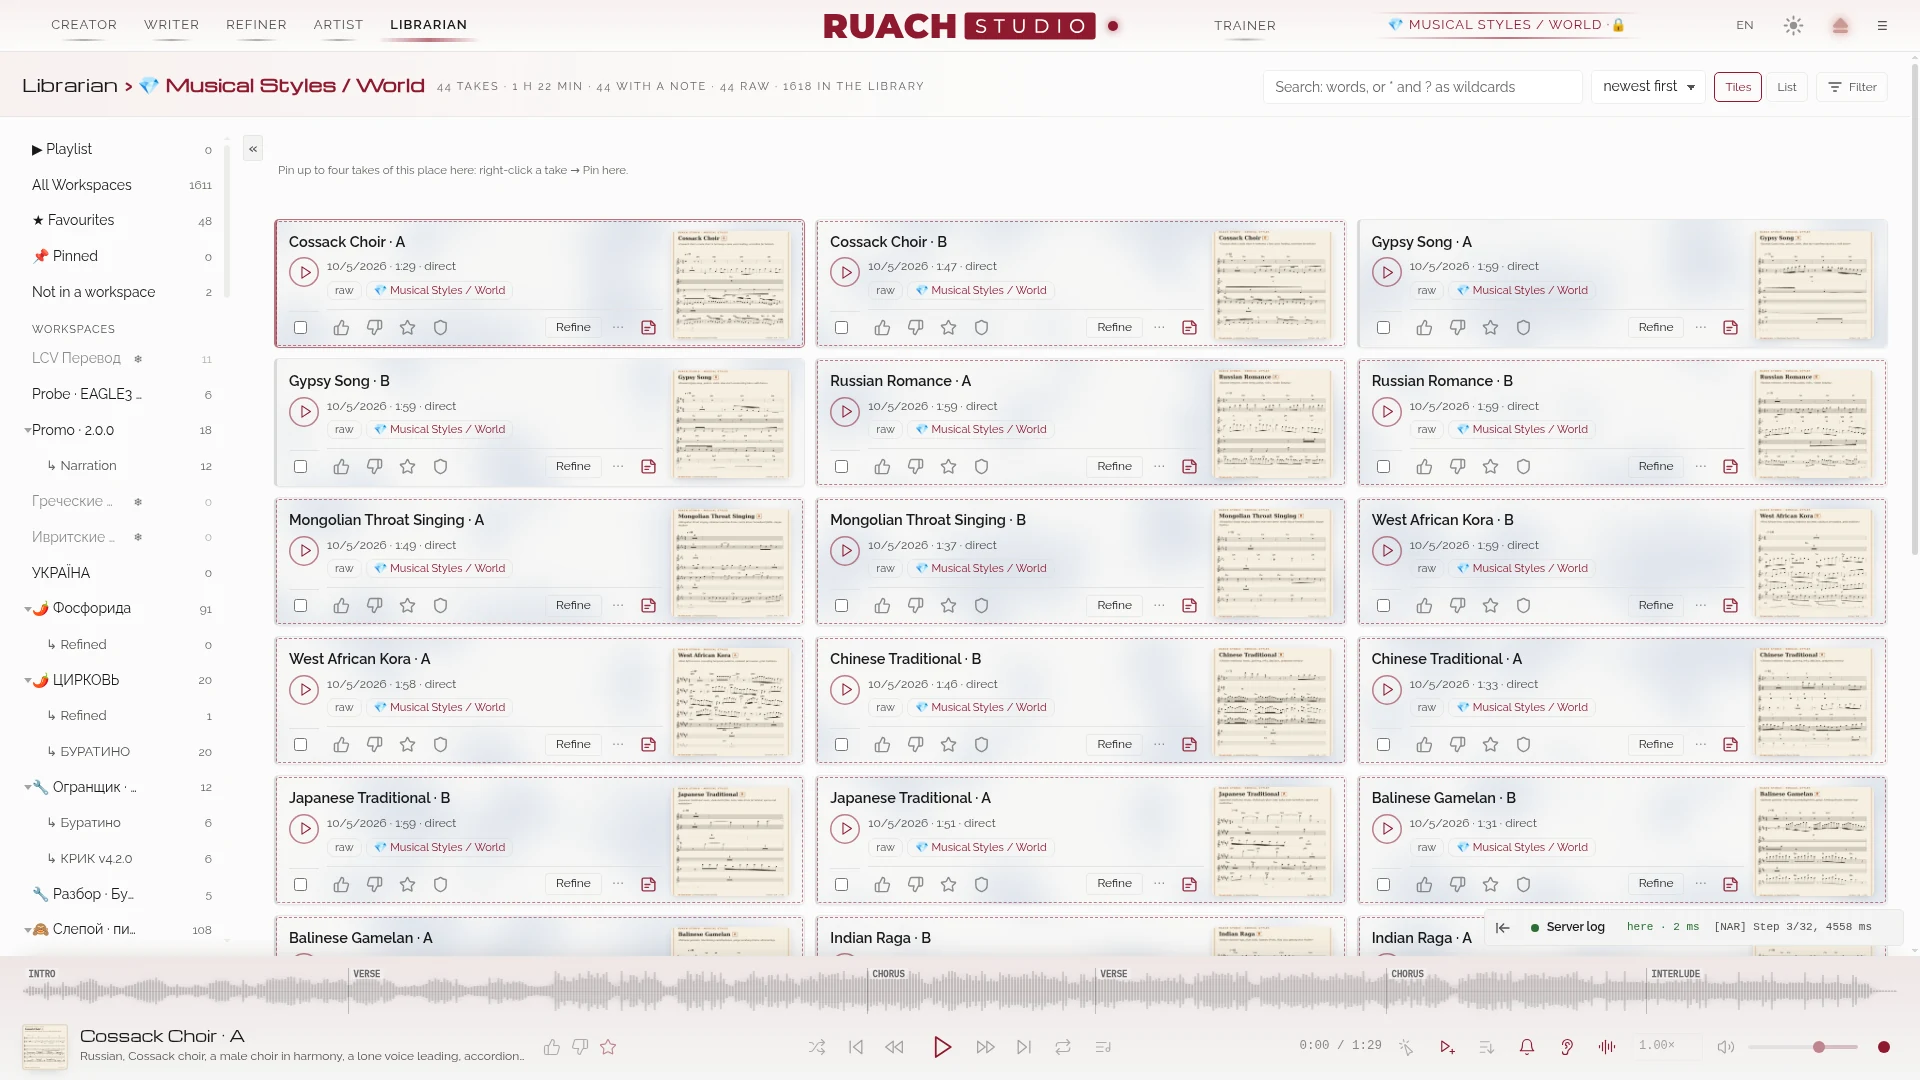
每段录音都在工作区里:可搜索、点赞、备注、锁定、配图、发送到你的 DAW;回收站可以还原。
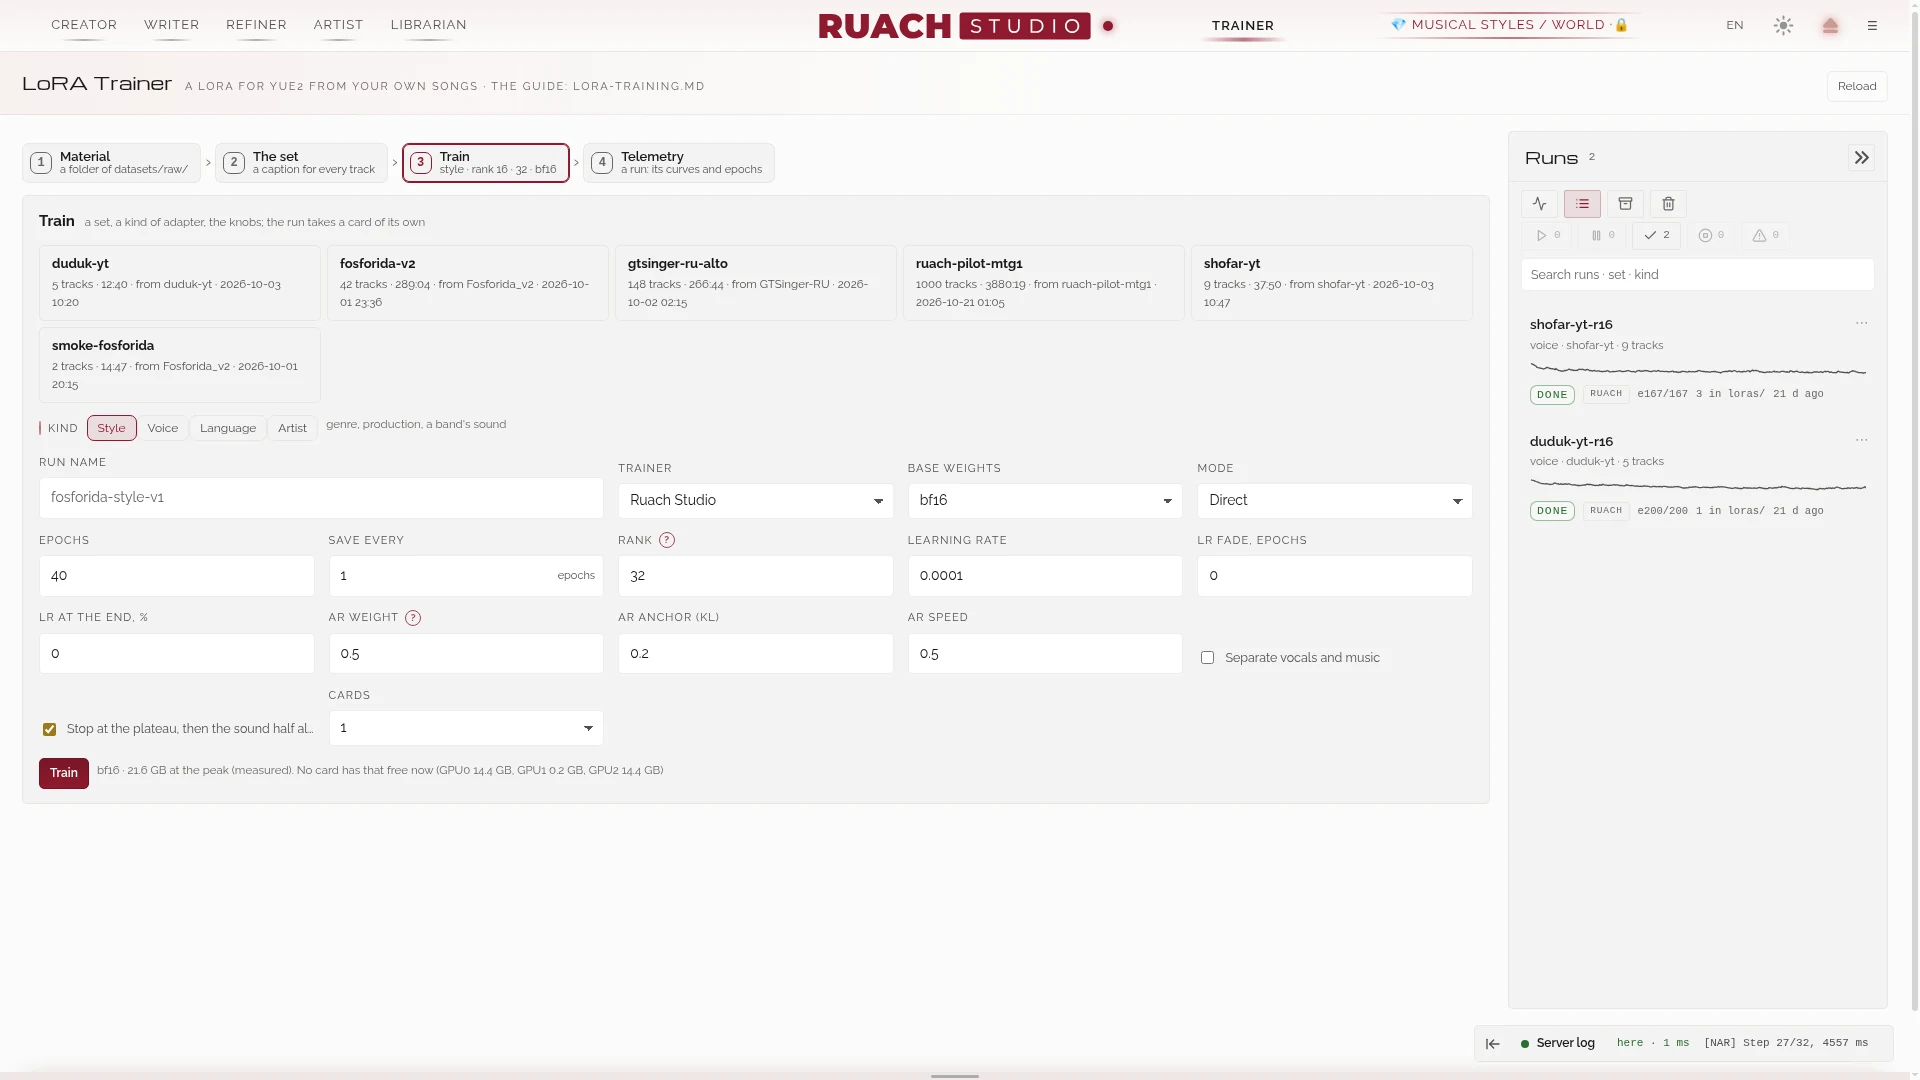
从你自己的歌曲训练适配器:素材集、训练、两部分的曲线讲解、最值得先听的轮次。
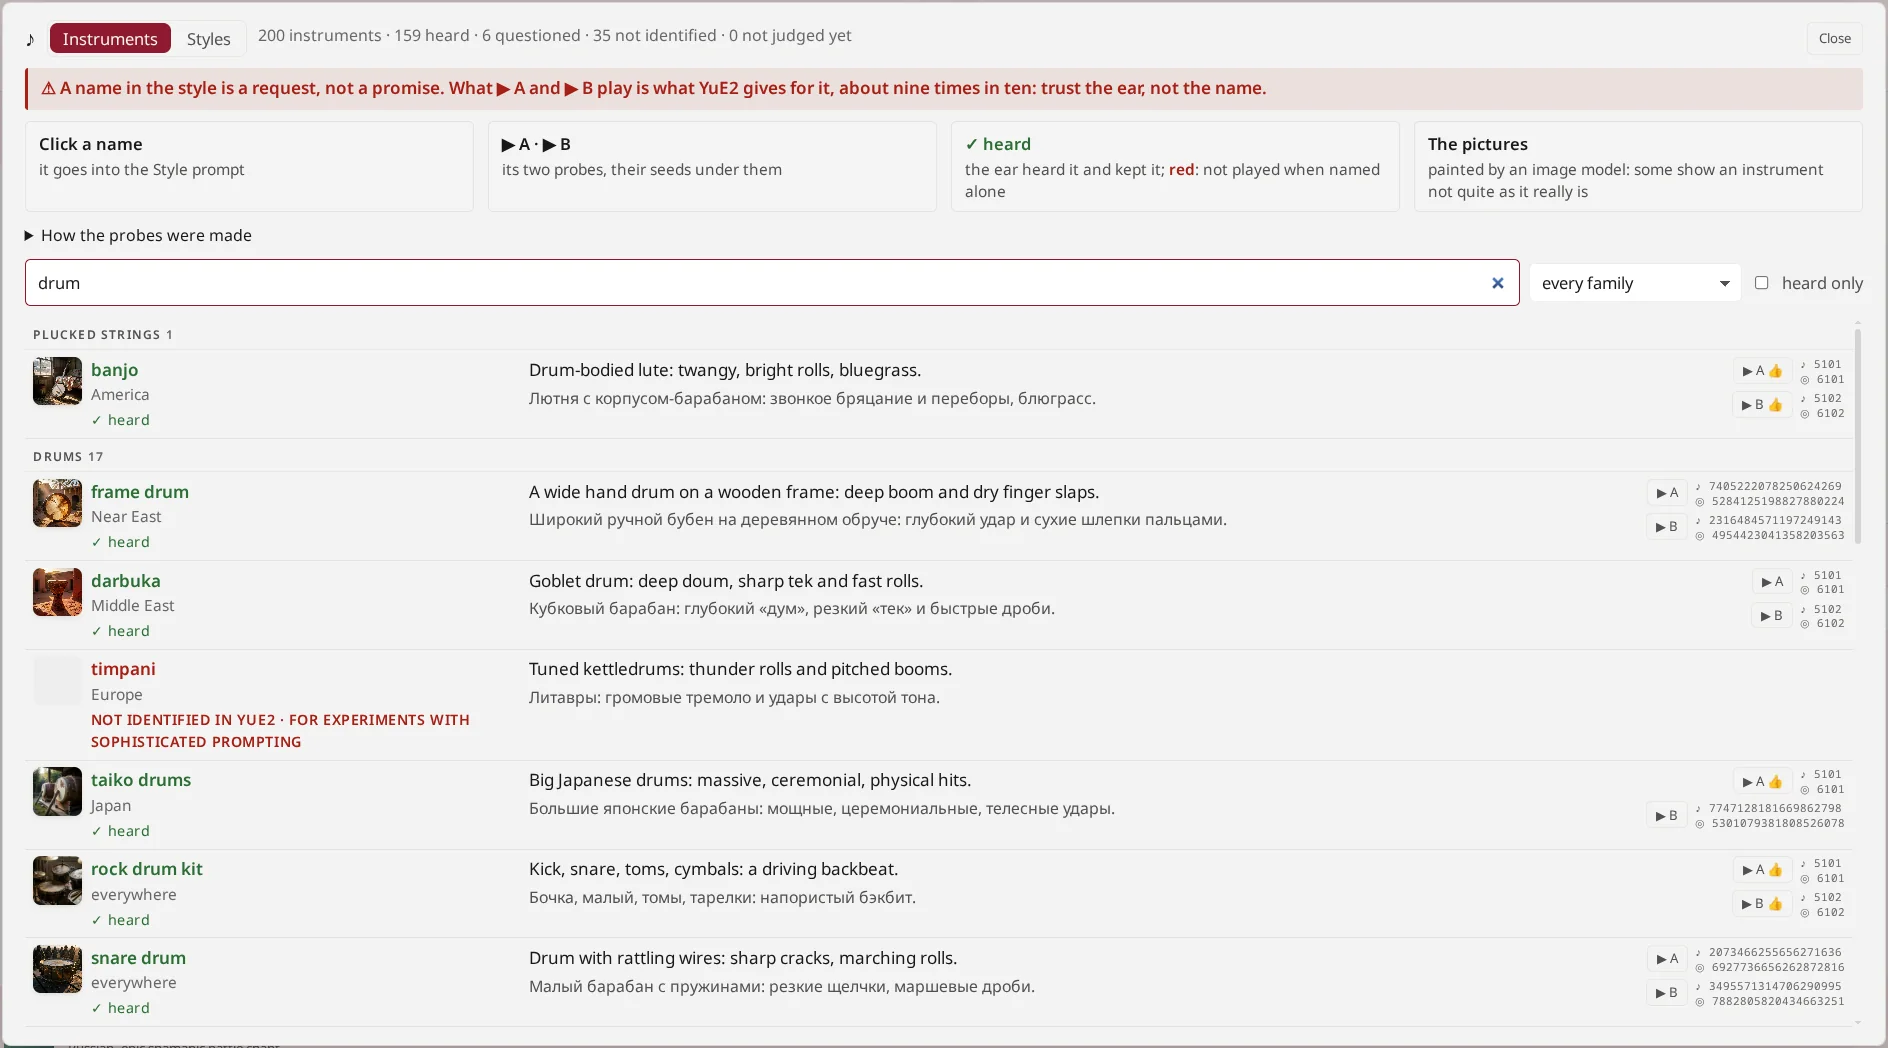
200 件乐器,逐一用耳朵试听并评判:YuE2 真正会弹什么,弹得单薄的是什么,不认识的是什么。
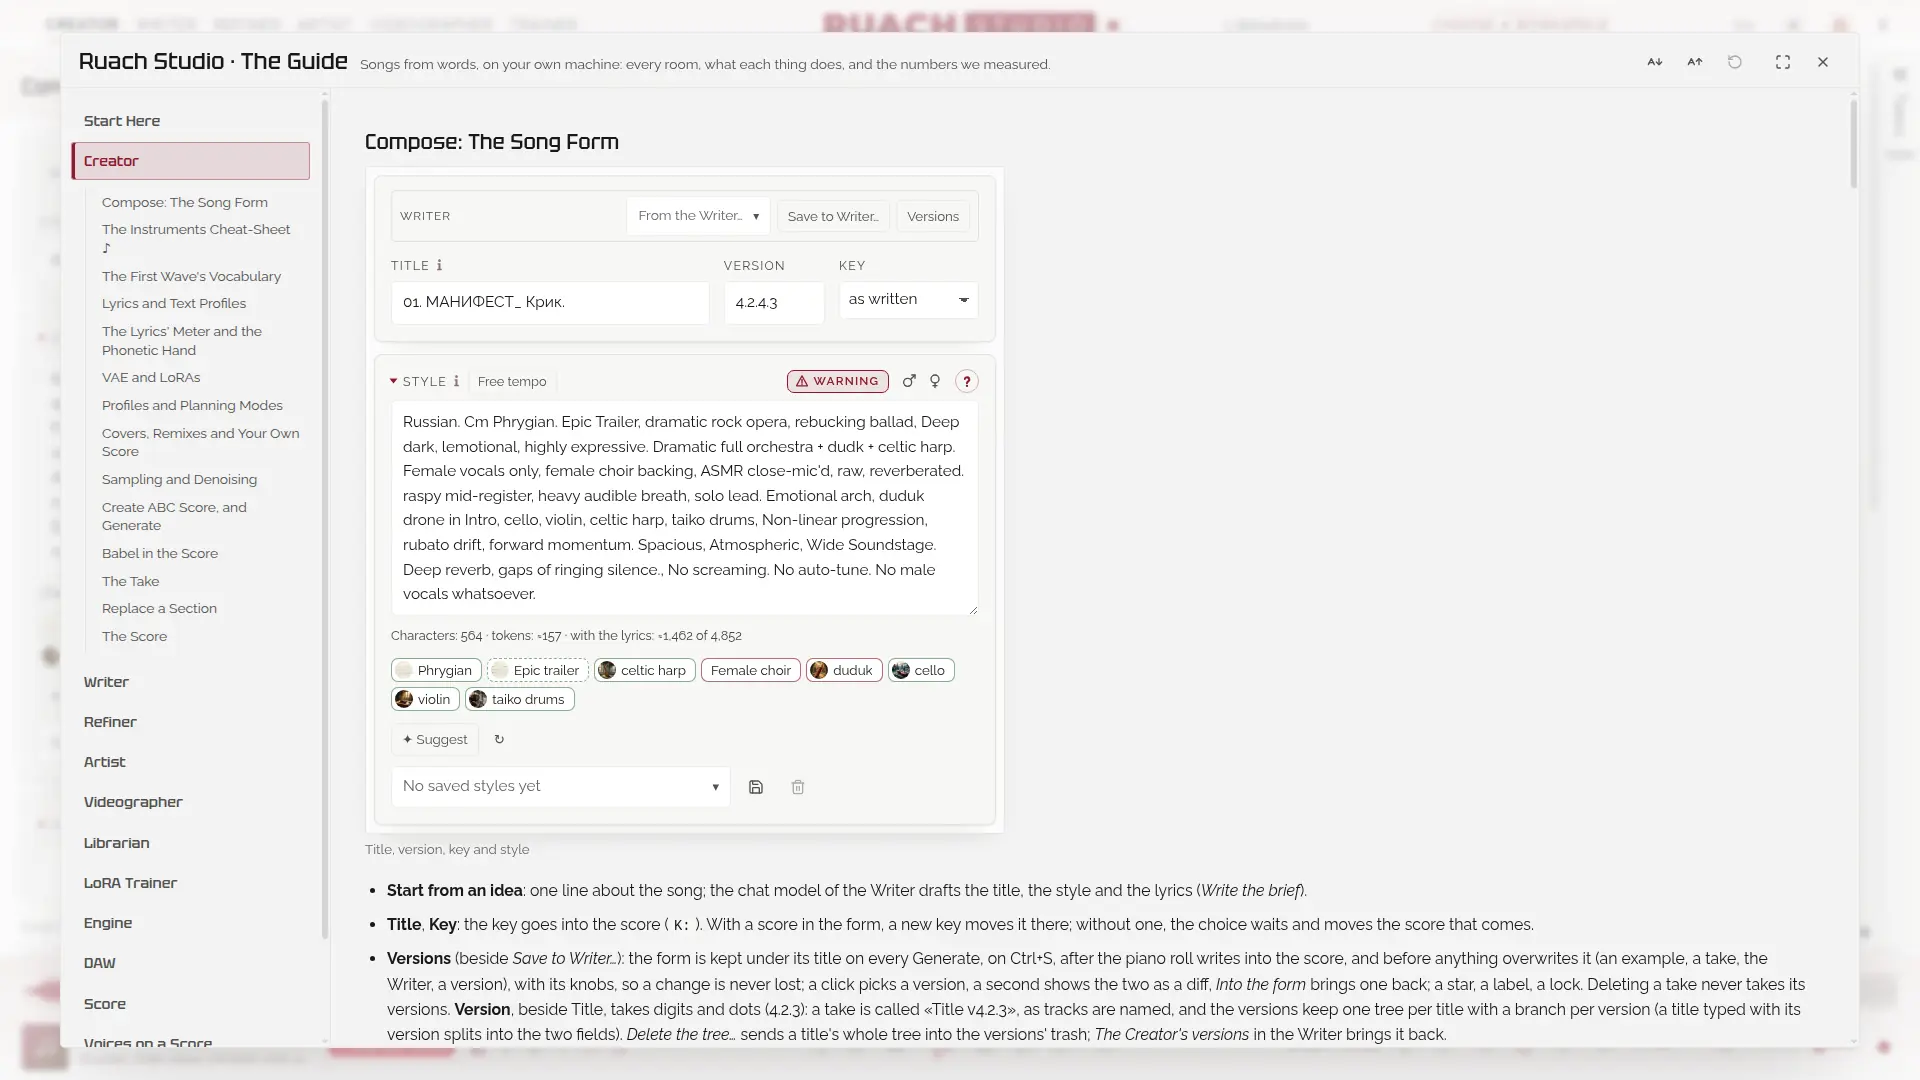
整个 Studio 在 Studio 内部讲清楚,一键即达:每个房间、每个旋钮,它做什么,我们测得的数字,十二种语言。为创作的乐趣而作,而不是为了在网上搜索好几个小时。
不是又一个模型外壳:而是围绕模型的工作站,彻底开放,每一处改动都有编号和记录。
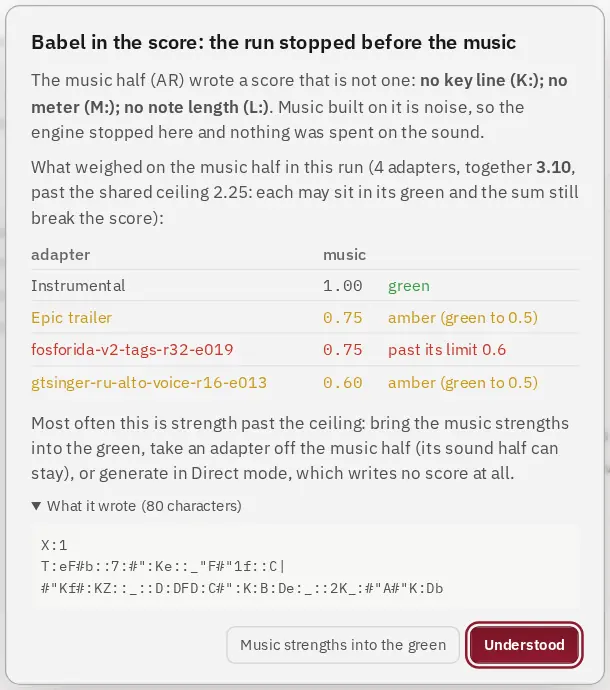
当音乐部分写出损坏的乐谱时(推得太猛的适配器会这样),引擎会在任何音乐建立在它之上之前,几秒内停止运行,并说明原因:哪些适配器、超出极限多少、写出了什么。
强度落在实测的道路上;叠加的适配器共享一个实测的上限。
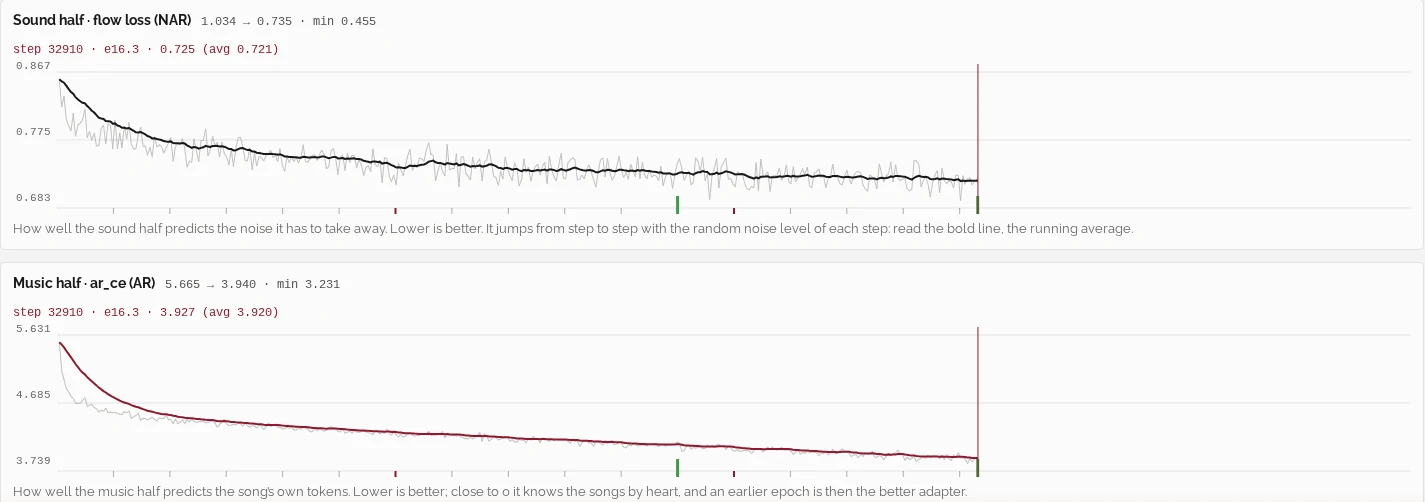
工作室在未量化的 bf16 权重上自己训练适配器。在同一素材集上与 Ostris 的 AI-Toolkit 对比,音乐部分的损失每一轮都在 0.015 以内一致。
148 首歌上的秩 16:每步 2.1 秒,12 GB。42 首完整歌曲上的秩 32:每步 6.7 秒,18 GB。
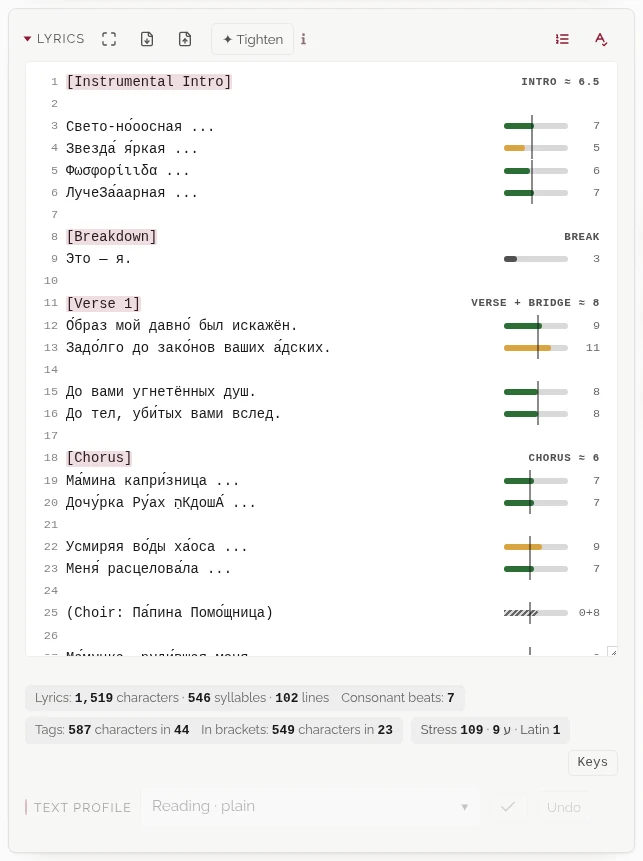
每行旁边是它的拍数,对照其段落的标尺:主歌和桥段为一组,预副歌和副歌各自一组。音节按各语言自己的规则计算,自成一拍的辅音也算;段落中的停顿或间奏不会开启新的一组。
在行首输入 «[»,就会像代码编辑器提示单词一样提示段落标签。放错的重音符号会被找出;Ctrl+F 只在该框内查找。
每周都有视频说某个模型干掉了 SUNO。这不是模型:而是围绕模型的整个 Studio,带有自己的微调。它赢在哪里,SUNO 又仍赢在哪里,直说。
| 鲁阿赫工作室 (YuE2) | SUNO | |
|---|---|---|
| 在哪里运行 | 你自己的 GPU;歌曲、歌词和设置从不离开它,安装后无需联网 | 他们的云 |
| 花费 | 电费而已:没有点数、没有套餐、没有每日上限 | 订阅和积分 |
| 模型 | YuE2 和我们自己的微调 RS-FW,第一个大型开放微调:两半都在 32,633 首曲目、约 1,800 小时上重新训练,告诉它们的每个词都已公开 | 封闭;用什么训练的没有公开 |
| 乐谱 | 先写出、可见、可编辑、归你(ABC、MIDI);整窗钢琴卷帘 | 隐藏 |
| 歌词 | 每行旁边的节拍计:拍数对照其段落的标尺,音节按各语言自己的规则;输入 «[» 时提示段落标签 | 一个文本框;按需为你写歌词 |
| 重复一段录音 | 精确:你保留的两个种子 | 不能 |
| 引导(CFG) | 两个,分开:风格的牵引与歌词的把握,各有自己的 CFG | 一个 Style Influence 旋钮 |
| 替换一个段落 | 在耳朵找到的停顿之间重唱其歌词,作品其余部分精确到采样保持不变:听不出接缝;可一次替换多个段落 | Replace Section:在我们的试用中几乎从不可用,接缝可闻,嗓音改变 |
| 录音的家谱 | 家谱:一段录音来自的每次截取、版本和重新生成,以及由它产生的一切,每个都带波形 | — |
| 曲库 | 带分区的工作区、十六种表情反应、笔记、保护和可以恢复的回收站、支持通配符和“排除”的搜索、用于公正试听的盲听集,每个片段都有传单和护照 | 工作区、点赞和歌单 |
| 比较录音 | 最多十二个版本在同一个播放器里从同一秒开始,具名或盲听,响度一致,按各自的声音对齐 | — |
| 你自己的声音 | 在工作室里用你的歌训练 LoRA | 无训练;Personas 复用一首歌的声音和风格 |
| YuE2 演奏不了的 | 按录音自身乐谱演奏的 MIDI 管弦乐(SFZ 音色组,若你有 Pianoteq 也可)以及铺在歌曲下方的自然声:火、雨、河流、鸟 | — |
| 你自己的乐器 | 音库构建器把一种乐器(杜杜克、羊角号)的录音做成 SFZ 音库:人声、喊叫和其他乐器被听出并去掉,逐键找出音符,校准音高并做成循环;在 DAW 里它在歌曲下方作为铺底、按歌曲调性的持续音或一条 MIDI 旋律来演奏 | — |
| 每个峰值都完整 | 输出端不削波:长长的混响尾音和安静都保持完整;家谱显示旧削波本会咬到的地方 | 交付即已母带处理(在我们的擂台上:−15.5 LUFS、−3.4 dBTP) |
| 渲染之后 | 分轨、去嗡声、重制母带、升频、歌词检查,以及按目标响度出母带(Spotify −14、Apple Music −16、CD −9),全部本地 | 分轨和重制母带,在云端 |
| 调音台 | 精修室里的 DAW:带 EQ、门限、压缩、宽度和发送的轨道,自动化,标记,把一条轨道的声音存为预设 | Suno Studio,在浏览器里,最高档套餐 |
| 看见声音 | 播放器上方显示整段录音的频谱图,与波形同步:段落、明亮度与响度、指针处的频谱和音符 | 波形 |
| 图片和视频 | 画师按你的文字画封面、16:9 和 9:16;影像室规划音乐视频,画出关键帧并赋予它风格(3D LUT、颗粒、暗角) | 一张封面图 |
| 进入 DAW | 含乐谱、段落和歌词的 REAPER 工程(实验性) | 音频分轨 |
| 脚本和智能体 | 一个 API(OpenAPI 3.1)和一个 MCP 服务器,在你的机器和网络上 | 没有公开 API |
| 来源证明 | 每次下载都签入 Content Credentials(C2PA),如你愿意,以你的名义 | — |
| 代码 | 开放(AGPL),每次更改都有编号和记录 | 封闭 |
| 界面 | 一页七个房间,十二种语言;每个控件都有提示,每个房间都有指南;每个房间都有播放器和片段;常用操作有快捷键;可以作为应用安装 | 网页应用和手机应用 |
| 开箱即用的精致度 | 较少:混音可能有嗡声(去嗡声有帮助),歌词可能偏离(歌词检查会找到位置),有些乐器 YuE2 弹得单薄或根本不会(LoRA 能教会它) | 较多 |
| 你需要 | NVIDIA 显卡(全精度运行全部需 24 GB;12–16 GB 和 8 GB 用较小副本),Linux,34–41 GB 磁盘 | 一个浏览器 |
「—」:在 SUNO 付费套餐上用了半年多也没找到。SUNO 变化很快;本表截至 2026 年 11 月。
二十张卡片,每张有一行风格描述和一段歌词,原封不动地发给每一方。SUNO v6 和 Musicful V3 按其服务交付的原样;我们的则直接取自引擎、未经处理,于十一月重新演唱,每个峰值都完整保留:原版 YuE2-3B、我们自己的微调 RS-FW 的三个存档点,以及 RS-TW 2.0。这里每个文件都以相同响度播放,谁也不会因为更响而胜出。点一个名字即可收听;同一张卡片上的另一个名字会从同一秒接着播放。
RS-TW 2.0 是我们的第二个微调:它训练到 2.0 个轮次,以两种强度合并在 RS-FW 2.4 之上:×0.75 是稳妥的平衡,×0.9 更具地壳运动般的起伏,不保证稳定。我们的每张卡片有两个种子,都在这里,没有挑出其中一个:播放器里的切换按钮给出种子 1 或种子 2,并在卡片之间保持不变;表中的平均值把两者都算在内。
| 按原样测量,平均值 | SUNO v6 | Musicful V3 | YuE2‑3B | Ruach Studio (RS-…):YuE2 3B 的微调 | ||||
|---|---|---|---|---|---|---|---|---|
| FW 0.7 | FW 1.5 | FW 2.4 | TW 2.0 ×0.75 | TW 2.0 ×0.9 | ||||
| Whisper 歌词错误率,在混音上,% ↧ | 23.1 | 19.5 | 20.0 | 19.9 | 24.8 | 21.8 | 23.0 | 26.1 |
| Whisper 歌词错误率,在分离出的人声上,% ↧ | 27.4 | 18.9 | 21.6 | 24.8 | 31.1 | 28.8 | 29.5 | 33.7 |
| 安静处的沙声,6–16 kHz,dB ↧ | -15.7 | -14.8 | -17.6 | -18.1 | -17.3 | -17.3 | -17.9 | -17.5 |
| 杂散的持续音 ↧ | 2.2 | 1.9 | 4.33 | 2.0 | 2.27 | 2.23 | 2.15 | 1.6 |
| 解码器在高频的 25 Hz 嗡声,dB ↧ | 8.3 | 8.0 | 11.4 | 11.6 | 11.6 | 11.5 | 11.6 | 11.1 |
| 咔嗒声 ↧ | 33.4 | 33.8 | 27.7 | 31.9 | 35.3 | 34.7 | 34.5 | 32.8 |
| 削波段 ↧ | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| 本底噪声,最安静的十分之一,dBFS ↧ | -26.6 | -25.2 | -27.7 | -27.6 | -27.0 | -26.6 | -27.1 | -28.2 |
| 频谱上限,kHz ↥ | 17.9 | 15.3 | 15.8 | 14.8 | 14.9 | 15.1 | 15.2 | 14.7 |
| 95% 滚降频率,kHz ↥ | 2.5 | 2.6 | 2.2 | 2.1 | 2.2 | 2.0 | 1.7 | 1.7 |
| 20–60 Hz 超低频占比,dB ↥ | -8.6 | -10.2 | -10.0 | -9.6 | -9.9 | -10.4 | -10.0 | -9.8 |
| 交付时的响度,LUFS → −14 | -15.5 | -14.3 | -14.5 | -14.7 | -14.7 | -14.4 | -14.6 | -14.8 |
| 交付时的真峰值,dBTP → −1.0 | -3.4 | -0.5 | -0.2 | -0.2 | -0.1 | -0.2 | -0.3 | -0.1 |
| 60–150 Hz 低音占比,dB ↥ | -6.0 | -5.6 | -4.3 | -4.8 | -4.5 | -4.5 | -4.4 | -4.8 |
| 2–5 kHz 临场感频段占比,dB ↥ | -17.1 | -16.6 | -16.0 | -16.3 | -16.2 | -16.2 | -17.3 | -16.9 |
| 峰值因数,dB ↥ | 14.4 | 15.7 | 16.5 | 16.5 | 16.6 | 16.3 | 16.2 | 16.6 |
| 响度范围,LU ↥ | 5.9 | 6.2 | 7.1 | 6.6 | 6.5 | 6.4 | 6.6 | 7.1 |
| 响度离散度 p95−p10,dB ↥ | 9.4 | 9.0 | 11.5 | 10.8 | 10.4 | 10.3 | 10.8 | 11.7 |
| 低频段离散度 p95−p10,dB ↥ | 23.3 | 20.0 | 21.9 | 21.1 | 20.6 | 19.7 | 22.0 | 22.6 |
| 中频立体声相关 ↥ | 0.67 | 0.69 | 0.75 | 0.77 | 0.73 | 0.74 | 0.77 | 0.76 |
| 时长,秒 ↥ | 156.8 | 154.5 | 148.6 | 148.1 | 154.8 | 151.9 | 152.8 | 149.7 |
第一 · 第二 · 第三:每行八项中的前三名,第一名另加粗体;↥ 越高越好,↧ 越低越好,→ 越接近所示数值越好(真峰值从下方)。数字相同的格子颜色相同。
八方都在 RTX 3090 上由 Whisper large-v3 聆听,混音和人声一视同仁:Whisper 的第一行听混音,第二行听分离出的人声,即 BS-Roformer 把每条音轨的所有人声从音乐中分离出来(主唱、和声与合唱一起,从不只取主唱)。没有音乐时,Whisper 有时会漏掉整句歌词,并在停顿处写出没人唱过的字,每一方都会发生,所以两行最好对照着读。
FW 和 TW 是我们对 YuE2 3B 的两个微调的代号:First Wave 和 Tsunami Wave。Tsunami Wave 在 109,250 首曲目、约 6,650 小时上训练:66.7% 的时长是器乐,31.6% 是演唱,1.8% 是说话。人声的语言有英语(时长的 7.0%)、俄语(5.8%)、希伯来语(1.7%)、希腊语和乌克兰语(各 0.6%)、法语和西班牙语(各 0.5%)、葡萄牙语(0.3%)、意大利语(0.2%),以及另外 14 种各占不到 0.1% 的语言;15.9% 的时长里能听到人声,但其语言未能识别。
他们的作品是母带处理过的,我们的是原样,保持解码器自身的电平,每个峰值都完整保留:响度留给母带处理,那是工作室精修室的事。换了种子和提示词,每一方听起来都会不同;擂台展示的是质量和差异范围,而不是最终排名。完整表格及其测量方法:模型卡。
我们两个微调收到的每个词,都已统计并可搜索:Tsunami Wave 的 109,250 首训练曲目,以及在它之前第一波的 32,633 首。流派、乐器、人声、由音频本身得出的情感词、调与 BPM,以及乐谱的字段。很少有微调会公开它的模型被告知了什么。
不是听,而是测量的擂台:280 个作品,我们六方各 40 个,SUNO v6 20 个,Musicful V3 20 个。每个作品先统一到 −14 LUFS,让响度赢不到任何东西;每条曲线都是该作品各频段相对其总功率的电平,所以比较的只是形状。我们的是引擎的原始输出,他们的经过母带处理,因此下面的一部分差距来自母带。
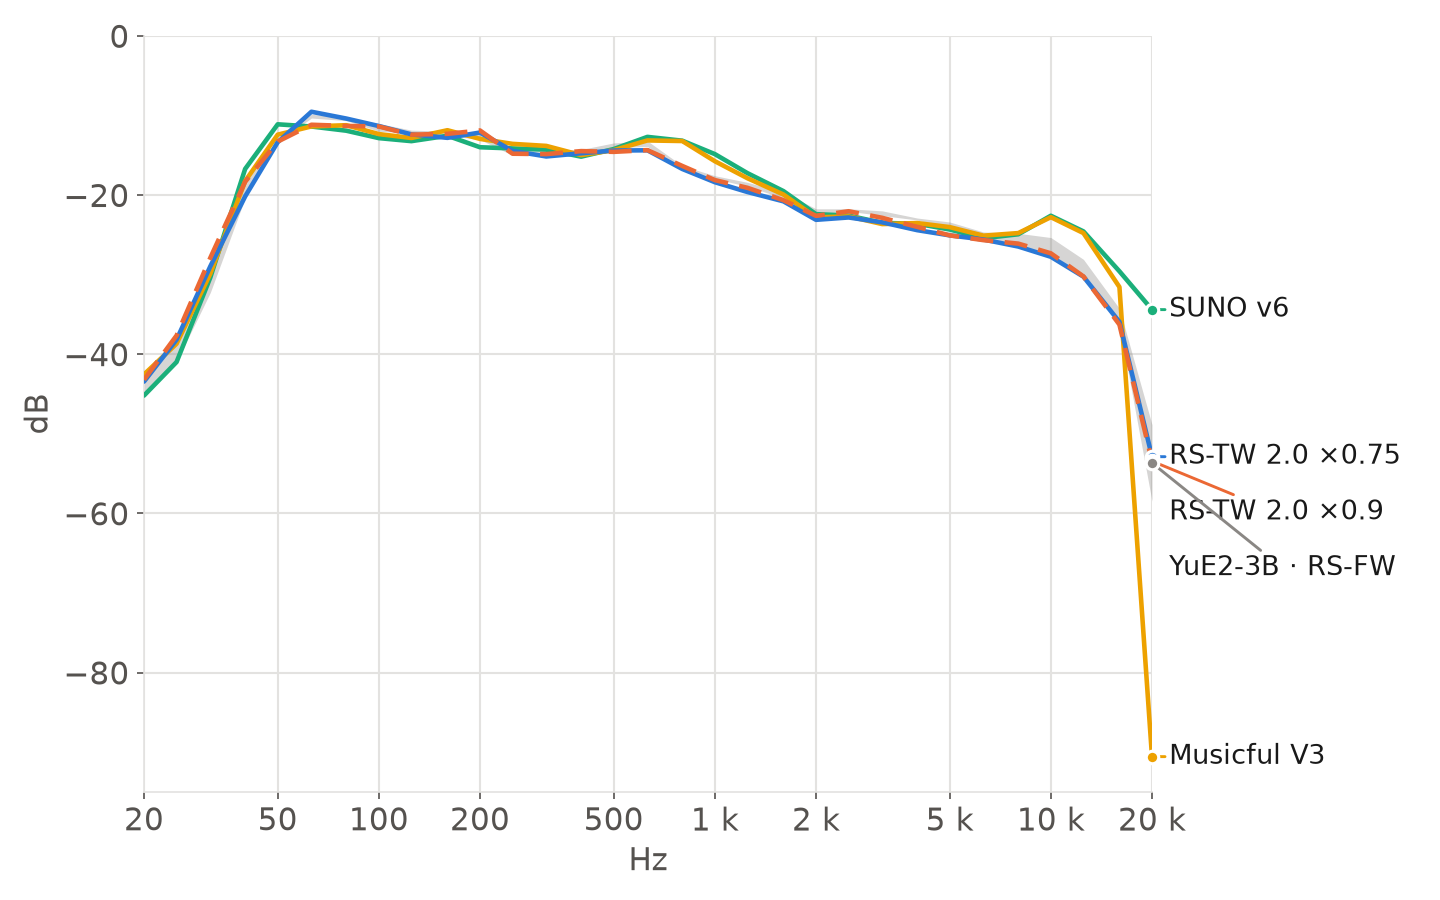
从 100 Hz 到 10 kHz,八方的平均曲线彼此相差不超过 5.2 dB。高于 16 kHz,它们分开了。Musicful V3 在 40 个作品中有 38 个在 16 kHz 以上什么也没有保留:在 20 kHz,它的平均值位于 −90.6 dB,别人是斜坡的地方,它是一堵墙。SUNO v6 在那里保留得最多,16–20 kHz 为 −31.0 dB;我们的在 −39.3 到 −42.3 dB 之间,偶尔也会止于 16 kHz,40 个中有 1 到 6 个,最多的是 RS-TW 2.0 ×0.9。
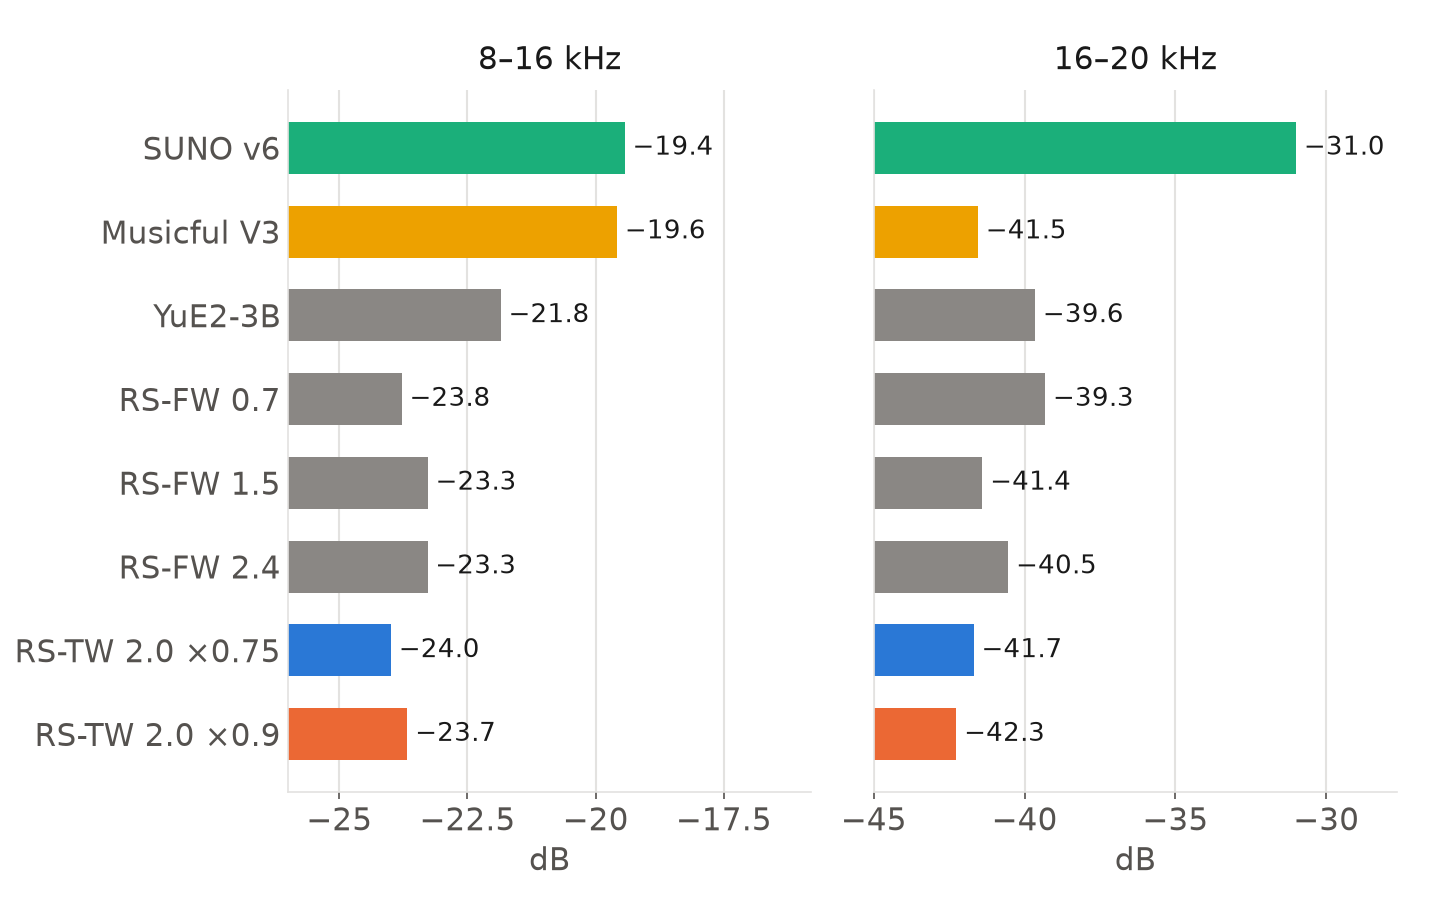
在空气感频段 8–16 kHz,SUNO v6 和 Musicful V3 分别位于其作品功率的 −19.4 和 −19.6 dB,我们的六方在 −21.8 到 −24.0 dB 之间。母带处理通常会提升空气感,而我们的还没有经过任何母带:在工作室里,那是歌唱完之后精修室的事。
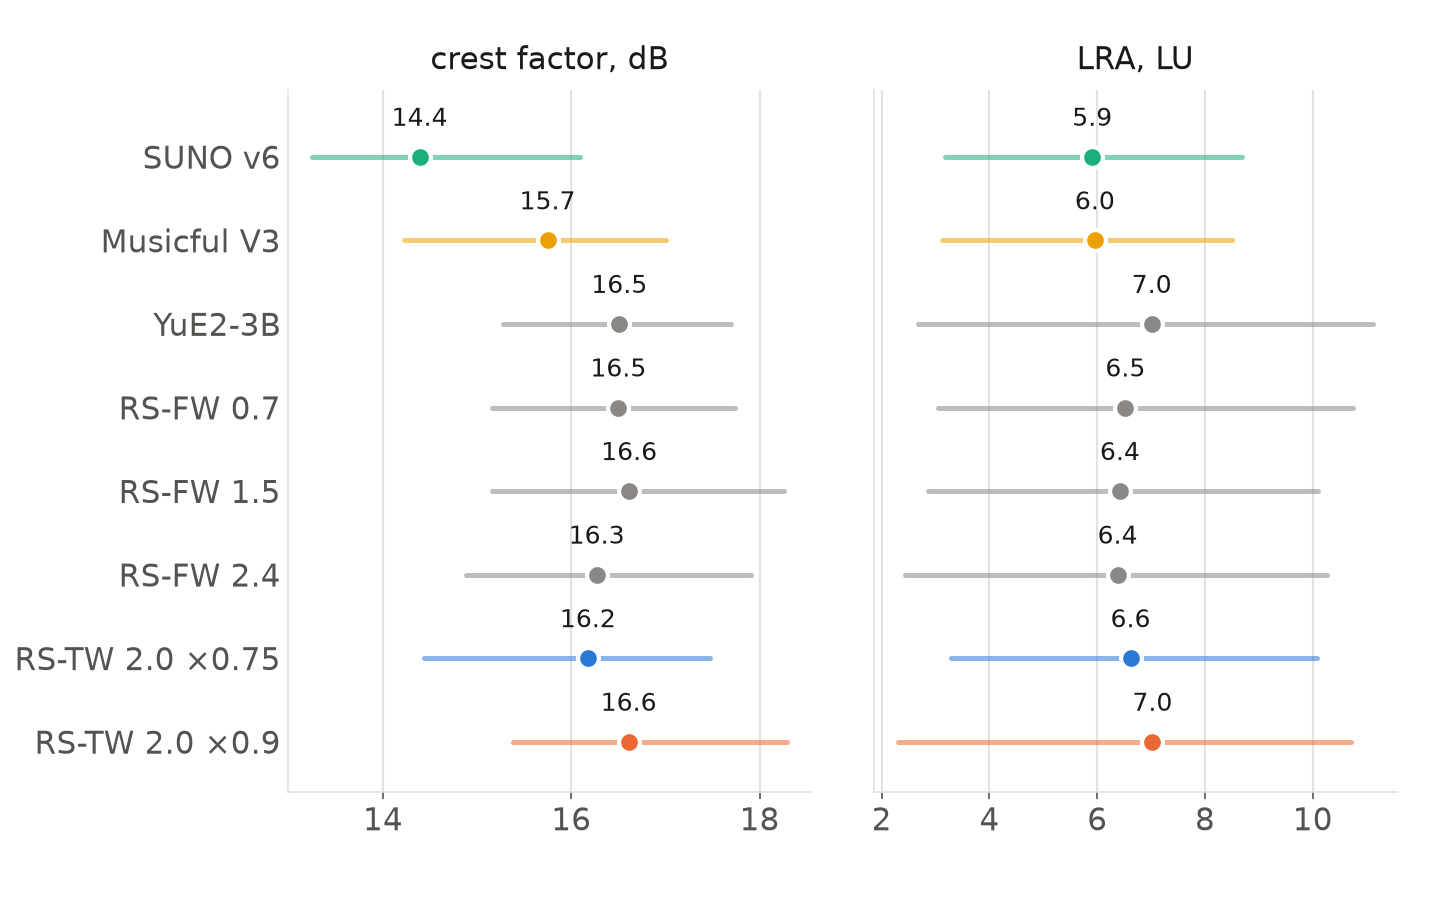
峰值因数,即峰值高出平均值的部分:SUNO v6 为 14.4 dB,Musicful V3 为 15.7 dB,我们的为 16.2 到 16.6 dB。响度范围:他们为 5.9 和 6.0 LU,我们为 6.4 到 7.0 LU。RS-TW 2.0 ×0.9 是我们的微调中最宽的,16.6 dB 和 7.0 LU,与原版 YuE2-3B(16.5 dB、7.0 LU)一样宽:这就是用数字表示的它的地壳运动。×0.75 更收敛,16.2 dB 和 6.6 LU。
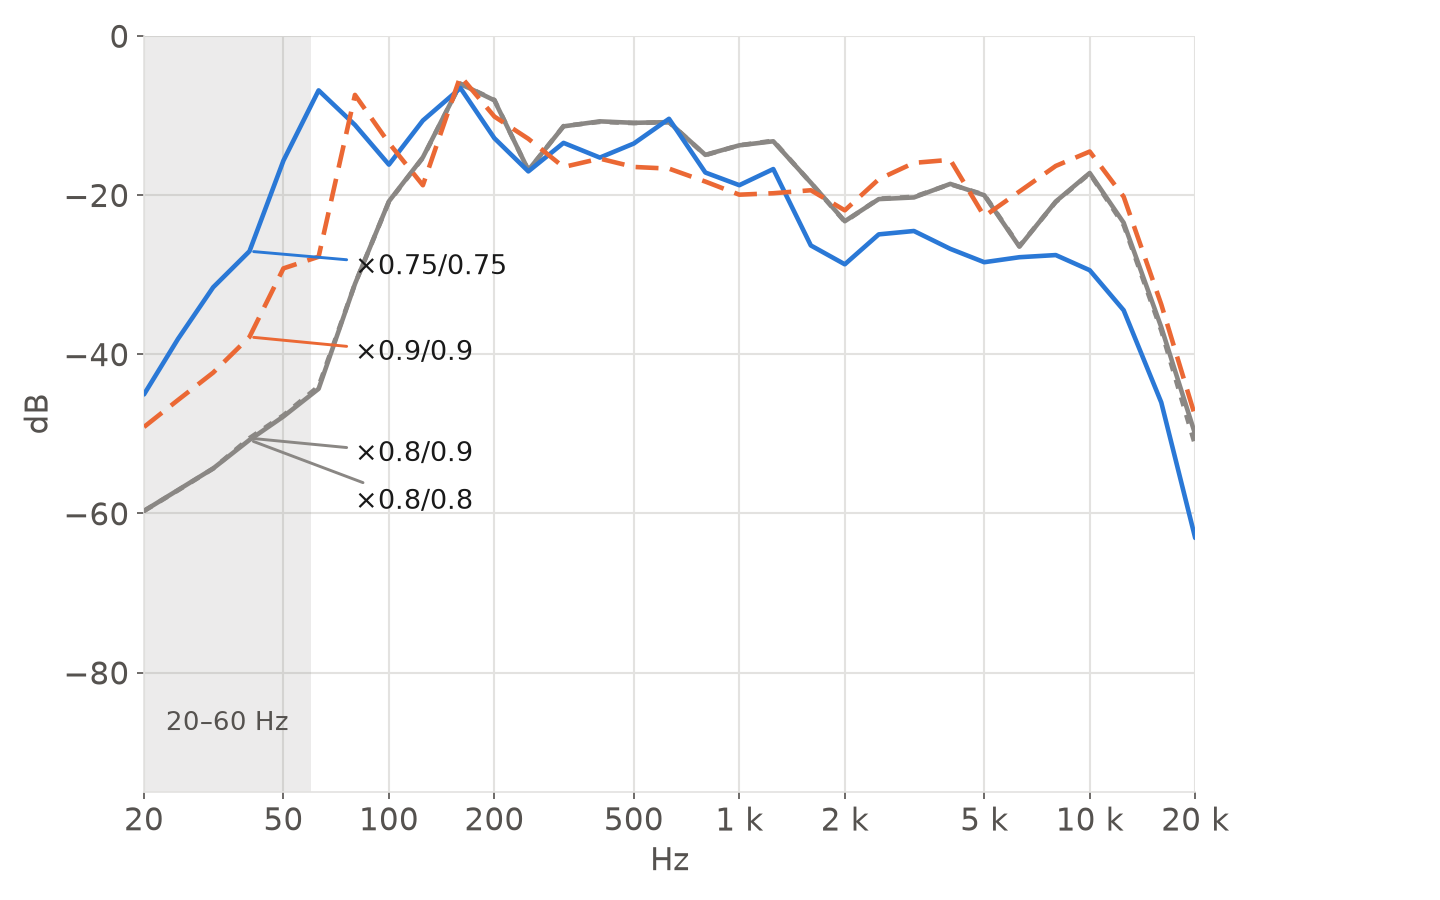
盲测集:十二张卡片,在 RS-FW 2.4 之上以 Tsunami Wave 的四种强度演唱,每种强度用同一个种子。在希腊语的诗篇 22 上,从 ×0.75/0.75 到 ×0.8/0.8 的一步,让 20–60 Hz 的超低音少了 36 dB,从 −7.9 降到 −44.3 dB:歌曲脚下的地板消失了。在全部十二张卡片上,摆动要温和得多,超低音在 ×0.75/0.75 下为 −8.5 dB,其他三种为 −10.4 到 −11.0 dB;而且 ×0.75/0.75 在 12 张卡片中有 6 张最接近擂台自身的中位曲线,平均距离 4.1 dB,其他为 4.8 到 5.2 dB。因此在 2.0.6 中,×0.75 成为工作室的默认模型,而 ×0.9 是不承诺稳定性的那一个。
用我们自己的代码在 CPU 上测量:1/3 倍频程频段取自 Welch 频谱,响度及其范围依据 ITU-R BS.1770-4 和 EBU Tech 3342。每张图点击即可放大。
擂台上的 280 个作品,按宽度来测量。在四个频段中的每一个里,把侧信号(两个声道之差的一半)与中信号(两者之和的一半)相比:侧信号高出中信号的 dB 越多,这个频段听起来就越宽;单声道的作品根本没有侧信号。声像是一个作品里左右声道的电平差摆动得有多远,从第 5 到第 95 百分位,单位 dB。每个数字都是一方作品的中位数:SUNO v6 和 Musicful V3 各 20 个,我们的每一方各 40 个。这里更宽并不更好,只是更宽:这张表不排名次。
四个频段中侧信号相对中信号的高度(dB,各方作品的中位数):越高越宽。
| 按原样测量,中位数 | 侧信号相对中信号,dB | 声像,dB | |||
|---|---|---|---|---|---|
| 低频 20–200 Hz | 中频 0.2–2 kHz | 高频 2–8 kHz | 空气感 8–20 kHz | ||
| SUNO v6 | −12.5 | −7.0 | −6.8 | −9.6 | 6.4 |
| Musicful V3 | −13.0 | −7.2 | −5.9 | −7.9 | 6.6 |
| YuE2-3B | −17.4 | −8.2 | −7.9 | −10.6 | 6.4 |
| RS-FW 0.7 | −17.2 | −8.5 | −7.3 | −10.9 | 5.9 |
| RS-FW 1.5 | −17.4 | −7.5 | −6.6 | −10.2 | 6.3 |
| RS-FW 2.4 | −16.5 | −8.0 | −7.9 | −11.2 | 6.4 |
| RS-TW 2.0 ×0.75 | −19.0 | −8.1 | −7.9 | −11.6 | 6.0 |
| RS-TW 2.0 ×0.9 | −20.1 | −8.9 | −8.2 | −12.0 | 5.9 |
我们的合并把中频和高频保持在原版 YuE2-3B 所在的位置,相差都不超过 1.3 dB。RS-TW 2.0 在两端略窄:×0.75 在低频窄 1.6 dB、空气感窄 1.0 dB、声像窄 0.4 dB,×0.9 分别窄 2.7、1.4 和 0.5 dB。SUNO v6 和 Musicful V3 的低频比原版 YuE2-3B 宽 4.9 和 4.4 dB。
在 Viktor 听来,RS-TW 2.0 收窄的两端更稳,而不是丢了立体声:原版 YuE2-3B 常把一把吉他停在一个声道里 15 到 20 秒。
用我们自己的代码在 CPU 上测得:对每个作品的前 240 秒,每 50 ms 取一次 4096 点的短时频谱;中信号和侧信号为 (L+R)/2 和 (L−R)/2;声像取自 200 Hz – 8 kHz 内两声道的电平差,只看与作品最响处相差 40 dB 以内的时刻。
fetch-models.sh 下载、固定版本并校验);画室的模型另需 39–43 GB,💎 素材集 5.6 GB,都只在你要求时才下载不能用免费的云端 GPU。Ruach Studio 无法在 Google Colab、Kaggle 或任何免费的笔记本 GPU 上运行,所以别在那儿浪费一个晚上:它是一整个工作室,不是一个笔记本。它在所在的机器上编译自己的 C++/CUDA 引擎,旁边一直运行着一个服务器和一组 Python 服务,并占用约 34–41 GB 磁盘(加上画室约 74–84 GB)。免费会话的显卡、内存、会被清空的磁盘和几小时的时限都撑不住。它需要你自己的 Linux 电脑,或你租下并长期保留的服务器,配一块 NVIDIA 显卡:全部功能 24 GB,用较小的模型副本 16 GB。
按工作室各仓库的固定清单和全新安装的磁盘逐文件测量(1 GB = 10⁹ 字节)。安装带来创作室、资料馆和精修室的处理链;其他房间只在你要求时才下载,经由 引擎 → 模型与 LoRA → 按房间,它先测量可用空间,放不下的不下载。
| 24 GB 显卡 | 12–16 GB 显卡 | 8 GB 显卡 | |
|---|---|---|---|
| 程序及在本机构建的引擎(下载 0.2 GB) | 0.9 GB | 0.9 GB | 0.9 GB |
| 两套 Python 环境,各含适配 CUDA 12.8 的 PyTorch(下载 8.7 GB) | 16.5 GB | 16.5 GB | 16.5 GB |
| YuE2 与 Ruach Studio 自有的微调模型,采用适合显卡的量化 | 14.9 GB | 8.2 GB | 8.2 GB |
| 其余:另外两个解码器、转录器、Whisper、分轨模型、UniverSR 与 Apollo-vocal、LoRA | 8.8 GB | 8.8 GB | 8.8 GB |
| 安装 | 41.1 GB | 34.4 GB | 34.4 GB |
| + 写作室:经 llama.cpp 运行的语言模型 | 7.4 GB | 7.4 GB | 6.2 GB |
| + 精修室:MuScriptor 与 FlashSR | 6.1 GB | 6.1 GB | 6.1 GB |
| + 画室:其助手与 Qwen-Image 2512(24 GB 用 Q6,以下用 Q4) | 42.9 GB | 39.3 GB | 39.3 GB |
| + 影像室:MiniMax H3 与 SeedVR2 | 86.3 GB | 需要 24 GB | 需要 24 GB |
| + LoRA 训练室:其基座与风格聆听者 | 20.2 GB | 16.3 GB | 12.9 GB |
| 全部房间 | 204.0 GB | 103.5 GB | 98.9 GB |
仅在点名要求时下载:其余声音引擎(IRA、IRAE 与 RS-FW 合并模型,按量化 35 至 86 GB)、画室的适配器(7.5 GB)与微调模型(各 20.4 GB)、MiniMax H3 的全部层级(201 GB)或 BF16(478 GB)、💎 工作区(5.6 GB)。不计入:NVIDIA 驱动与 CUDA toolkit、Pianoteq(需自行购买)、你的作品。
2.0.5 是我们每天创作自己歌曲所用的 Studio。以下是正在路上的较大部分,面向 2.1.0 及以后。
Viktor Zhuromskyy, the author of Ruach Studio, does not publish it for the hype. He made it for himself. After more than half a year of struggling with Suno on paid plans, and of searching for a model worth working with (ACE-Step, MiniMax and others), he set out to build an audio studio of his own, on his own machine. He settled on YuE2: of all the open models, it is the best value and the most refined.
He did not knock the Studio together just to have something that runs. He built it his own way, because his creative work is his own too, refined and one of a kind: his translations, his interlinear texts and much more. He fit into it as much as he could, polished the interface as far as he could, and made creating in it not poking and clicking among crutches and potholes, but as productive as it can be.
That is the whole story. Now the Studio is yours as well.
Виктор Журомский, автор Ruach Studio, публикует её не ради хайпа. Он делал её для себя. После более чем полугода мучений с Suno на платных тарифах и поисков достойной модели (ACE-Step, MiniMax и другие) он взялся построить собственную аудиостудию, на своей машине. Выбор пал на YuE2: из всех открытых моделей она самая рентабельная и самая изысканная.
Студию он делал не тяп-ляп, лишь бы работало, а в своём стиле, потому что и творчество у него своё, изысканное и неповторимое: собственные переводы, подстрочники и многое другое. Он постарался вместить в неё максимум, отполировать интерфейс до блеска и сделать творчество в Студии не тыканьем и кликаньем среди костылей и ям, а по-настоящему продуктивным.
Вот и вся история. Теперь эта Студия и ваша.
Віктор Журомський, автор Ruach Studio, публікує її не заради хайпу. Він творив її для себе. Після понад пів року мук із Suno на платних тарифах і пошуків гідної моделі (ACE-Step, MiniMax та інші) він узявся збудувати власну аудіостудію, на своїй машині. Вибір упав на YuE2: з усіх відкритих моделей вона найвигідніша й найвишуканіша.
Студію він творив не абияк, аби лиш працювало, а у своєму стилі, бо й творчість у нього своя, вишукана й неповторна: власні переклади, підрядники та багато іншого. Він намагався вмістити в неї максимум, відшліфувати інтерфейс до блиску, щоб творчість у Студії була не тицянням і клацанням серед милиць і ям, а справді продуктивною.
Ось і вся історія. Тепер ця Студія і ваша.
Віктар Журомскі, аўтар Ruach Studio, публікуе яе не дзеля хайпу. Ён тварыў яе для сябе. Пасля больш як паўгода пакут з Suno на платных тарыфах і пошукаў годнай мадэлі (ACE-Step, MiniMax і іншыя) ён узяўся пабудаваць уласную аўдыястудыю, на сваёй машыне. Выбар упаў на YuE2: з усіх адкрытых мадэляў яна самая выгадная і самая вытанчаная.
Студыю ён тварыў не абы-як, абы працавала, а ў сваім стылі, бо і творчасць у яго свая, вытанчаная і непаўторная: уласныя пераклады, падрадкоўнікі і шмат іншага. Ён стараўся змясціць у яе максімум, адшліфаваць інтэрфейс да бляску, каб творчасць у Студыі была не тыцканнем і клікамі сярод мыліц і ям, а сапраўды прадуктыўнай.
Вось і ўся гісторыя. Цяпер гэтая Студыя і ваша.
Ο Viktor Zhuromskyy, ο δημιουργός του Ruach Studio, δεν το δημοσιεύει για εντυπωσιασμό. Το έφτιαξε για τον εαυτό του. Ύστερα από περισσότερους από έξι μήνες ταλαιπωρίας με το Suno σε πληρωμένα πακέτα, και αναζήτησης ενός μοντέλου που να αξίζει (ACE-Step, MiniMax και άλλα), αποφάσισε να φτιάξει ένα δικό του στούντιο ήχου, στο δικό του μηχάνημα. Κατέληξε στο YuE2: από όλα τα ανοιχτά μοντέλα είναι το πιο συμφέρον και το πιο εκλεπτυσμένο.
Δεν έστησε το Στούντιο πρόχειρα, απλώς για να λειτουργεί. Το έφτιαξε με το δικό του ύφος, γιατί και η δημιουργία του είναι δική του, εκλεπτυσμένη και μοναδική: οι μεταφράσεις του, τα διάστιχα κείμενά του και πολλά άλλα. Προσπάθησε να χωρέσει σε αυτό όσο περισσότερα γινόταν, να γυαλίσει το περιβάλλον ως την τελευταία λεπτομέρεια και να κάνει τη δημιουργία στο Στούντιο όχι άσκοπα κλικ ανάμεσα σε δεκανίκια και λακκούβες, αλλά κάτι πραγματικά παραγωγικό.
Αυτή είναι όλη η ιστορία. Τώρα το Στούντιο είναι και δικό σας.
Viktor Zhuromskyy, el autor de Ruach Studio, no lo publica para llamar la atención. Lo hizo para sí mismo. Tras más de medio año de sufrir con Suno en planes de pago y de buscar un modelo que mereciera la pena (ACE-Step, MiniMax y otros), se propuso construir su propio estudio de audio, en su propia máquina. Se quedó con YuE2: de todos los modelos abiertos, es el más rentable y el más refinado.
No montó el Estudio de cualquier manera, solo para que funcionara. Lo hizo a su estilo, porque su creación también es suya, refinada e irrepetible: sus traducciones, sus textos interlineales y mucho más. Procuró meter en él todo lo posible, pulir la interfaz hasta el último detalle y hacer que crear en el Estudio no sea dar clics a ciegas entre muletas y baches, sino algo de verdad productivo.
Esa es toda la historia. Ahora el Estudio también es tuyo.
Viktor Zhuromskyy, l'autore di Ruach Studio, non lo pubblica per fare clamore. Lo ha costruito per sé. Dopo più di sei mesi di tormenti con Suno sui piani a pagamento, e di ricerche di un modello all'altezza (ACE-Step, MiniMax e altri), ha deciso di crearsi uno studio audio tutto suo, sulla sua macchina. La scelta è caduta su YuE2: fra tutti i modelli aperti è il più conveniente e il più raffinato.
Non ha messo insieme lo Studio alla buona, giusto perché funzionasse. Lo ha fatto a modo suo, perché anche la sua opera creativa è sua, raffinata e irripetibile: le sue traduzioni, i suoi testi interlineari e molto altro. Ha cercato di farci stare il massimo, di rifinire l'interfaccia fino all'ultimo dettaglio e di rendere il creare nello Studio non un cliccare a vuoto tra stampelle e buche, ma qualcosa di davvero produttivo.
Questa è tutta la storia. Ora lo Studio è anche tuo.
Viktor Zhuromskyy, l'auteur de Ruach Studio, ne le publie pas pour faire parler de lui. Il l'a fait pour lui-même. Après plus de six mois à se débattre avec Suno sur des formules payantes, et à chercher un modèle qui en vaille la peine (ACE-Step, MiniMax et d'autres), il s'est mis à construire son propre studio audio, sur sa propre machine. Son choix s'est arrêté sur YuE2 : de tous les modèles ouverts, c'est le plus rentable et le plus raffiné.
Il n'a pas bricolé le Studio à la va-vite, juste pour avoir quelque chose qui tourne. Il l'a fait à sa manière, parce que sa création est la sienne, raffinée et inimitable : ses traductions, ses textes interlinéaires et bien plus encore. Il y a fait entrer tout ce qu'il a pu, a poli l'interface aussi loin qu'il a pu, et a fait de la création dans le Studio non pas un tâtonnement de clics entre béquilles et nids-de-poule, mais quelque chose de vraiment productif.
Voilà toute l'histoire. Maintenant, le Studio est aussi à toi.
Viktor Zhuromskyy, o autor do Ruach Studio, não o publica pelo hype. Ele o fez para si mesmo. Depois de mais de meio ano sofrendo com o Suno em planos pagos, e procurando um modelo que valesse a pena (ACE-Step, MiniMax e outros), ele decidiu construir o seu próprio estúdio de áudio, na sua própria máquina. A escolha caiu no YuE2: de todos os modelos abertos, é o de melhor custo-benefício e o mais refinado.
Ele não montou o Estúdio de qualquer jeito, só para ter algo que rodasse. Fez do seu jeito, porque a criação dele é dele, refinada e inimitável: as suas traduções, os seus textos interlineares e muito mais. Colocou nele o máximo que pôde, poliu a interface até onde pôde e fez da criação no Estúdio não um cutucar e clicar entre muletas e buracos, mas algo de fato produtivo.
Essa é a história toda. Agora o Estúdio também é seu.
Viktor Zhuromskyy, der Autor von Ruach Studio, veröffentlicht es nicht für den Hype. Er hat es für sich selbst gemacht. Nach mehr als einem halben Jahr Mühe mit Suno in bezahlten Tarifen und der Suche nach einem Modell, mit dem sich arbeiten lässt (ACE-Step, MiniMax und andere), machte er sich daran, ein eigenes Audiostudio zu bauen, auf seiner eigenen Maschine. Die Wahl fiel auf YuE2: von allen offenen Modellen das lohnendste und das ausgefeilteste.
Er hat das Studio nicht zusammengeschustert, nur damit irgendetwas läuft. Er hat es auf seine Art gebaut, denn auch sein Schaffen ist sein eigenes, erlesen und unverwechselbar: seine Übersetzungen, seine Interlinearübersetzungen und vieles mehr. Er hat so viel hineingepackt, wie er konnte, die Oberfläche poliert, so weit er konnte, und das Schaffen darin nicht zu einem Stochern und Klicken zwischen Krücken und Schlaglöchern gemacht, sondern zu etwas wirklich Produktivem.
Das ist die ganze Geschichte. Jetzt ist das Studio auch deins.
Ruach Studio の作者 Viktor Zhuromskyy は、話題づくりのためにこれを公開しているのではありません。自分のために作ったのです。有料プランで Suno と半年以上格闘し、取り組むに値するモデルを探し回った末に(ACE-Step、MiniMax ほか)、彼は自分のマシンの上に自分だけのオーディオスタジオを作ろうと決めました。選んだのは YuE2 でした。オープンなモデルの中で、最も割に合い、最も洗練されているからです。
彼は、とりあえず動けばいいという作り方はしませんでした。自分の流儀で作りました。彼の創作は彼自身のもの、洗練された唯一無二のものだからです:自身の翻訳、行間対訳のテキスト、そのほか多くのもの。詰め込めるだけ詰め込み、磨けるだけインターフェースを磨き、スタジオでの創作を、松葉杖と穴ぼこの間を手探りでクリックすることではなく、本当に生産的なものにしました。
話はこれで全部です。これからは、このスタジオはあなたのものでもあります。
Ruach Studio 的作者 Viktor Zhuromskyy 发布它并不是为了炒作。他是为自己做的。在付费套餐上和 Suno 折腾了半年多,又四处寻找值得投入的模型(ACE-Step、MiniMax 等)之后,他决定在自己的机器上搭建一个属于自己的音频工作室。他选定了 YuE2:在所有开放模型中,它最划算,也最精致。
他没有随便拼凑一个能跑就行的工作室,而是按自己的方式来做,因为他的创作也是他自己的,精致而独一无二:他的译本、他的逐行对照文本,还有许多别的。他尽可能多地装进其中,把界面打磨到力所能及的极致,让在这个工作室里的创作不再是在拐杖和坑洼之间胡乱点击,而是真正高效的事。
故事就是这样。现在,这个工作室也是你的了。